ReSI-Recursive Safety Improvementtoward Resistant and Resilient AI
让 AI 自动组织“找安全漏洞、尝试修复、检验效果”的循环,逐轮把模型训练得更安全。
一次安全训练很难覆盖所有攻击。新攻击会不断出现,修复某些漏洞又可能让模型能力下降,或者变得过度谨慎,连正常问题也拒绝回答。因此,作者希望持续提高安全性,同时保留模型的正常能力。
Method
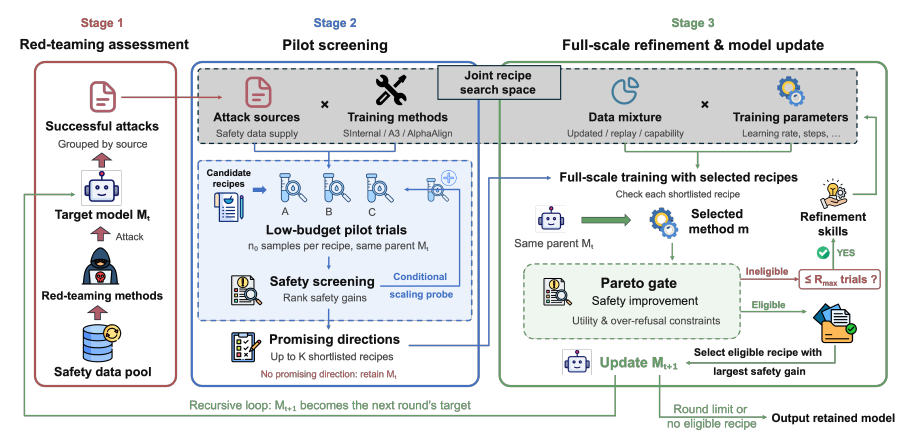
每轮分为三步:
- 找漏洞:用多种红队攻击方法攻击当前模型,收集成功诱导出不安全回答的样本。
- 小规模试方案:尝试不同攻击数据与训练方法的组合,包括监督微调和安全强化学习,先用较低成本筛选。
- 正式训练并验收:进一步调整数据比例、学习率等配置。只有安全性提高、指令遵循和正常回答能力满足保留要求的版本,才能进入下一轮。
这里一个关键设计是:训练数据可以混入以前的安全样本和正常任务样本,帮助模型避免忘记旧防御和通用能力。
3. “递归”体现在哪里?
修复后的模型会成为下一轮的攻击对象:攻击新版本,再针对它剩余的漏洞寻找训练方案。但搜索流程和评估规则保持固定,并不是模型无限自主改写整个系统。实验中,各模型接受了 1–3 轮更新。
Experiment
4. 实验说明了什么?
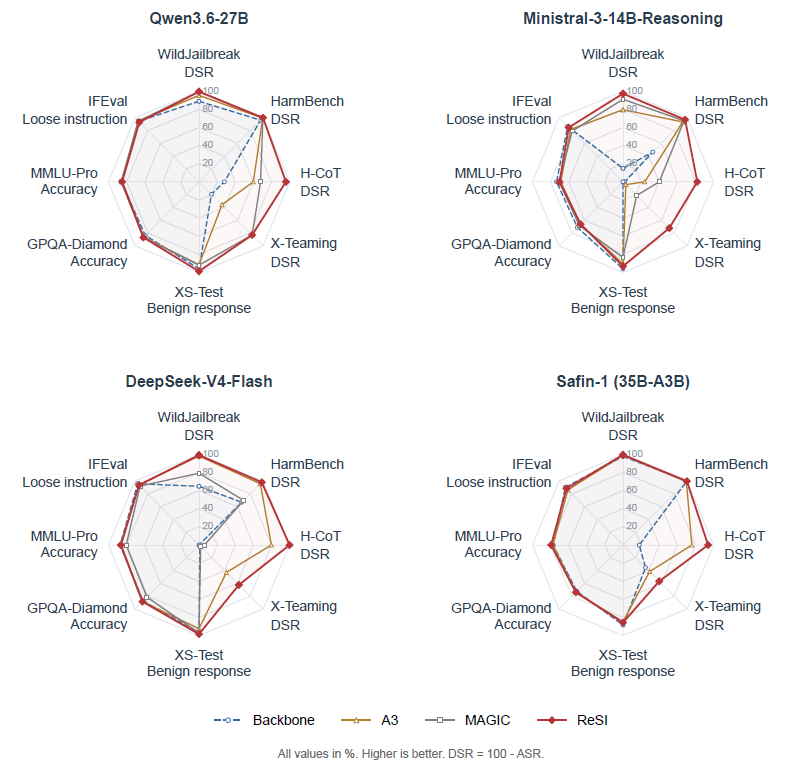
作者在四个模型上测试。论文报告,在训练时未使用的多轮攻击 X-Teaming 上,平均攻击成功率从 86.01% 降至 31.45%;同时检查知识、推理、指令遵循以及正常请求被误拒绝的情况。结果支持:改进不只局限于训练中见过的攻击,但仍然存在被攻破的风险。
我的理解是,它的主要贡献在于自动搜索“怎么修复最合适”,再通过严格验收持续迭代。结合你做的“检测攻击+安全 agent 修复文本”,它提供的启发是:可以把攻击发现、修复策略选择和效果验证连接成持续反馈循环。不过,这篇主要修复的是模型参数,你的方案主要修复的是输入文本,两者作用位置不同。