DOVER- INTERVENTION-DRIVEN AUTO DEBUGGINGFOR LLM MULTI-AGENT SYSTEMS
time: 2026/10/03
Abstract
基于大语言模型(LLM)的多智能体系统难以调试,因为故障往往产生于冗长且包含多个分支的交互轨迹。目前的主流做法是利用 LLM 根据日志定位故障,将错误归因于某个特定的智能体和执行步骤。然而,这种范式存在两个主要局限:(1)仅依赖日志的调试缺乏验证,得到的只是未经检验的假设;(2)将故障归因于单个步骤或单个智能体,往往并没有明确且唯一的答案,因为我们发现,多种不同的干预都可以独立修复同一个失败任务。
针对第一个局限,我们提出了 DoVer,一个由干预驱动的调试框架。它在生成故障假设的基础上,通过有针对性的干预(例如编辑消息、修改计划)进行主动验证。针对第二个局限,我们不再以归因准确率作为评估重点,而是衡量系统是否解决了故障,或者是否朝着任务成功取得了可量化的进展,从而体现一种更注重实际结果的调试视角。
在 Magnetic-One 智能体框架中,基于 GAIA 和 AssistantBench 构建的数据集上,DoVer 将 18%–28% 的失败尝试转化为成功,实现了最高 16% 的里程碑进度提升,并验证或否定了 30%–60% 的故障假设。在另一个数据集 GSMPlus 和智能体框架 AG2 上,DoVer 同样有效,成功修复了 49% 的失败尝试。
这些结果表明,干预是提高智能体系统可靠性的一种实用机制,也为开发更稳健、更具可扩展性的 LLM 多智能体系统调试方法提供了新的研究机会。项目网站和代码将发布于:https://aka.ms/DoVer。
Background
1. 它要解决什么问题?
这里的 failure 主要是 semantic failure:系统正常运行,没有 crash,但最终答案错误,或任务没有完成。
例如:
- Researcher 找错了资料;
- Planner 基于错误资料制定计划;
- Executor 按计划执行;
- 最终得到一个看起来合理、实际错误的结果。
传统方法是把完整 execution log 交给一个 LLM,让它指出:
哪个 agent、在哪一步,造成了失败?
这叫 failure attribution,即故障归因。
作者认为这种做法有两个问题。
第一,诊断没有经过验证。
LLM 说“第 15 步的计划有问题”,只是一个 hypothesis。没有实际修改和执行,就不知道这个判断是否有用。
第二,失败未必能唯一归因到一个位置。
同一个任务可能尝试过好几条路线,每条路线都有自己的错误;修改不同位置,也可能分别修好任务。
因此,“唯一正确的错误步骤”这个 ground truth 本身可能不可靠。
2. 为什么作者认为归因标签存在歧义?
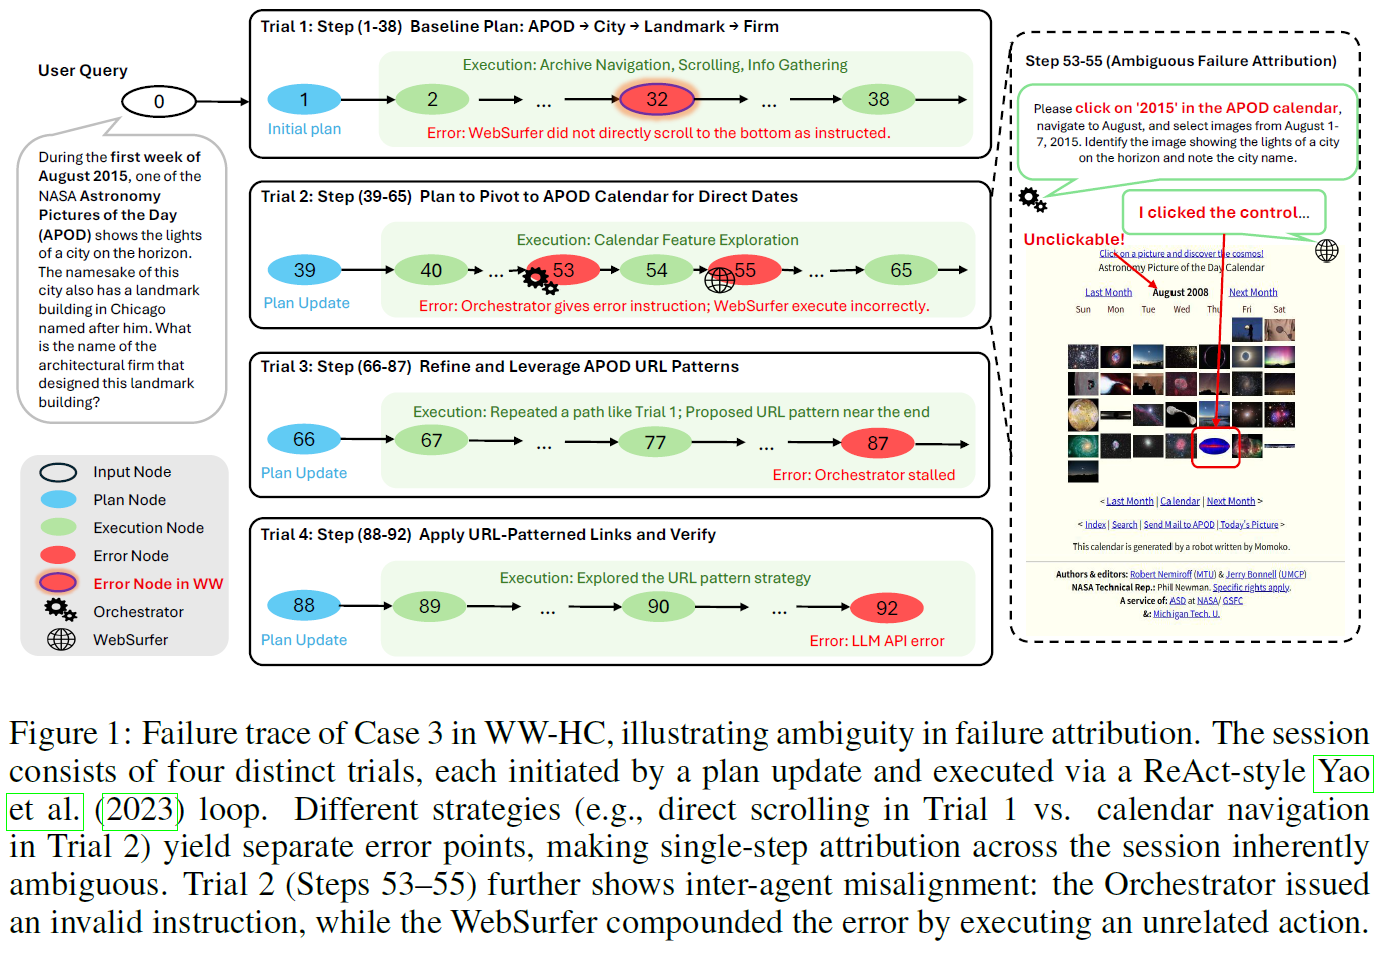
论文第 3 节分析了已有的 Who&When(WW) 故障归因数据。
他们先发现,给日志加明确的 step index,再提醒模型遵循标注规则,就能把一个设置下 GPT-4o 的步骤归因准确率从 6% 提升到 24%。这说明部分困难来自输入和提示设计。
但更重要的是,他们重新检查 WW 中的 29 个 GAIA 案例,认为其中 14 个存在标签不确定性。这属于作者的复核判断。
主要有三种来源:
| 不确定性 | 为什么很难指定唯一错误位置 |
|---|---|
| 一个 session 包含多次尝试 | 不同策略各自有不同失败点 |
| 多 agent 协作失配 | 指令有问题,执行者也可能处理不当 |
| 标注者理解不同 | 对什么算“决定性错误”判断不一致 |
例如,Orchestrator 要求 WebSurfer 点击一个不存在的按钮;WebSurfer 没有报告问题,而是点击了无关按钮。
究竟该归因于 错误指令,还是 错误执行?二者都可以成为修复入口。
所以作者把问题从:
能不能猜中人工指定的错误步骤?
转变为:
对这个位置进行干预,是否能改善实际结果?
这是论文最重要的研究视角变化。
Method
DoVer
1. Trial Segmentation:执行轨迹分段
DoVer 将完整的执行日志(session log)按照 planning/replanning 的位置划分为多个 trials。
- Session:从用户提出任务到系统结束的完整执行过程。
- Trial:从一次 planning/replanning 开始,到下一次重新规划之前的连续尝试。
例如,一个任务先尝试网页搜索,失败后改查网站目录,再失败后尝试直接构造 URL,可以划分成三个 trials。
DoVer 使用 LLM 识别规划相关步骤,并据此切分日志。这样可以缩短诊断上下文,为不同尝试分别生成故障假设和干预方案。
Trial 是按计划变化划分的连续执行片段,不是依赖图中的分支。
2. Failure Attribution:生成故障假设
对于每个 trial,DoVer 使用 LLM 分析日志,提出一个故障归因假设,包含:
- 怀疑出错的 agent;
- 怀疑出错的 step;
- 对故障原因的自然语言解释。
例如:
WebSurfer 未能找到目标页面,是因为 Orchestrator 的导航指令依赖一个不存在的控件。
这一阶段的输出只是 hypothesis,后续需要通过实际干预验证。
3. Intervention Generation:生成干预方案
DoVer 将故障假设转化为具体、可执行的文本修改。实际方法主要在 message-passing layer 修改 Orchestrator 的消息,包含两类干预:
| 干预类型 | 具体操作 |
|---|---|
| Modified Instructions to Sub-Agents | 澄清指令、纠正参数、补充缺失上下文 |
| Plan Updates | 调整计划顺序、拆分步骤、替换失败路线 |
例如,将“点击年份按钮”改为:
根据目标日期构造页面 URL,直接打开页面并检查内容。
这些干预通过修改消息和计划影响 agent 行为,不直接修改 sub-agent 代码或增加工具。因此,由工具能力缺失导致的故障,可能无法仅靠文本干预修复。
4. Intervention Execution:恢复执行并验证
DoVer 保留干预点之前的执行内容,加载对应 checkpoint,应用修改,然后从干预位置恢复执行。
具体流程:
- 加载干预位置对应的 checkpoint;
- 替换有问题的消息或计划;
- 从修改位置继续执行,生成新的执行轨迹;
- 比较原始轨迹与新轨迹的任务成功情况和里程碑进度。
每个干预重复执行三次,以减轻 LLM 执行随机性的影响。
这里需要保存的不只是聊天日志,还包括恢复运行所需的状态,例如:
- agent 的历史上下文;
- Orchestrator 的计划与运行状态;
- 浏览器等工具的相关状态。
核心逻辑:提出故障假设 → 生成针对性修改 → 恢复执行 → 根据实际结果验证修改是否有效。