MemGPT_Towards LLMs as Operating Systems
Abstract
今天 agent 记忆与上下文管理架构的一个早期代表。
大型语言模型(LLM)推动了人工智能的变革,但其有限的上下文窗口限制了它们在长时间对话和文档分析等任务中的应用。为了在有限的上下文窗口之外利用更多信息,我们提出了虚拟上下文管理技术。
该技术受到传统操作系统分层内存机制的启发:操作系统通过在物理内存与磁盘之间换入换出数据,营造出更大虚拟内存的效果。
基于这一技术,我们提出了 MemGPT(MemoryGPT),一个能够智能管理不同存储层级的系统,使 LLM 在有限的上下文窗口内有效利用更广泛的上下文。我们在两个受上下文窗口限制尤为明显的领域评估了这一受操作系统启发的设计:在文档分析中,MemGPT 能够分析远超底层 LLM 上下文窗口长度的大型文档;在多会话聊天中,MemGPT 能够构建具有长期记忆、反思能力,并能在与用户的长期互动中动态演进的对话智能体。我们公开了 MemGPT 的代码及实验数据,地址为 https://research.memgpt.ai。
Background
这篇 MemGPT 的核心很好理解:把 LLM 的上下文窗口当成有限的“内存”,把外部数据库当成“硬盘”,让 LLM 通过工具调用,主动决定记住什么、查找什么,以及什么时候继续查。 它主要是一个系统设计,不是训练出一个上下文更长的新模型。
1. 它想解决什么问题?
普通 LLM 每次只能看到上下文窗口里的内容。对话越来越长,或者文档越来越多,就会遇到两个问题:
- 放不下: 早期对话或部分文档必须被移出窗口。
- 压缩会丢信息: 如果只保留摘要,一些当时看起来不重要、后来却需要的细节可能消失。
例如,你一个月前提过“我和朋友第一次见面是在某个游乐园”,今天再次聊到那里。只保留近期消息的助手不知道这层关系;只保留摘要,也未必留下了这个细节。
作者的思路是:不必让模型一次看到所有历史,只要保留历史,并在需要时把相关部分调进来。
2. 架构:窗口里放什么,窗口外存什么?
论文 Figure 3 是整篇最关键的图,可以拆成下面这张表:
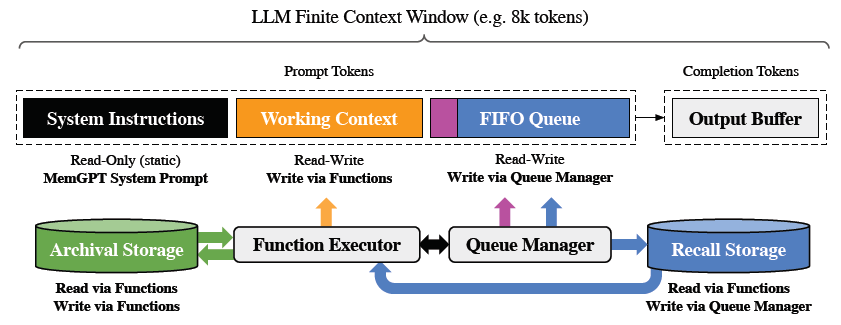
| 位置 | 组件 | 存什么 | 如何更新 |
|---|---|---|---|
| 上下文内 | System instructions | 系统规则、记忆管理说明、工具定义 | 固定,只读 |
| 上下文内 | Working context | 用户关键事实、偏好、当前重要信息 | LLM 通过工具修改 |
| 上下文内 | FIFO queue | 最近消息、工具调用结果、旧消息的递归摘要 | 系统队列管理器维护 |
| 上下文外 | Recall storage | 完整的历史消息记录 | 系统自动记录,LLM 可以搜索 |
| 上下文外 | Archival storage | 文档、归档知识、主动保存的信息 | LLM 可以搜索和写入 |
这里要分清三个概念:
- Working context:随时摆在眼前的重要笔记。
- Recall storage:可以翻查的完整聊天记录。
- Archival storage:可以检索的资料库。
外部存着的信息,模型不会自动知道;必须先检索回来,放进当前上下文,才能用于这次推理。
所以这里的“记忆”主要是文本和数据库中的持久信息,不是修改模型参数。
3. 它具体怎么运行?
用一个对话例子串起来,下面的工具调用是示意。
① 用户告诉它一件重要的事
“我的生日是 2 月 7 日。”
模型可以调用:
working_context.append("用户生日是 2 月 7 日")
这样,即使原始消息后来退出近期对话窗口,生日仍留在常驻笔记里。
② 用户更新了事实
“我已经和 James 分手了。”
模型可以把:
男朋友叫 James
替换为:
前男友叫 James
这说明它支持的并非只有“新增记忆”,还有修改已经过时的记忆。
③ 用户问起没有常驻保存的细节
“我们之前说过第一次见面在哪儿,你还记得吗?”
模型可以搜索历史记录,把相关旧消息调回窗口,再回答。
因此,它把两种需求分开处理了:经常需要的重要信息常驻;偶尔需要的细节按需检索。
4. 窗口快满时,谁负责处理?
这里是 LLM 决策和系统机制配合,并非全部交给模型自由发挥。
论文给出的示例策略是:
- 上下文达到约 70%,系统插入“记忆压力”警告。
- LLM 可以趁此把重要内容写入 Working context 或 Archival storage。
- 达到清理阈值后,系统移除一部分旧消息,并更新递归摘要。
- 被移出的原始消息仍保存在 Recall storage,之后可以重新搜索。
注意,70% 和清理比例是示例配置,不是方法成立必须满足的固定数值。
你可以理解为:系统负责控制容量,LLM 负责判断哪些内容值得保存和调取。
5. 为什么还需要 heartbeat?
这是论文除了记忆分层之外,另一个很关键的设计:让模型可以连续执行多步操作,再把控制权交回用户。
例如,查询一个嵌套关系:
A → B
B → C
C → 最终答案
一次检索只能找到下一跳,所以模型需要:
- 查 A,得到 B。
- 根据 B 再查,得到 C。
- 继续查,直到确认终点。
- 最后回答用户。
MemGPT 的工具调用可以携带:
request_heartbeat = true
意思是:工具执行完后,立即再调用一次 LLM,让它根据结果继续处理。
如果不请求 heartbeat,系统就可以暂停,等待新的外部事件。
所以它不只是“给 LLM 接一个数据库”,还设计了一个循环,让 LLM 能自主组织多次检索、记忆修改和最终回复。
6. 和普通 RAG 有什么区别?
如果拿“一次检索,再生成答案”的基础 RAG 来比较:
| 维度 | 基础 RAG | MemGPT |
|---|---|---|
| 检索时机 | 通常由预设流程触发 | LLM 可以主动决定 |
| 检索次数 | 通常一次 | 可以连续多次、翻页、改查询 |
| 信息写入 | 常见设置以读取为主 | 可以主动保存和修改记忆 |
| 长期对话 | 需要另外设计 | 明确设计了历史记录和常驻记忆 |
| 控制流程 | 流程通常预先确定 | LLM 可以决定继续执行或交回控制权 |
MemGPT 可以看成把检索、可写记忆和执行循环组合起来的 agent 系统。 更复杂的 RAG 系统也可以实现这些能力,两者并不是互斥概念。
7. 实验说明了什么?
论文主要测试两类场景。
第一类:长期对话。
在 Deep Memory Retrieval 任务中,模型需要回答过去几次对话里提到的细节。
| 基础模型 | 基线准确率 | 加入 MemGPT |
|---|---|---|
| GPT-3.5 Turbo | 38.7% | 66.9% |
| GPT-4 | 32.1% | 92.5% |
| GPT-4 Turbo | 35.3% | 93.4% |
这里有一个理解结果的重要前提:基线看到的是历史对话的有损摘要;MemGPT 可以搜索完整历史。 因此,这组实验主要证明“保存原始记录并按需调取”比“只保留摘要”更能恢复细节。
论文还测试了根据过去的用户信息主动开启话题,但使用的是相似度指标,不能直接等同于真实用户觉得更有趣。
第二类:文档问答和多跳查询。
- 文档问答: 将大量 Wikipedia 文档存入外部数据库,模型通过搜索和翻页寻找答案,避免把所有文档一次塞进窗口。
- 嵌套键值查询: 根据上一轮查到的值继续查下一跳。GPT-4 版本的 MemGPT 能较稳定地完成更深的查询,而直接回答的基线随嵌套加深明显下降。
不过,论文也观察到:模型可能提前停止检索。 GPT-3.5 的工具调用能力较弱,效果明显差一些。说明有了记忆工具之后,模型是否会正确使用工具仍然关键。
8. 这篇论文真正的贡献怎么概括?
我觉得可以归纳成三个点:
- 分层记忆: 将有限窗口、常驻笔记、历史记录和归档资料组织成不同层级。
- 自主管理: 让 LLM 通过函数调用选择保存、修改和检索信息。
- 执行控制: 通过事件和 heartbeat 支持连续多步处理。
标题里的“LLMs as Operating Systems”主要是一种架构类比:它借鉴了内存分层、换入换出和事件驱动,并不是实现了一个完整操作系统。
读这篇时最值得抓住的是:上下文长度限定了模型一次能看到多少信息;MemGPT 通过外部存储和多轮调用,扩大了模型在整个任务过程中能够访问的信息范围。 代价则是额外的检索、token 和延迟,而且“能访问很多信息”仍然取决于模型能否找到正确的信息。