Lesson6-Edge AI II-Heterogeneous Execution,Energy, and Adaptive Serving
1. 从“模型放得下”到“资源用得好”(p3–5)
这一部分提出三个决策:
- Execution: 一次计算交给 CPU、GPU 还是 NPU?能不能拆开合作?
- Energy: 硬件应该运行在多高的频率?
- Adaptation: 工作负载或设备状态变化后,策略要怎样调整?
为什么不能直接选择 TOPS 最高的芯片?
因为 peak TOPS 描述的是特定条件下的峰值计算能力,实际推理还受整个执行过程限制。
例如,一个 NPU 的矩阵计算很快,但实际模型可能遇到:
- 某些 operator 或 precision 不受支持;
- tensor shape 不适合硬件;
- 编译计算图需要时间;
- GPU 和 NPU 之间需要同步;
- 多个处理器争用 shared DRAM。
因此,你应该关注的是 end-to-end latency,而不是单独看芯片宣传的算力。
HeteroInfer——怎样让 GPU 和 NPU 一起干活?(p6–16)
这一部分是前半节课的重点。它的基本思路是:
先测量不同形状的算子在 GPU、NPU 上的实际表现,再决定计算怎样划分。
在这里,CPU 主要负责控制和调度,GPU、NPU 承担主要张量计算。
① NPU 为什么对 tensor shape 很敏感?(p7–9)
PPT 用 systolic array,脉动阵列解释 NPU 的特点。你可以把它理解为:一组有固定排列的计算单元,让数据在单元之间流动并反复利用,从而减少重复读取。
这种结构计算效率高,但也带来三个特点:
| 特点 | 含义 | 直觉 |
|---|---|---|
| Stage-sensitive | 输入尺寸增加,延迟可能阶梯式增长 | 硬件按固定大小的块处理 |
| Order-sensitive | 数学上等价的乘法表达方式,执行成本可能不同 | 数据进入阵列的方式影响复用 |
| Shape-sensitive | 相同计算量、不同长宽比例,性能可能不同 | 权重大小、数据流和阵列利用率不同 |
比如,p8 展示的硬件按 32×32 阵列执行。在相关维度不足一个块时,仍可能占用完整块,因此尺寸略微变小,时间未必变短;跨过块边界,时间却可能突然增加。
p9 的重点则是:FLOP count 相同,不足以说明 latency 相同。 数学上等价的转置或乘法组织方式,可能改变权重复用和内存访问。
这些是课件所研究平台上的实测特点,迁移到其他 NPU 时需要重新测量。
② 为什么 GPU 和 NPU 同时运行可能更快?(p10–11)
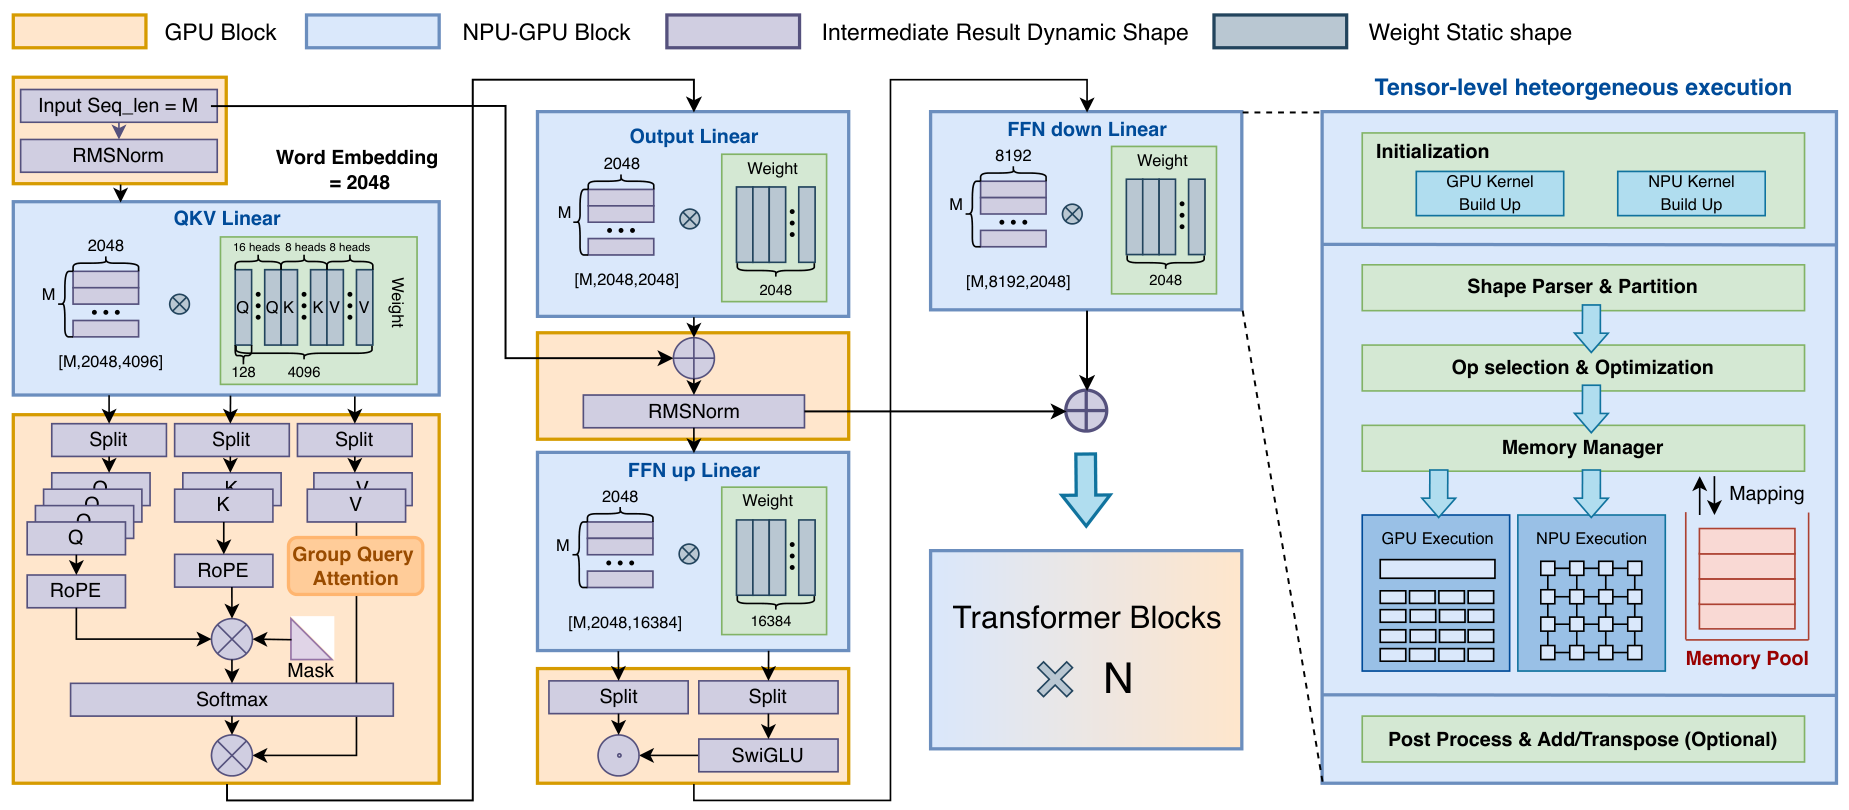
除了增加计算资源,还可能提高 memory bandwidth utilization。
p10 的实验显示,一个处理器单独运行时未必能吃满 SoC 的内存带宽;GPU 和 NPU 并行运行,可以利用更多带宽。不过,它们也可能互相争抢内存资源。
这里要区分两种策略:
- Layer/operator placement: 这个算子放 GPU,下一个算子放 NPU。
- Tensor partitioning: 同一个算子拆成两部分,GPU 和 NPU 同时计算。
对于第二种方式:
[ T_{\text{parallel}} \approx \max(T_{\text{GPU}},T_{\text{NPU}}) + T_{\text{coordination}}. ]
假设 GPU 的部分需要 2 ms,NPU 的部分需要 8 ms,那么最终仍然主要等 NPU。好的划分应该让两边尽量同时完成,同时控制拆分、合并和同步成本。
Layer Placement and Tensor Partitioning 拆分算子(p12–15)**
可以用一个 linear layer 来理解:
[ Y=XW, ]
其中 (X) 是 activation,(W) 是 weight。
**Weight-centric partitioning:按权重划分。
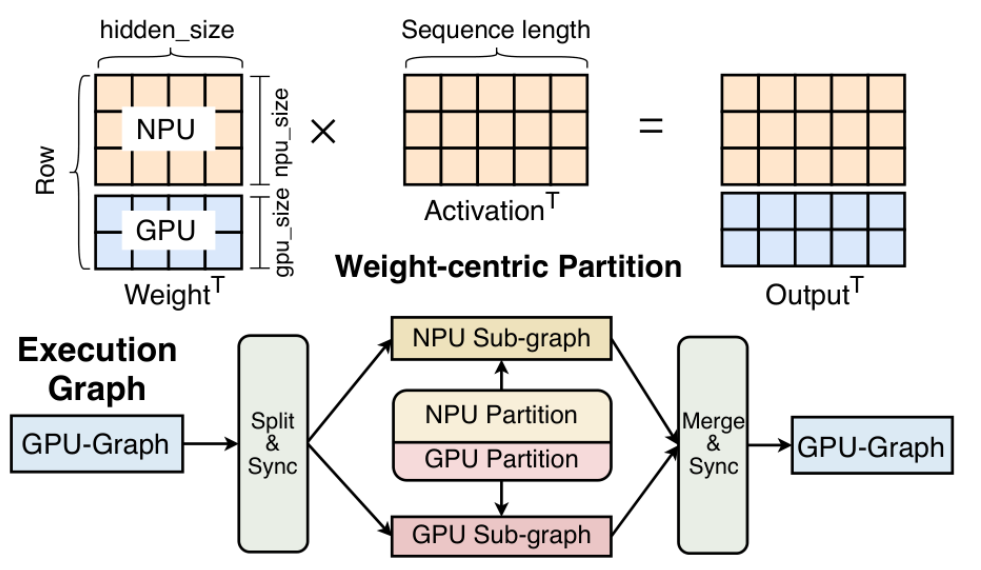 **
例如沿输出维度把权重拆成:
[ W=[W_{\text{NPU}},W_{\text{GPU}}], \qquad Y=[XW_{\text{NPU}},XW_{\text{GPU}}]. ]
两边读取输入,各自计算不同的输出部分,最后拼起来。
直觉是:同一批 token 的不同输出特征,交给不同处理器计算。
切多少给 NPU、多少给 GPU,要根据测出来的时间决定,而不是按照峰值 TOPS 分配。
Activation-centric partitioning:按输入划分。
这里主要解决 dynamic sequence length 与 static NPU graph 的矛盾。
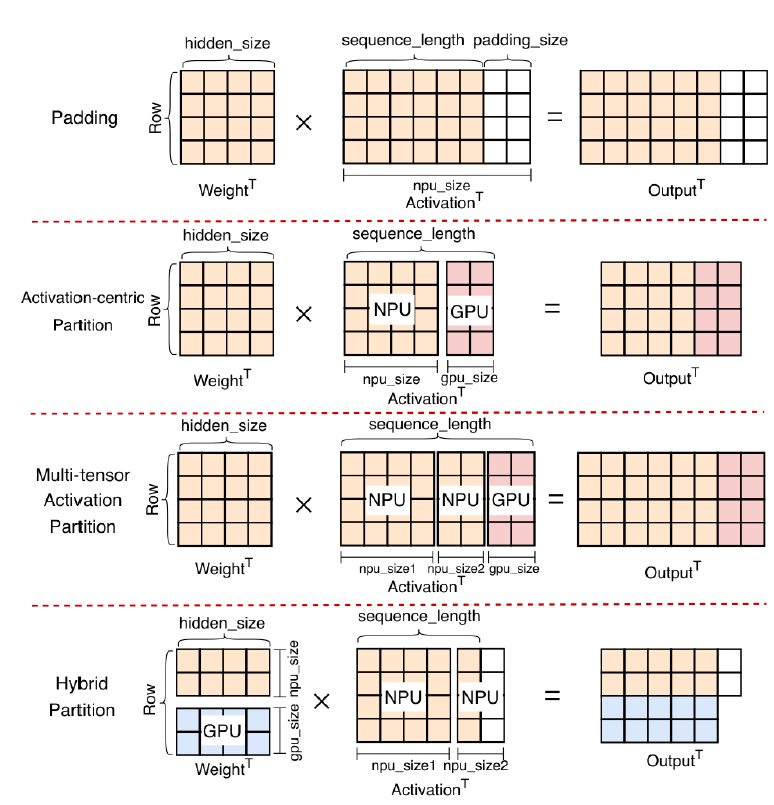
例如输入有 300 个 token,而已有 NPU 图适合 256 或 512 个 token:
- 全部 padding 到 512,会多计算 212 个位置;
- 可以让 NPU 处理标准的 256-token 块,GPU 处理剩余 44 个。
直觉是:NPU 负责适合静态图的整块计算,GPU 处理不规则的剩余部分。
这里拆的是相关算子的计算;后续 attention 仍然需要满足完整上下文的数据依赖。
Hybrid partitioning:两种划分结合。
既考虑 sequence length,也考虑两边的计算能力,通过同时划分 activation 和 weight 来平衡完成时间。
shared memory Synchronization(p16)
Shared memory 可以让两个处理器访问同一块数据,减少复制,但仍然必须保证:
生产者已经写完,消费者才能读取。
因此,共享地址空间不会自动消除 execution ordering 和 synchronization。
这在 decode 阶段尤其重要:单个 kernel 很短,同步时间可能占据很大比例。即使拆分后的计算更快,加上同步后也可能得不偿失。
AI on the Desktop/ Laptop / Phone(p17–19)
这三页是产品与应用讨论,主要让你把前面的概念放到实际使用场景里。
| 设备类型 | 课件希望你考虑的约束 |
|---|---|
| Desktop / mini PC | 内存容量、持续推理速度、软件支持 |
| Laptop | 响应速度、电池续航、CPU/GPU/NPU 支持情况 |
| Phone | 能耗、温度、可部署模型和接口 |
| Robot / physical device | 持续传感器输入、实时响应、长期功耗 |
这里有两个很重要的问题:
“模型放得下”是否意味着回答足够快?
不一定,放得下只是容量条件,生成速度还取决于计算、带宽和执行系统。
Always-on personal agent 应该放在哪里?
要结合任务来决定:持续运行是否耗电、是否需要低延迟、设备当前是否空闲,以及是否值得承担网络传输成本。
把硬件测量变成系统策略(p20–22)
p20 把 HeteroInfer 整理成三个模块:
| 模块 | 工作 |
|---|---|
| Profiler | 测量不同 shape 在 GPU、NPU 上的执行时间等信息 |
| Solver | 根据测量结果选择划分方案 |
| Runtime | 调度计算、管理内存、同步并合并结果 |
所以它不是简单地“两个芯片都用上”,而是一个 measurement-driven execution system。
p21 随后提醒你:看到性能提升,必须追问提升来自哪里。
可能的来源包括:
- 更合理的 tensor partitioning;
- 更低的 synchronization overhead;
- 更好的 kernel implementation。
比较时要固定模型、精度、输入长度和输出长度,否则加速比可能混入其他因素。
p22 对比两条路线:
| 系统 | PPT 强调的设计 |
|---|---|
| HeteroInfer | GPU–NPU 协同,按 tensor shape 划分计算 |
| PowerInfer-2 | CPU–NPU 协同,处理 flash-resident weights |
它们面对的硬件与内存层次不同,因此迁移到课程的 AMD、Intel 机器时,应该迁移测量和决策思路,具体划分比例需要重测。
Power vs Energy(p23–31)**
为什么“降频省电”没那么简单?这是后半节课最重要的部分。
① 先区分 Power 和 Energy(p23)
- Power,功率: 每秒消耗多少能量,单位 W。
- Energy,能耗: 完成整个任务消耗多少能量,单位 J。
[ E=P_{\text{avg}}\times T. ]
PPT 的例子:
| 设置 | 功率 | 时间 | 能耗 |
|---|---|---|---|
| A | 8 W | 5 s | 40 J |
| B | 5 W | 10 s | 50 J |
B 的瞬时功率更低,但运行时间更长,最终更费电。
所以评估本地 LLM 时,要看 energy per token / energy per task,同时保证任务质量可比。
② DVFS 是什么?(p24–26)
DVFS:Dynamic Voltage and Frequency Scaling,动态电压与频率调节。
可以把它理解为:根据工作负载调整硬件的运行档位。负责作出调整的控制策略叫 governor。
传统系统中,CPU、GPU、内存的 governor 往往分别决策,主要观察自己的局部指标,比如 utilization。
但 GPU 推理需要三个部分配合:
- CPU 提交任务,持续填充 GPU 工作队列;
- GPU 执行 kernels;
- 内存提供权重和 activation 数据。
每个组件各自做出看似合理的选择,合在一起却可能让整个任务变慢。
③ 为什么 CPU 和 GPU 会互相拖慢?(p27–28)
这是这一段最值得理解的因果关系。课件观察到,独立 governor 可能形成下面的循环:
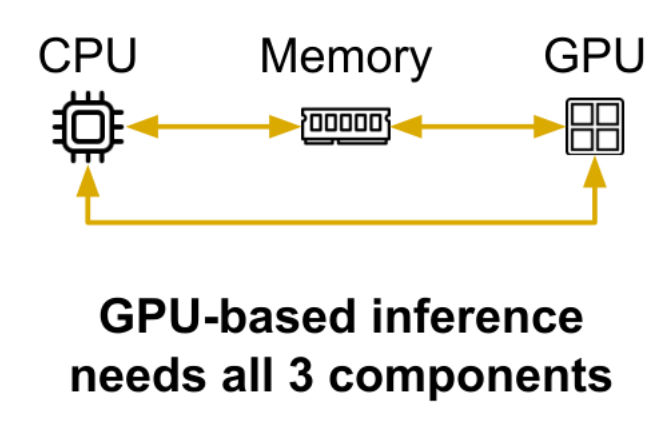
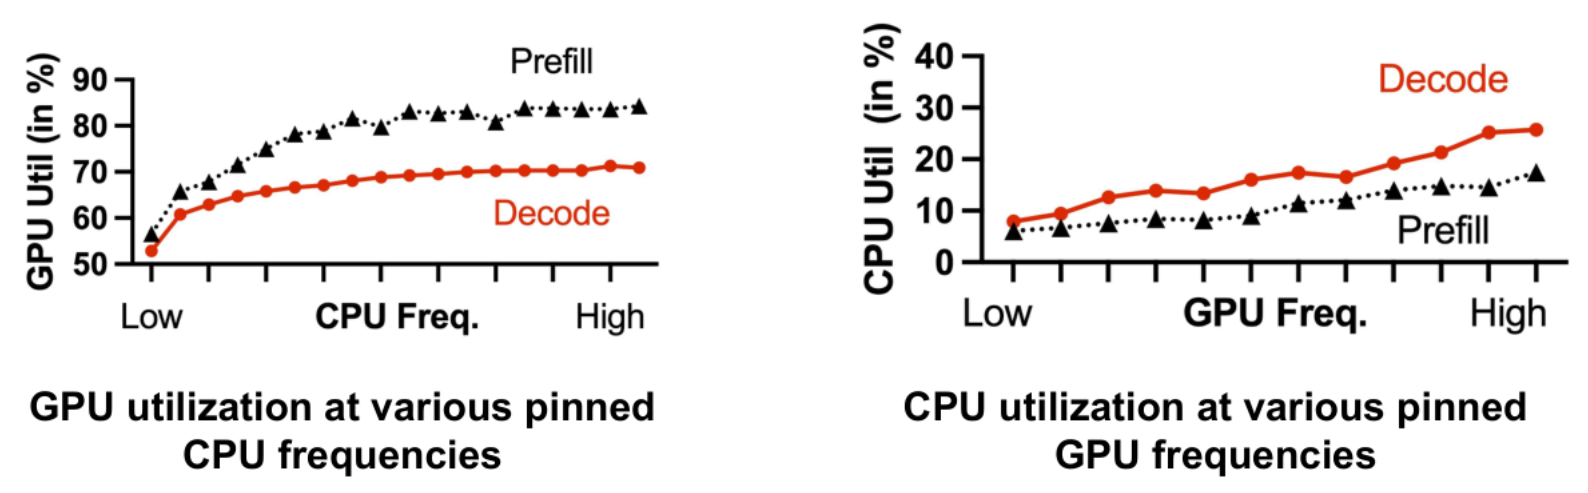
关键在于:低 utilization 可能意味着“在等另一个组件”,并不意味着当前组件可以放心降频。
例如,CPU 只在每次 kernel 提交时短暂工作,因此平均利用率不高。但这些短暂工作可能正好处于关键路径上。CPU 降频后,GPU 就更容易断粮。
这就是 CORE 强调统一协调的原因。
④ 为什么能耗与频率可能呈 U 形关系?(p29)
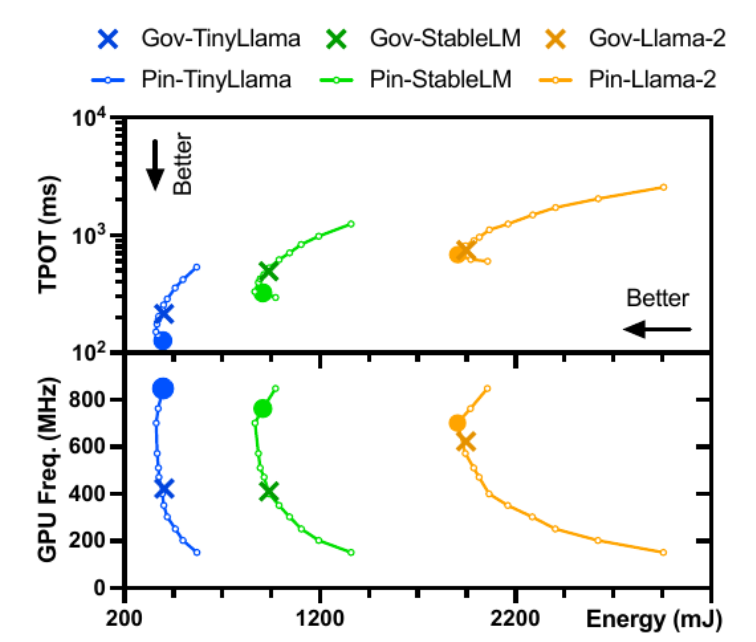
考虑三个区域:
| 频率范围 | 发生什么 | 对能耗的影响 |
|---|---|---|
| 太低 | 功率较低,但任务拖得很长 | CPU、内存和系统基础功耗持续累积 |
| 中间区域 | 加速收益能抵消功率增加 | 可能达到最低能耗 |
| 太高 | 功率继续增加,延迟下降有限 | 能耗可能重新上升 |
因此,最低频率、最快频率和最省能量的频率,可能是三个不同的点。
看 p29 的图时注意:图里的 Energy 在横轴,GPU frequency 在纵轴,不是常见的“横轴频率、纵轴能耗”。
⑤ CORE 怎么做?(p30–31)
CORE 先 offline profiling 不同频率组合,测出它们的 latency 和 energy,再根据目标选择设置。
它可以追求两类目标:
- 相同能量预算下,让推理更快。
- 满足同一个延迟目标时,减少能耗。
由于频率组合很多,p30 使用 “GPU first, CPU next” 的两步启发式搜索来缩小搜索成本,也区分不同 prefill 长度与 decode 阶段。
p31 的结果正是按上述两类目标报告,说明系统不必把“更快”和“更省电”始终当成完全冲突的选择:原来的控制策略可能本身就存在低效。
TurboInfer——等待时降频,工作前升回来(p32–34)**
CORE 主要关注推理阶段的资源设置,TurboInfer 则进一步关注更短时间尺度的 GPU stalls。
GPU 执行时可能在:
计算 kernel、等待、计算下一个 kernel、再次等待……
如果等待期间仍保持高频,就可能浪费功率。因此 TurboInfer 的思路是:
- 监测 GPU 进度,预测等待区间。
- 在等待期间降低频率。
- 在有效计算恢复前及时升频。
真正困难的地方是 timing:
- 降频太晚,省不了多少电;
- 升频太晚,会拖慢 kernel;
- 频率切换和控制本身也有开销。
p33 是解释这个过程的概念示意图,不是实测执行轨迹。
| 方法 | 主要控制尺度 | 核心问题 |
|---|---|---|
| CORE | 推理阶段、工作负载层面 | CPU/GPU 等资源应该采用什么设置组合? |
| TurboInfer | 短暂的 GPU 等待区间 | 什么时候降频、什么时候恢复? |
p32 给出的最高节省比例是 power savings;是否同样节省总 energy,还需要结合任务持续时间判断。
第七部分:Adaptive Serving——请求该送到哪里?(p35–40)
前面主要讨论同一颗 SoC 内部怎样分工。这里把视角扩展到多台机器。
p35 区分两个问题:
- Within one SoC: 算子放哪个 backend,张量怎样拆分。
- Across machines: 整个请求交给哪个 execution instance。
跨机器时,必须把排队和传输算进去:
[ T_{\text{completion}} = T_{\text{transfer}} + T_{\text{queue}} + T_{\text{compute}}. ]
p36 的例子很直观:
| 机器 | 传输 | 排队 | 计算 | 总时间 |
|---|---|---|---|---|
| A | 0.2 s | 3.0 s | 1.0 s | 4.2 s |
| B | 0.2 s | 0.2 s | 2.0 s | 2.4 s |
A 单独计算更快,但 B 能更早交付结果。
因此 routing 应该参考 当前队列、模型是否已经加载、网络成本和设备负载,而不是一直选择标称最快的机器。
p37 又补充:测量还要覆盖 sustained operation,持续运行。设备刚启动时与运行很久之后,可能因为温度、后台负载、编译和缓存状态而表现不同。
最后 p38–39 给出一套项目实验路线:
| 阶段 | 要做什么 |
|---|---|
| Phase 1:Build profiles | 改变输入长度、输出长度和并发负载,测量各后端的性能与能耗 |
| Phase 2:Build a policy | 根据测量预测完成时间和能耗,在延迟约束下选择设置或路由 |
需要记录的指标包括:
- TTFT: 第一个 token 出来的时间。
- TPOT: 后续生成每个 token 所需的时间。
- Peak memory: 峰值内存。
- Energy: 每个 token 或完整任务的能耗。
- Task quality: 输出质量。
策略再与 fixed placement、round-robin、shortest-queue 等 baseline 比较,并在未见过的负载和变化中的设备状态下测试。p40 则预告下一讲转向 agent tooling、memory 和 context,阅读材料是 MemGPT。