Lesson5-Edge AI I-Local LLM Inference
这节课讲的是 Edge AI / Local LLM Inference:在个人电脑、手机这种内存、算力和功耗有限的设备上,怎么高效运行大模型。
核心主线是:推理速度不仅取决于计算能力,还取决于数据放在哪里、需要搬多少数据,以及软件能否有效调度硬件。
1. 先认识硬件:GPU、TPU 和 NPU(第 3–12 页)
这部分解释不同加速器怎么执行神经网络。
| 硬件 | 课上强调的特点 |
|---|---|
| GPU | 用 threads、warps 执行 kernel;也有专门加速矩阵运算的 Tensor Cores |
| TPU (Tensor Processing Unit) | 通过 systolic array(脉动阵列)让输入和部分结果在计算单元间流动,增加数据复用,更适合在云端做大模型 |
| Edge NPU (Neural Processing Unit) | 面向低功耗推理,依靠矩阵计算单元、片上 SRAM 和编译器安排数据移动 |
| 场景 | 常见硬件 | 主要需求 |
|---|---|---|
| 云端大模型训练、批量推理 | GPU、Google TPU | 高算力、大内存、多设备互联 |
| 手机、笔记本端侧推理 | CPU、GPU、Edge NPU | 低功耗、低延迟、有限内存 |
TPU(Tensor Processing Unit)
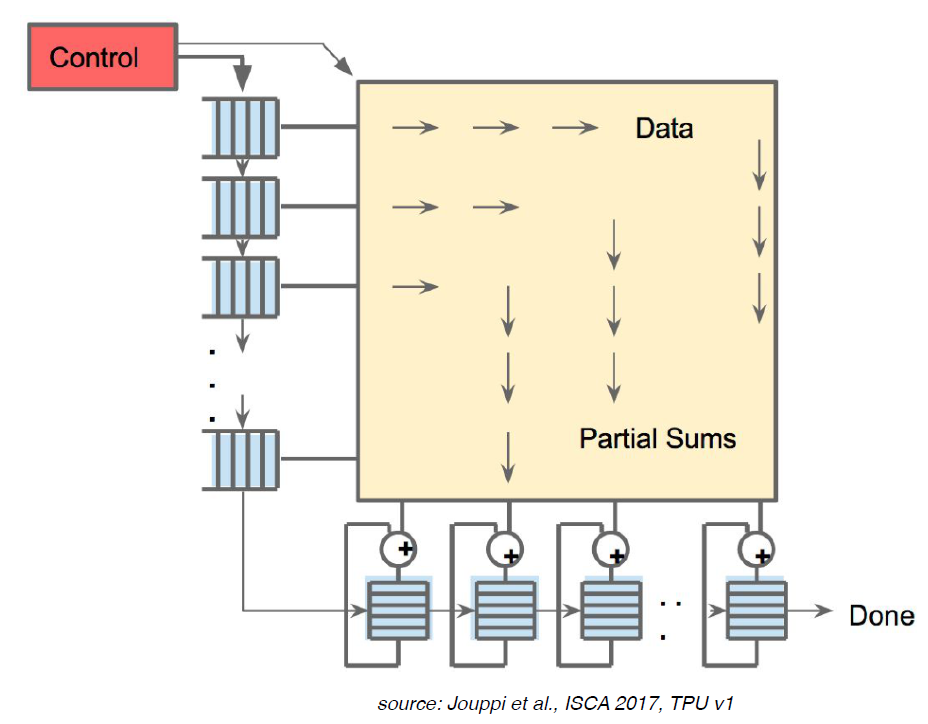
systolic array
你可以把 systolic array 理解成一组流水线式的乘加单元:数据经过不同单元时不断被使用,减少反复从外部内存读取。
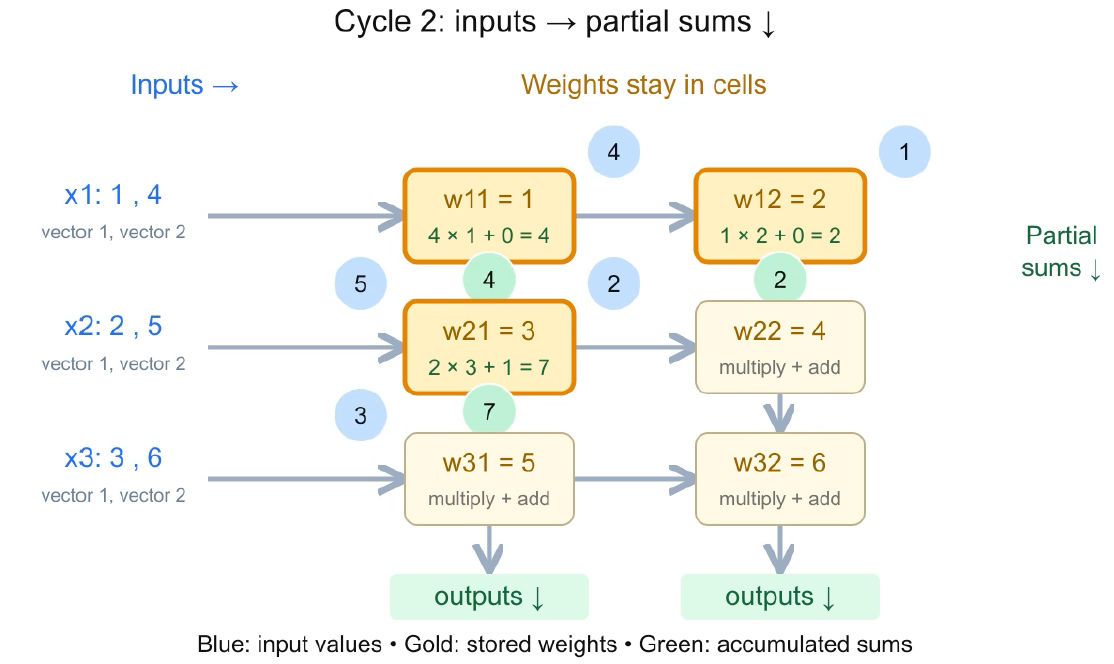
这样做为什么高效?**
权重可以留在格子里供多个输入反复使用;输入和中间结果直接在相邻单元之间传递,减少访问外部内存。流水线填满后,多个格子还能同时处理不同阶段的计算。
“脉动”就是指:每个时钟周期,数据像按节拍一样向邻居推进一步。
NPU (Neural Processing Unit)
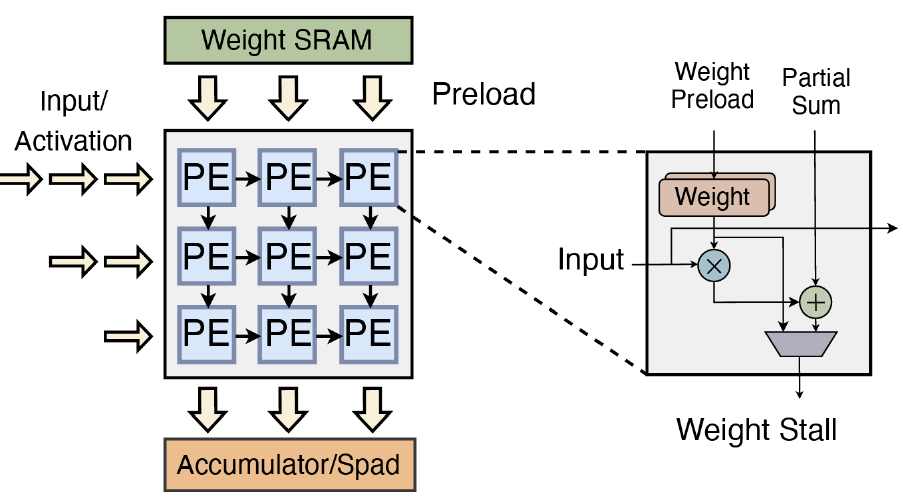
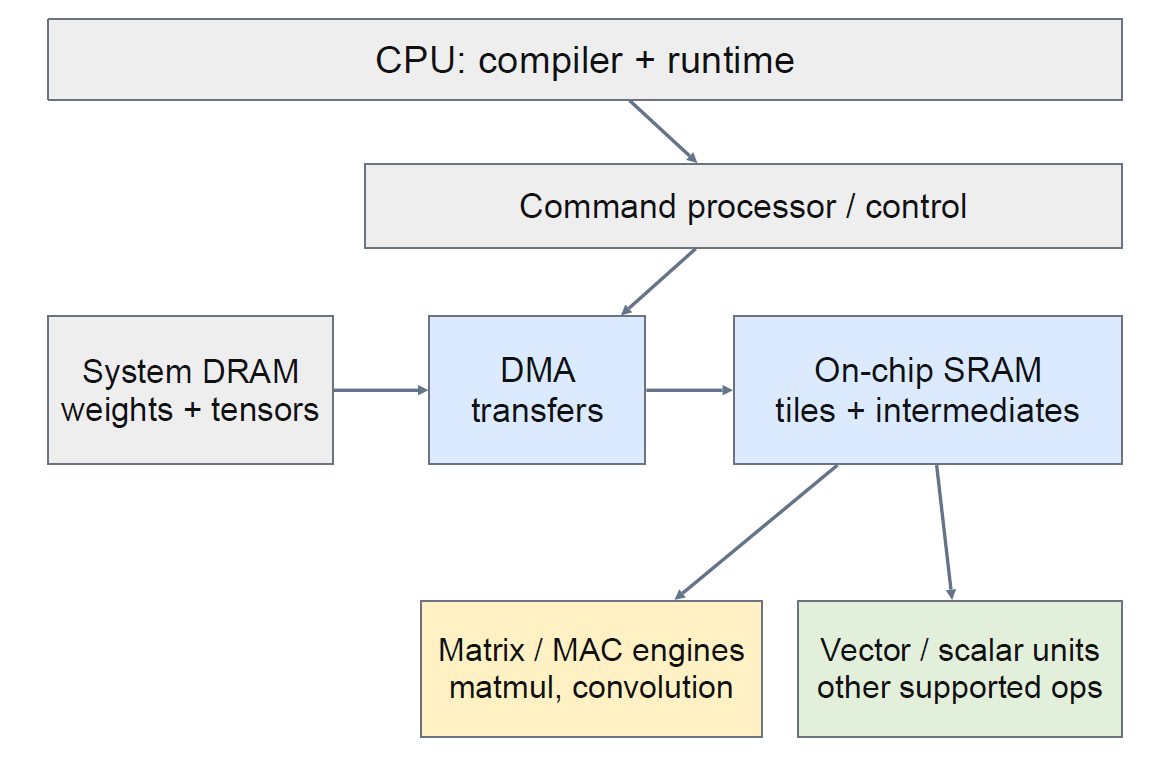
** CPU + NPU 跑 LLM 的例子:让 NPU 做适合它的密集计算,让 CPU 处理稀疏工作。
Mac 和手机就prefer NPU
这里要记住:专用加速器需要合适的算子和数据布局才能发挥性能,不能只看宣传的 TOPS。
另外,unified memory(统一内存)允许 CPU、GPU 等共享同一块物理内存,可以减少独立内存之间的复制;但它们仍然竞争带宽,也需要同步。
权重留在原地,输入向右流,累加结果向下流。
2. 软件怎么把模型送到硬件上?(第 13–18 页)
课件介绍了三个软件栈:
| 软件 | 主要作用 |
|---|---|
| llama.cpp | 管理模型加载、prefill/decode、KV cache 和采样,通过不同 backend 使用 CPU/GPU 等设备 |
| MLX | Apple 平台的机器学习框架,支持统一内存和编译优化 |
| OpenVINO | 转换模型、针对设备编译,再通过 runtime 执行推理 |
这里有两个关键例子:
- Partial GPU offload:一部分 Transformer 层在 CPU 上跑,另一部分在 GPU 上跑。每个 token 都要经过这些层,跨设备的激活传递也有成本。
- Kernel fusion:把兼容的多个操作合成一个 kernel,减少启动开销和中间结果读写。这和上一节 GPU kernel programming 的内容直接接上了。
3. PowerInfer:模型放不进显存怎么办?(第 19–40 页)
假设一个 30B 模型,FP16 权重就大约需要 60 GB,还没算 KV cache 和运行时缓冲区。消费级 GPU 通常装不下。
如果不停把 CPU 内存里的权重搬到 GPU,搬数据可能比执行计算更贵。PowerInfer 利用两个特点:
- Activation sparsity:对于一个 token,FFN 中只有一部分神经元活跃。
- Activation locality:有些神经元在很多输入中经常活跃,有些很少活跃。
因此它把:
- Hot neurons 的权重放在 GPU,利用 GPU 的速度。
- Cold neurons 的权重留在 CPU 内存;需要时直接由 CPU 计算。
- CPU、GPU 的计算结果再合并。
为什么冷神经元不也搬到 GPU?
因为只需要少量计算时,传输权重的成本可能超过 GPU 带来的计算收益。
这里还要区分两个决策:
| 决策 | 回答的问题 |
|---|---|
| Offline profiling / placement | 哪些神经元长期值得占用 GPU 显存? |
| Per-token prediction | 当前这个 token 到底需要计算哪些神经元? |
Hot 不代表每次都活跃,cold 也不代表永远不活跃。
预测器本身也有代价:多预测一个神经元会浪费计算;漏掉一个活跃神经元可能影响输出质量。所以要同时评估速度和质量。课件中还有一段 AI 数学发现讨论,属于中间的拓展话题。
4. PowerInfer-2:手机连内存都放不下怎么办?(第 41–47 页)
手机的限制更严格:不仅 DRAM 容量有限,还要考虑电池、发热,以及其他应用占用资源。
这时部分权重需要放在 flash storage(闪存)里,而闪存比 DRAM 慢得多。
PowerInfer-2 的思路是:
- Prefill:利用较密集的计算,让 NPU 执行 dense operations。
- Decode:让 NPU 处理 hot neurons,CPU 处理 sparse cold work。
- 在 DRAM 中缓存有用的神经元权重。
- 按 neuron cluster 组织工作,让闪存读取与计算重叠,减少等待。
两篇工作的联系是:
| 方法 | 主要要减少的开销 |
|---|---|
| PowerInfer | CPU 内存与独立 GPU 显存之间的权重传输 |
| PowerInfer-2 | 内存不足时的闪存读取,以及 CPU/NPU 执行中的等待 |
| anyway 总之我们要尽量减少数据在不同硬件内的传输 |
evaluation
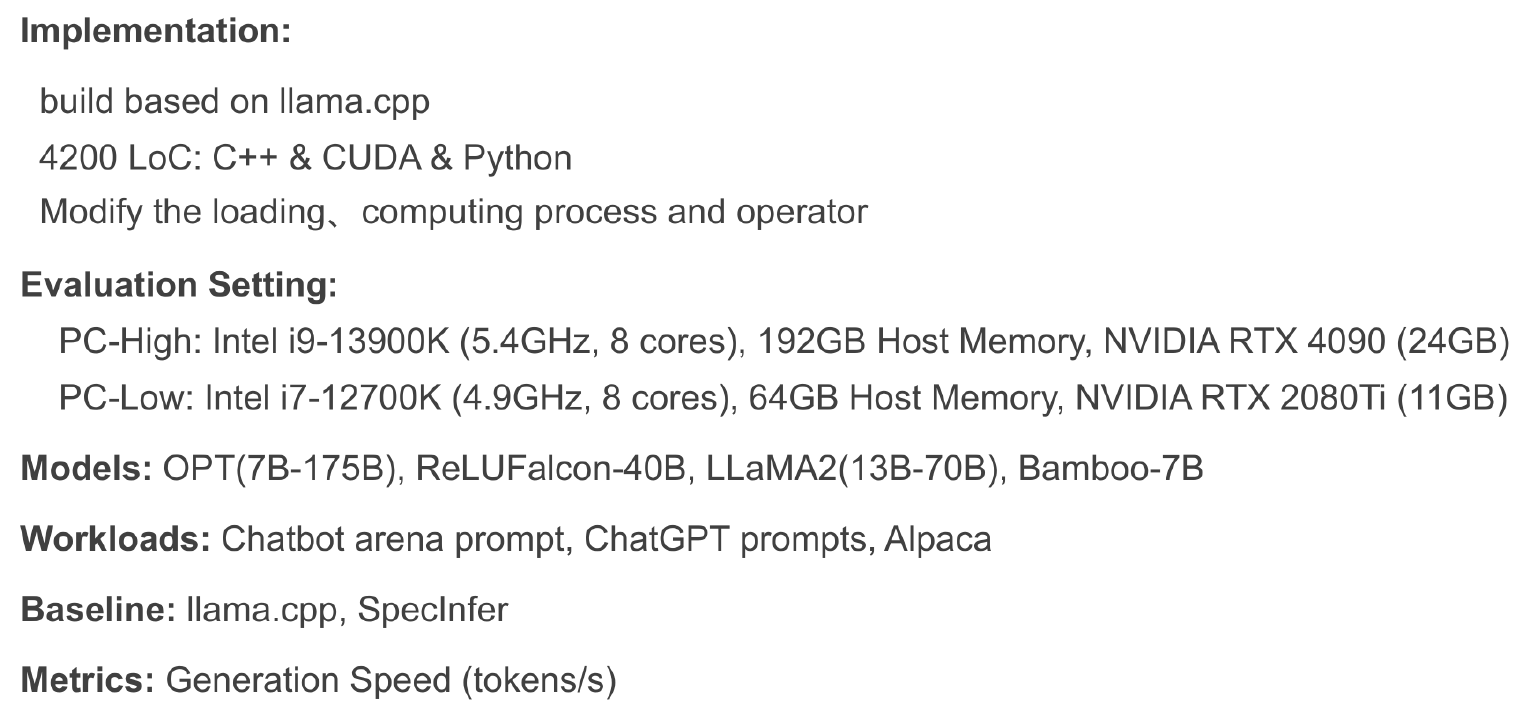
不能只问“哪个设备 token/s 更高”,还要分别测:
- Prefill:输入处理时间、TTFT。
- Decode:生成速度、每 token 延迟。
- Memory / data movement:峰值内存、带宽和传输开销。
- Software support:算子是否支持,有没有回退到 CPU。
- Quality / energy:输出质量、持续运行时的 tokens per joule。
把这节课串起来就是:硬件决定计算和存储条件 → 软件决定如何执行 → PowerInfer 系列利用稀疏性安排权重和计算 → 实验验证是否真的减少了数据移动、提升了端到端性能。