Lesson4-GPU Architecture andKernel Programming
Lecture 04:GPU Architecture and Kernel Programming
这节课研究:模型计算落到 GPU 上后,如何组织线程、搬运数据和调度任务,让硬件得到充分利用。
课程主线:
- GPU execution model:GPU 如何执行程序。
- Memory hierarchy:数据放在哪里、搬运成本是多少。
- FlashAttention:通过 tiling 减少 attention 数据搬运。
- Kernel fusion 与 megakernels:减少中间读写和任务边界等待。
- GPU runtime 与调度:如何协调计算、内存与依赖。
- Inference profiling:如何定位实际性能瓶颈。
1. GPU 执行模型(第 3–15 页)
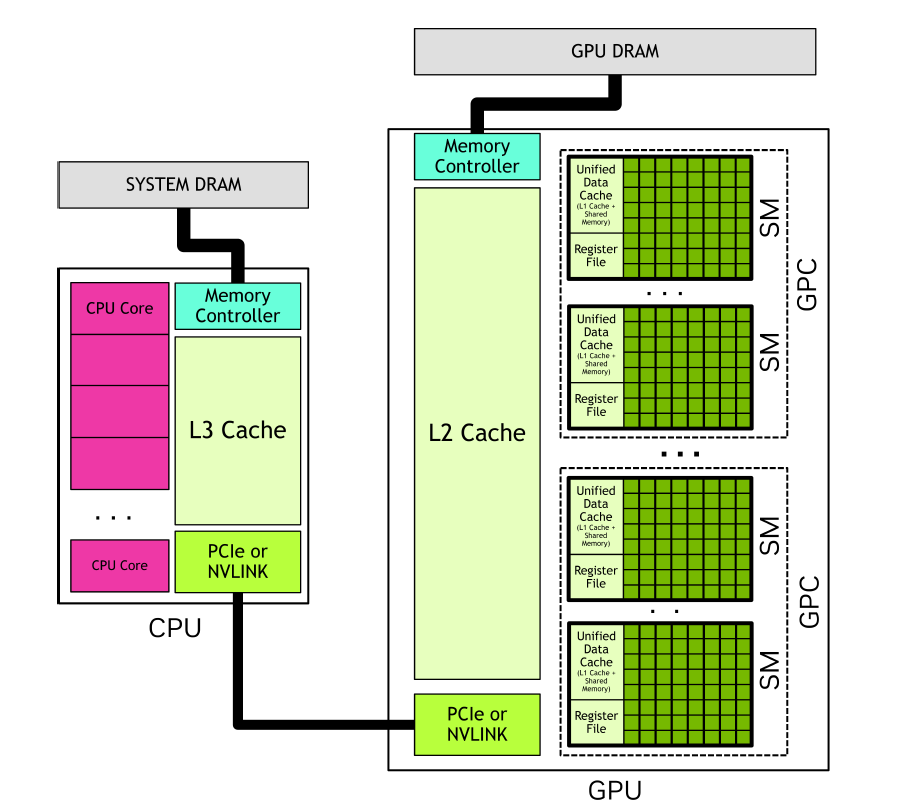
1.1 CPU Host 与 GPU Device
CPU 负责运行应用、准备数据和启动 GPU kernel;GPU 负责执行大量并行线程。
Kernel 是提交给 GPU 执行的计算程序,例如向量加法、矩阵乘法。
典型执行过程:
- CPU 准备输入。
- 把输入复制到 GPU。
- CPU 启动 kernel。
- GPU 执行计算。
- 需要时把结果复制回 CPU。
关键知识点:
- Kernel launch 通常是 asynchronous(异步)的:CPU 发起任务后可以继续工作。
- 测量 GPU 执行时间时,需要考虑同步,避免只测到任务提交时间。
- 中间张量应尽量留在 GPU,减少 CPU–GPU 传输。
1.2 Thread、Block、Grid、Warp、SM
| 概念 | 含义 | 关键关系 |
|---|---|---|
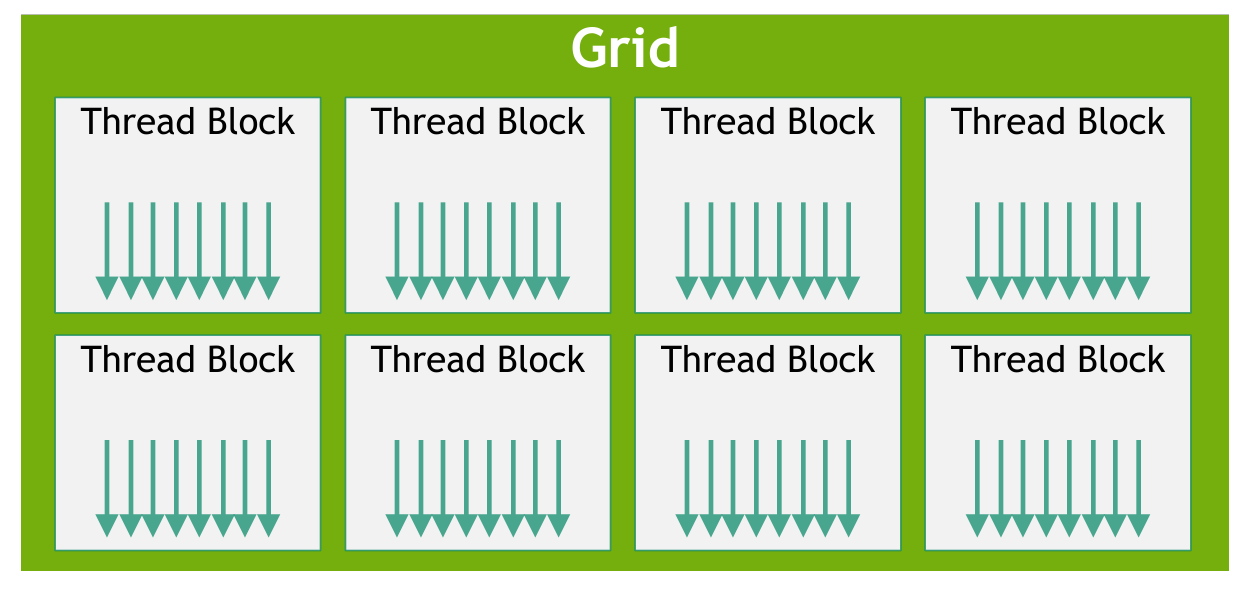
| Thread | 一个逻辑执行线程 | 有自己的索引和寄存器状态 |
| Thread block | 一组协作线程 | 可以共享 shared memory,进行块内同步 |
| Grid | 一次 kernel launch 的全部 blocks | 可以包含远多于 SM 数量的 blocks |
| Warp | NVIDIA GPU 上的一组 32 个线程 | SM 按 warp 调度指令 |
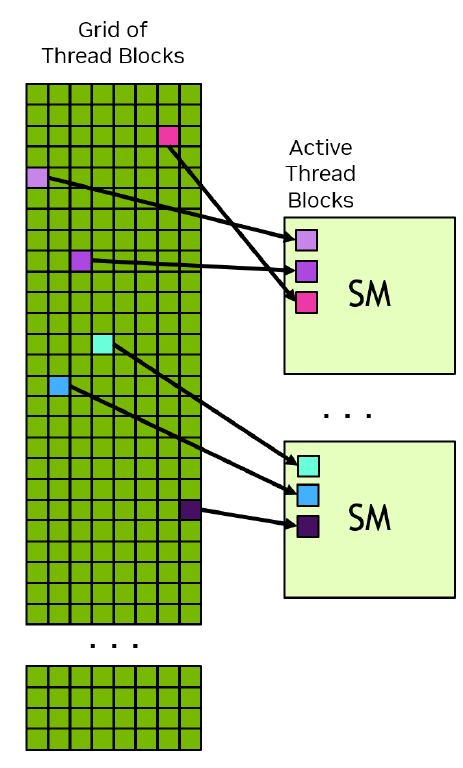
| SM | Streaming Multiprocessor,GPU 内的执行单元 | 执行 blocks,调度 warps |
需要记住:
- 一个 block 在一个 SM 上执行。
- 一个 SM 可以同时驻留多个 blocks。
- Registers、shared memory 等资源限制了同时驻留的 blocks 数量。
- 一个大 grid 可以分批执行,不要求所有 blocks 同时运行。
1.3 线程如何映射到数据?
向量加法中的索引公式:
i = blockIdx.x * blockDim.x + threadIdx.x
每个 thread 运行相同的代码,通过不同的 i 处理不同数组元素。
例如:
- 数组长度:1,000。
- 每个 block:256 个 threads。
- 需要:4 个 blocks。
- 实际启动:1,024 个 threads。
- 最后 24 个 threads 通过
i < n的边界检查跳过计算。
1.4 Warp divergence 与 latency hiding
Warp divergence:
同一个 warp 的线程进入不同分支时,不同路径的执行可能降低效率。
Latency hiding:
当一个 warp 等待数据时,SM 可以执行其他 ready warps,从而隐藏等待时间。
因此,更多线程不一定意味着更快,还需要考虑:
- 是否有足够的 ready warps。
- 分支是否分散。
- 每个 block 占用多少 registers 和 shared memory。
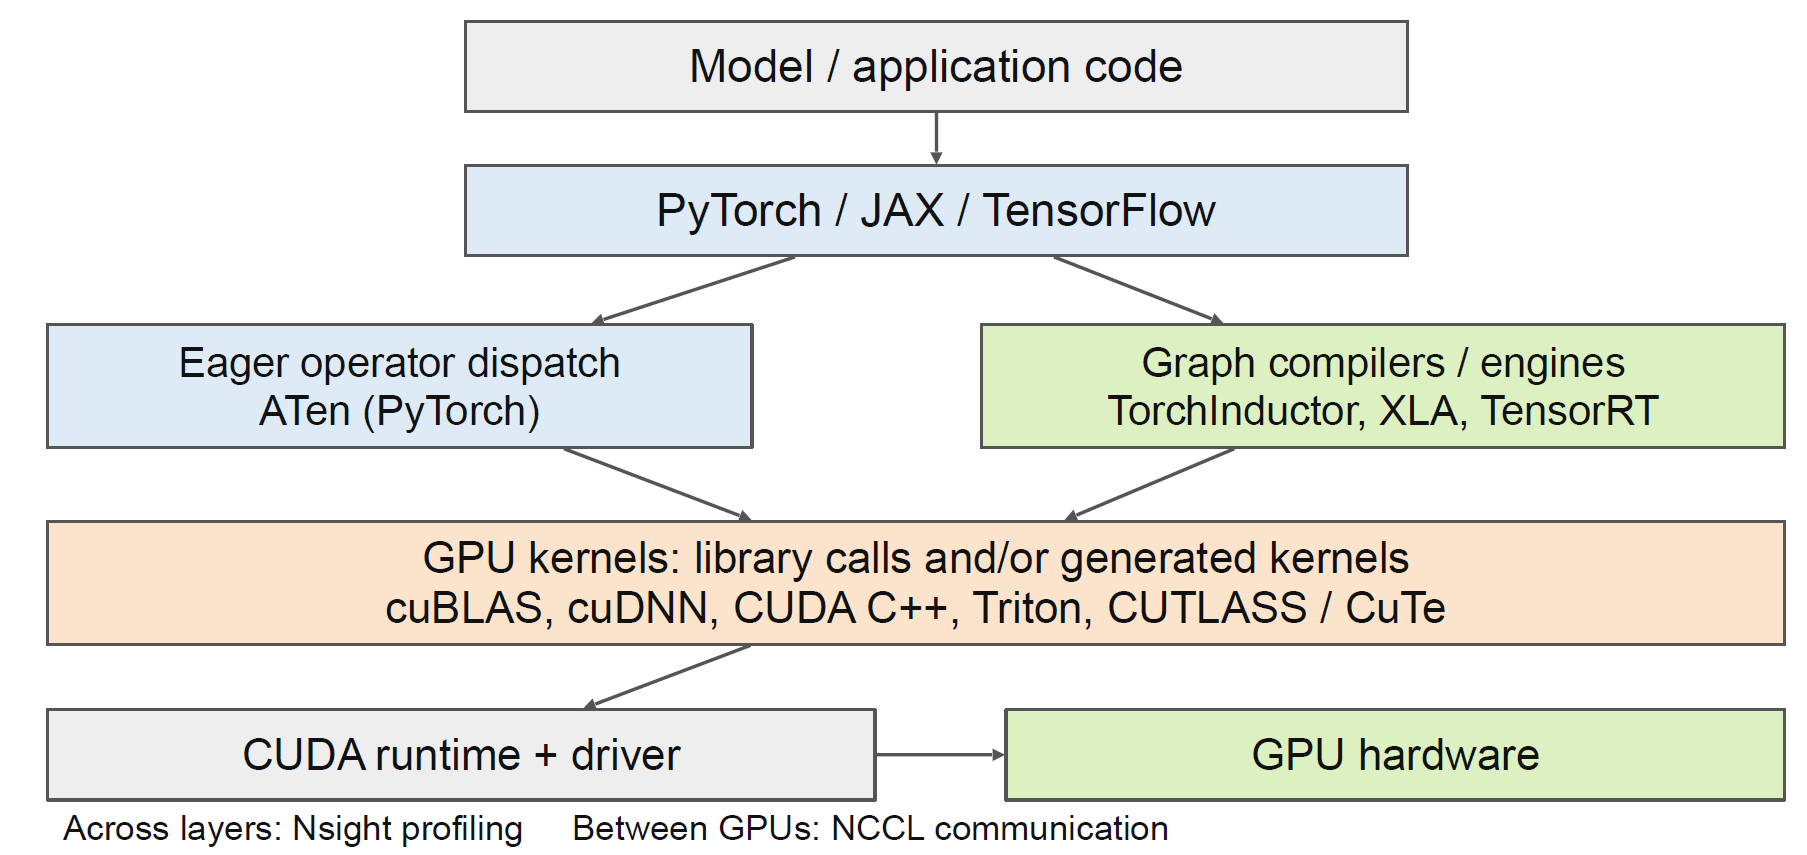
1.5 从 PyTorch 到 GPU machine code
| 路径 | 大致过程 |
|---|---|
| 框架编译 | PyTorch → Dynamo 捕获计算图 → Inductor 优化与生成代码 → Triton 等编译路径 |
| CUDA 编程 | CUDA C++ / CUTLASS / ThunderKittens → nvcc 编译 |
最终生成 GPU 执行的机器码 SASS。
本章重点:高层模型操作最终需要映射成具体的 kernels、线程和硬件执行。
2. GPU Memory Hierarchy(第 16–18 页)
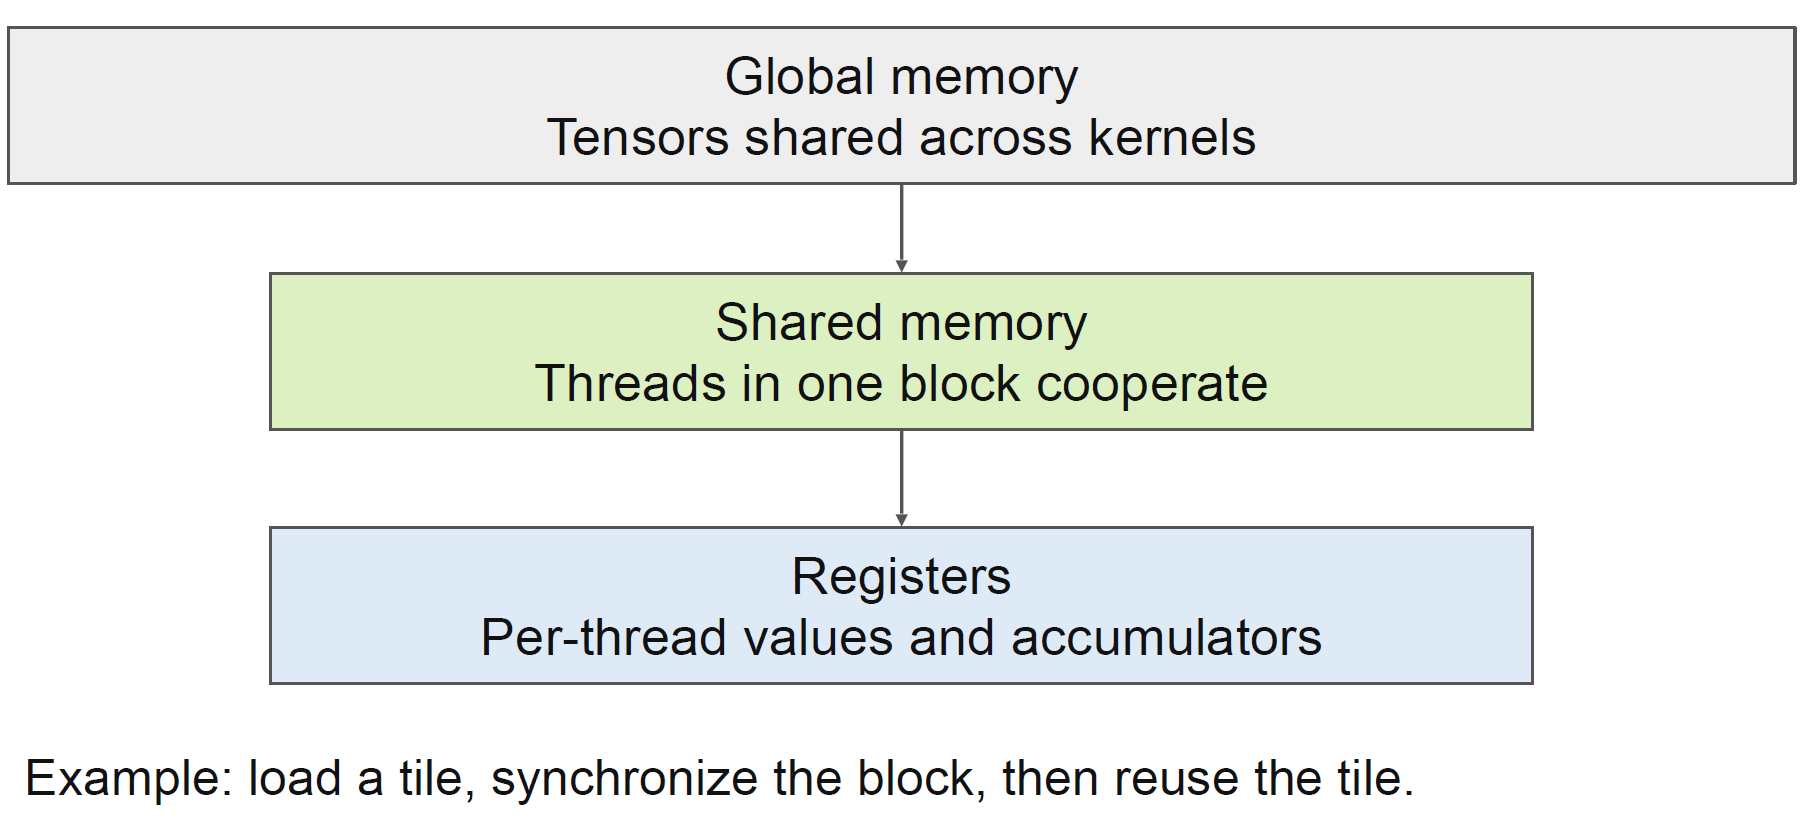
2.1 不同存储位置
| 存储位置 | 主要用途 | 特点 |
|---|---|---|
| Registers | 每个线程的临时值与累加结果 | 快,但容量有限 |
| Shared memory | Block 内线程共享的数据 | 片上存储,适合协作与数据复用 |
| Global memory / HBM (GPU 的显存) | 模型权重、大张量、跨 kernel 数据 | 容量大,访问成本较高 |
| Local memory | 线程私有数据 | 位于 device memory,不能等同于 registers |
注意:Local 表示线程私有,不表示它一定是快速的片上存储。
2.2 数据复用
多个线程需要同一块数据时,可以:
- 从 HBM 加载到 shared memory。
- 同步 block。
- 在片上多次复用数据。
这样可以减少重复的 HBM 访问。
2.3 Tensor cores 为什么可能“吃不饱”?
Tensor cores 能快速进行矩阵运算,但需要数据及时到达。
如果计算单元一直等待数据,较高的理论算力也无法转化为实际性能。
2.4 更多计算,有时反而更快
如果额外计算能够减少昂贵的数据搬运,总运行时间可能下降。
本章重点:GPU 性能不仅取决于算力,还取决于数据移动和复用。
3. FlashAttention(第 19–26 页)
3.1 Naïve attention 的数据搬运问题
标准 attention:
使用三个独立 kernels 时:
- 计算 S,写入 HBM。
- 读取 S,计算 P,再写入 HBM。
- 读取 P,计算输出 O。
问题在于:S 和 P 都是大小为 N × N 的矩阵。
课件示例:单个 attention head,N = 8192、d = 128、FP16。
| 张量 | 大小 |
|---|---|
| 单个 Q、K 或 V | 2 MiB |
| 单个 S 或 P | 128 MiB |
仅 S 和 P 各写一次、读一次,就产生 512 MiB 的数据流量。
3.2 Tiling
Tile 是大张量中的一小块数据。
基本方法:
- 把 tile 加载到快速片上存储。
- 计算并复用其中的数据。
- 再处理下一块。
注意:
- Tile 描述数据。
- Thread block 描述处理数据的线程组。
- 二者有关联,但不是同一个概念。
3.3 FlashAttention 的执行过程
以一个 query tile 为单位:
- 把 Q tile 留在片上。
- 逐块加载 K/V tiles。
- 计算小块 attention scores。
- 更新 softmax 统计量和输出累加值。
- 丢弃当前 score tile。
- 所有 K/V tiles 处理完后,写出最终输出。
关键收益:不需要把完整的 S/P 矩阵写到 HBM。
3.4 为什么不能对每个 tile 独立做 softmax?
Softmax 的分母依赖整行数据。
假设指数化后的 scores 是:
分成两块,各自做 softmax,会得到:
但整行正确的结果是:
独立归一化丢失了不同 tiles 之间的相对权重。
3.5 Online softmax
每个 query row 保留少量 running state:
- Running maximum:当前最大值。
- Normalizer:归一化分母。
- Output sum:加权输出累加值。
新 tile 到来时:
- 合并旧状态与新状态。
- 最大值变化时,对旧状态重新缩放,保持数值稳定。
因此,可以逐块计算完整 attention,无需保存整行 scores。
3.6 如何理解流量对比?
- Naïve:把所有明细写下来,再读回来算总账。
- FlashAttention:分批处理明细,持续更新总账
课件示例:
| 实现 | 估算 HBM 流量 |
|---|---|
| Naïve attention | 520 MiB |
| FlashAttention | 260 MiB |
FlashAttention 消除了 S/P 的 HBM 读写,但不同 query tiles 仍可能重复读取 K/V。
这些数字是特定配置下的简化估算,不能直接理解为所有场景都加速两倍。
FlashAttention 没有省掉必要的 attention 配对计算;它主要省掉了巨大中间矩阵的显存读写。
本章重点:FlashAttention 通过 tiling 和 online softmax,减少大中间矩阵的存储与搬运。
3.7 flash vs paged attention
| FlashAttention 的 tiling | PagedAttention | |
|---|---|---|
| 分块对象 | Attention 计算中的张量 | KV cache |
| 主要目的 | 在片上复用数据,减少显存读写 | 灵活分配显存,减少碎片和预留浪费 |
| 直接收益 | 计算单元少等数据 | 显存能容纳更多请求,提高 batching 和吞吐量 |
4. Kernel Fusion 与 Megakernels(第 28–40 页)
4.1 Kernel fusion
Kernel fusion 将多个操作合并到一个 kernel。
例如:
分开执行时:
- Kernel 1 把 t 写入 global memory。
- Kernel 2 再读取 t。
融合后:
- t 可以留在 registers。
- 直接计算 ReLU。
- 最后只写出 y。
主要收益:
- 减少 kernel launches。
- 减少中间张量读写。
4.2 Megakernel
一个常驻 kernel,在内部调度并执行多个任务
Megakernel 使用较大的 persistent kernel,在内部执行多个任务,并由 GPU 进行任务或指令调度。
| 方面 | 普通 kernel fusion | Megakernel |
|---|---|---|
| 主要关注 | 合并若干操作 | 执行和调度多个内部任务 |
| 生命周期 | 完成融合操作后退出 | 持续处理内部任务 |
| 主要收益 | 少 launch、少中间读写 | 进一步减少任务边界等待,增加 overlap |
4.3 Coarse dependencies 与 tail effects
假设一个 CUDA stream 中,kernel A 后面是 kernel B。
通常 B 要等整个 A 完成,即使 B 的部分输入已经准备好。
与此同时,A 中较早完成工作的 SM 可能闲着,等待较慢的部分结束,这就是 tail effects。
Megakernel 可以把依赖细化到内部任务:
Consumer 所需输入准备好后,就可以开始执行。
4.4 ThunderKittens 与硬件支持
ThunderKittens 提供围绕 tiles 和 pipelines 的编程抽象。
课件讨论的硬件支持:
- Ampere asynchronous copies:让 global-to-shared 数据搬运与计算重叠。
- Hopper TMA:支持批量异步数据传输。
- 异步 tensor core 操作、barriers、片上 buffers:支撑流水线。
- Warp specialization:不同 warps 分别负责加载、计算等工作。
目标是让数据搬运与计算并行推进。
4.5 三个实现难点
| 难点 | 课件方案 | 作用 |
|---|---|---|
| 支持很多操作 | On-GPU interpreter | 使用统一指令格式执行不同任务 |
| 共享 shared memory | Shared-memory paging | 按需申请、释放片上空间,支持预取 |
| 同步 producer 和 consumer | Dependency counters | 根据生产任务完成情况启动消费任务 |
注意:这里的 shared-memory paging 管理的是 SM 内的 shared memory,与 KV cache 分页不同。
5. Megakernel 系统设计与 VDCores(第 41–48 页)
5.1 系统组件
| 组件 | 职责 |
|---|---|
| Task set | 定义支持哪些内部操作 |
| Compiler | 把计算图转换、优化成内部任务图 |
| Scheduler | 决定任务何时执行、由谁执行 |
| Worker | 在 GPU 内执行任务的常驻 kernel |
Megakernel 需要完整的编译、资源管理和调度系统。
5.2 Scheduler 的设计选择
调度组织:
- Distributed scheduling:调度逻辑分散在 workers 中。
- Separated scheduling:使用专门的调度执行单元。
调度粒度:
- Block / CTA。
- Warp。
- Thread。
调度时机:
- Static scheduling:提前确定任务安排。
- Runtime scheduling:根据运行状态动态决定。
更细、更动态的调度可能提高资源利用率,也可能增加管理开销。
5.3 VDCores:计算与内存解耦
VDCores 将工作分成独立、异步执行的虚拟单元。
| 虚拟单元 | 职责 |
|---|---|
| Compute Virtual Core | 执行计算任务,使用 Tensor/CUDA cores |
| Memory Virtual Core | 管理 shared memory,安排 load/store 和 TMA |
通过消息协调:
- M2C:把准备好的输入内存交给 compute。
- C2M:compute 通知 memory 哪些内存已经使用完毕。
核心原则:
- Isolation:各单元根据自己的局部状态执行。
- Asynchrony:通过显式依赖消息协调,无依赖的工作可以并行。
本章重点:让计算与数据搬运独立推进,按真实数据依赖进行协调。
6. 生产应用与 AI 生成 Kernels(第 49–51 页)
6.1 生产系统关注什么?
课件用 DeepSeek-V4 举例,讨论:
- 融合小算子。
- 减少 Python dispatch 和重复检查。
- 让通信与计算重叠。
- 保持数值确定性与 batch-invariant behavior。
Kernel benchmark 除了时间,还应检查:
- 输出正确性。
- 数值误差。
- 不同 shapes、precision 和 batch 下的行为。
6.2 AI for kernel generation
基本优化循环:
- 生成 kernel 代码。
- 编译。
- 正确性测试。
- 性能测试与 profiling。
- 根据反馈修改代码。
课件涉及 KernelBench、搜索、强化学习和面向不同硬件的生产优化。
关键知识点:
- Kernel 优化需要实际 GPU 反馈。
- 一个 shape 上快,不代表所有 shapes 都快。
- 一个硬件上有效,不代表其他硬件上也有效。
7. Inference Profiling 与下一节课(第 52–53 页)
7.1 公平比较机器
固定以下条件:
- 相同模型。
- 相同 precision。
- 相同 workload。
否则无法判断差异来自硬件还是实验设置。
7.2 分开分析 prefill 与 decode
分别调整:
- Prompt length。
- Output length。
测量:
- Latency。
- Memory usage。
- Sustained bandwidth。
Prefill 和 decode 的计算形状、数据复用与并行机会不同,需要分别 profiling。
7.3 根据瓶颈选择优化方法
| 观察到的问题 | 优化思路 |
|---|---|
| 大量中间张量读写 | Tiling、kernel fusion |
| Kernels 之间有明显空隙 | 减少 launch/dispatch,改进调度 |
| 计算单元等待数据 | 预取、异步流水线、增加复用 |
| CPU–GPU 传输较多 | 改善 data placement |
| 模型权重放不进加速器 | 考虑 edge inference 与异构执行 |
下一节课转向 Edge AI 与 NPUs,指定阅读是 PowerInfer(SOSP 2024)。
复习重点
- 区分 Thread、Block、Grid、Warp 和 SM。
- 理解 registers、shared memory 与 HBM 的区别。
- 解释 FlashAttention 为什么需要 online softmax。
- 区分 kernel fusion 与 megakernel。
- 理解 coarse dependencies 和 tail effects。
- 理解异步搬运、warp specialization 和任务调度如何提高利用率。
- 能根据 profiling 结果判断瓶颈来自计算、数据搬运还是调度。