Lesson3-LLM Inference-KV State and Tool Calls
LLM 的 KV cache 如何分配、复用,以及调用工具暂停时如何管理
PagedAttention:如何节省 KV cache 的显存
Memory Calculation
• KV bytes per token = 2 × layers × KV heads × head dimension × bytes per element
• Example: 32 layers × 8 KV heads × 128 dimensions × FP16
• 128 KiB per token → 1 GiB at 8,192 tokens
• This excludes model weights, activations, and allocator overhead
上下文越长,KV cache 越大;课件的示例中,8,192 个 token 就需要约 1 GiB。
fragements
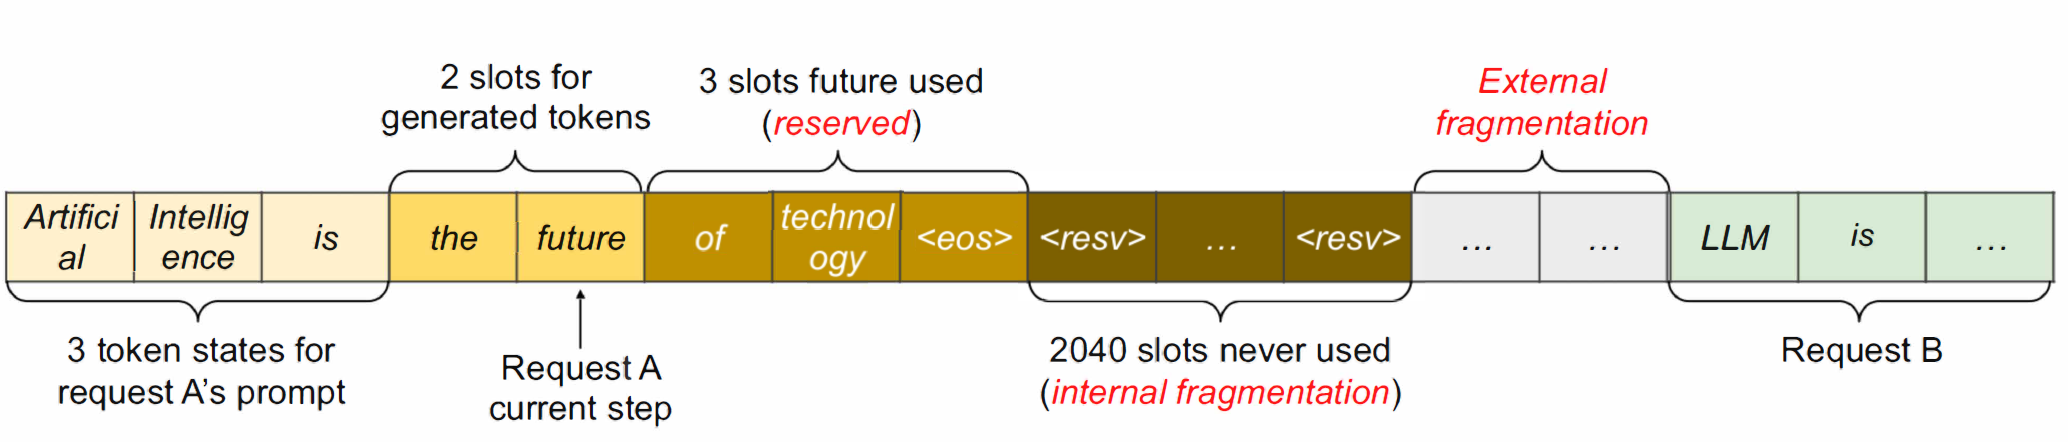
• Reservation: not used at the current step, but used in the future
• Internal fragmentation: over-allocated due to the unknown output length.
• External fragmentation: due to different sequence lengths.
类似操作系统的分页,把 KV 分成固定大小的块,不必放在连续显存中。
减少预留空间和碎片浪费,是 vLLM 的关键机制。
Prefix caching / SGLang:如何避免重复计算
Prefix(前缀)的定义
给定 token 序列 ,如果存在整数 ,使得
那么 就是 的前缀。也就是说,前缀必须从序列的第一个元素开始,并且连续,不能跳过任何元素。
等价地,存在序列 ,满足
其中 表示序列拼接。空序列和 自身也算前缀;若 ,则称为真前缀(proper prefix)。
例如,对于 :
- 是前缀。
- 是连续子序列,但不是前缀。
- 不是前缀,因为跳过了 。
LLM Prefix Caching 中的含义
这里的前缀指的是完整模型输入的 token 序列的前缀,包括 system prompt、对话历史和角色标记等,而不只是用户可见的文字。
两个输入 共享长度为 的前缀,意味着
共享前缀是序列上的条件;精确复用 KV cache 还要求模型权重、位置编码及其他影响计算的条件一致。
对于因果 Transformer,前 个 token 无法关注后续 token。因此,在上述条件一致时,即使后续内容不同,前缀的 KV 状态也保持不变,可以复用。
- 多次请求共享完全相同的前缀时,可以直接复用它的 KV,只计算新增部分。
- 例如“同一份文档+不同问题”,文档部分不用每次重新 prefill。
- 只能直接复用相同前缀:即使中间文字相同,前面的上下文变了,后续 KV 通常也会变。
- SGLang 的 RadixAttention 用树组织这些共享前缀。
InferCept:Agent 等工具结果时,KV 放哪里
| 策略 | 好处 | 代价 |
|---|---|---|
| 留在 GPU | 恢复快 | 等待期间占显存 |
| 丢弃,回来后重算 | 释放显存 | 重算耗时,还可能阻塞其他请求 |
| 换出到 CPU,回来再换入 | 保留状态并释放显存 | 消耗传输带宽 |
InferCept 根据等待时间、显存压力和计算/传输成本选择策略,还通过分块重算、传输与计算重叠减少对其他请求的影响。
最后讲了怎么做实验:改变上下文长度、工具等待时间、显存预算,测恢复延迟、端到端延迟、峰值内存和重算 token 数,找出各策略适用的条件。