Lesson13-Agent Harnesses, Meta-Harnesses,and Runtimes
一个 LLM 要成为能持续做事、调用工具、崩溃后恢复、与其他 agent 合作的系统,模型外面需要怎样的运行框架?
Agent Harness 的位置与基本运行方式(第 1–5 页)
开头提出三个主要问题:模型外面需要运行什么?哪些状态能在重置或崩溃后保留?如何管理不同的 agent 实现?
这里先区分三个层次:
| 层次 | 主要职责 |
|---|---|
| Model | 根据上下文生成文本或工具调用 |
| Harness | 管理上下文、模型调用循环、工具执行和策略 |
| Meta-harness | 跨不同 harness 管理 session 和协作 |
一个任务可能需要反复经历“构造上下文 → 调用模型 → 执行工具 → 记录结果”。此外,历史记录、当前上下文、文件、运行中的工具和预算,是不同类型的状态。
2. DeepSeek Harness:组件、工具执行与事件日志(第 6–9 页)
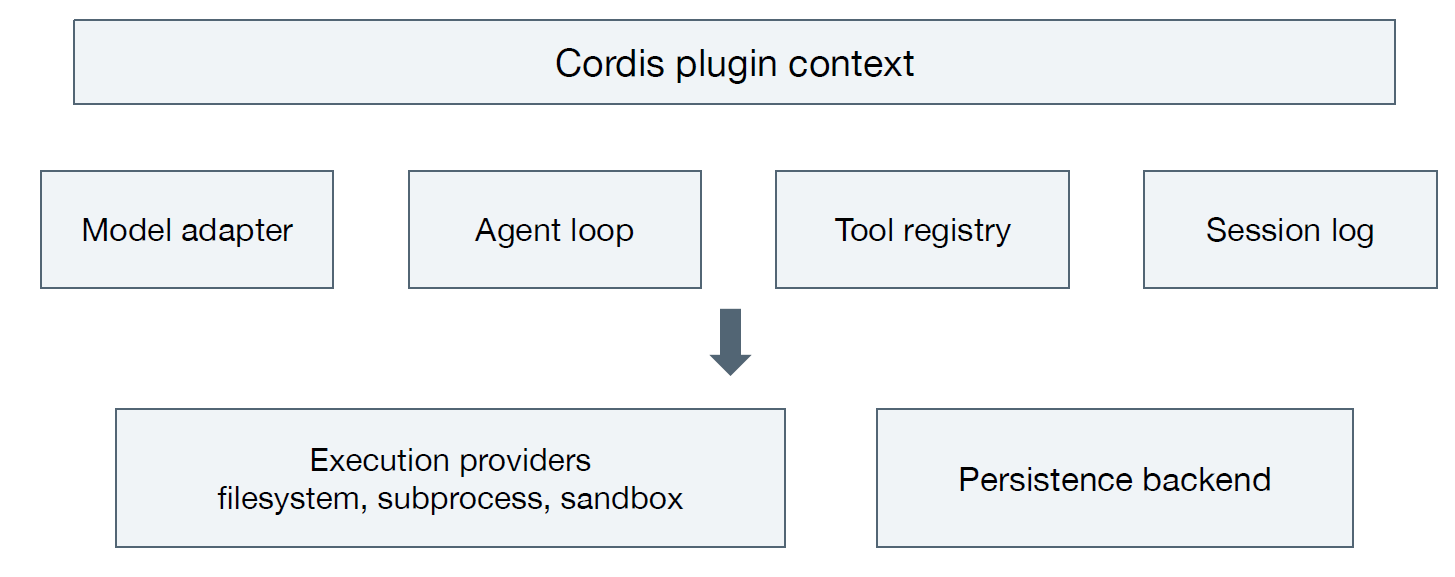
这一部分用 DeepSeek Harness 展示具体系统如何拆分:
- Model adapter:连接模型。
- Agent loop:控制执行循环。
- Tool registry:管理工具。
- Execution providers:提供文件系统、子进程和 sandbox。
- Session log 与 persistence backend:记录、持久保存状态。
工具调用也有一套处理流程:记录调用、检查权限和审批、执行、处理超时与指标、规范化并记录结果。被拒绝的工具调用也要留下结果记录。
历史采用 append-only event log:不断追加输入、模型输出、工具调用和结果。从这份日志中,再构造下一次模型请求使用的历史。
故障恢复、Fork 与跨上下文持续工作(第 10–15 页)**
这一部分围绕“任务中断后怎么继续”展开。
ambiguous tool outcome
工具可能已经执行成功,但 harness 没有记录到结果。
例如:
- Harness 记录
tool call ID 42。 - Remote service 成功创建 issue。
- Harness 在保存 issue ID 之前 crash。
恢复后,系统只知道请求发出过,却不知道结果。这里有两个不同的状态:
- Local log:没有成功记录。
- Remote state:issue 已经存在。
因此,missing result ≠ failed action。直接 retry 可能创建 duplicate issue。
正确做法是先 reconcile(核对实际状态)。如果服务支持 idempotency key(幂等键),同一个逻辑操作可以使用同一个 key 重试,避免重复创建。但本地 call ID 本身不保证远程操作幂等。
Forking
这里的 fork 指从已有状态分出一个分支,但必须明确:你分出的到底是哪种 state?
| 类型 | 复制或捕获的内容 | 不自动处理的内容 |
|---|---|---|
| Session fork | 选定的 conversation history | 文件、运行中的进程 |
| Git worktree | 独立的 code checkout | Agent memory、进程状态 |
| OS / VM snapshot | 捕获的 execution state | Remote side effects 的回滚 |
| 例如 agent 已经改了代码、启动测试、创建远程 issue: |
- Fork conversation,不代表代码和测试进程也被复制。
- 创建 worktree,不代表新分支继承了 agent 的记忆。
- 恢复 VM snapshot,不代表远程 issue 被删除。
所以 local state recovery 和 remote side-effect recovery 需要分别处理。
long process
然后介绍长任务的接力方式:结构化任务清单、每次完成有限工作、保存测试结果、进度和提交记录。上下文选择也是运行时策略,需要从完整记录中挑选本轮真正需要的信息。
Work Across Context Windows
长任务可能超过一个 context window。这一页介绍如何让不同 session 接力:
- Initializer:准备环境和 structured task list。
- Coding session:每轮完成一个 bounded piece of work,也就是范围明确的小块工作。
- Persistent artifacts:用 tests、progress records 和 commits 留下接力依据。
例如,下一轮应能看到:
Login 已实现并 commit;相关 tests passed;search 尚未完成;next step 是实现 search endpoint。
为什么 compaction alone 不够?
因为摘要可能只写“登录基本完成”,没有说明哪些测试通过、哪些修改已保存、还有什么问题。Summary 帮模型理解历史;artifacts 帮系统确认实际进度。
同时要区分:
- Context reset:模型失去部分上下文,但工具可能还在运行。
- Process crash:控制程序终止,未持久保存的执行状态也可能丢失。
Context Selection
这里区分:
- Full record:系统保存的完整历史。
- Model-facing context:本次真正送入模型的内容。
下一步如果只是修复某个测试,context 可以选择 relevant events、task summary、相关代码和 test results,而不需要塞入所有历史。
但选择信息时要避免 omitted state(遗漏状态)。
例如只放“tests failed”,却漏掉“这是旧版本的测试结果”,agent 就可能去修一个已经解决的问题。
因此还要保留 provenance(来源):这条信息来自哪次执行、哪个工具、哪个代码版本。评估策略时,同时考虑 retrieval cost 和遗漏信息造成的错误。
Pause, Cancel, and Resume
最后区分 暂停、取消和恢复:等待用户不是工具失败;取消需要传递给正在执行的操作;恢复时要确认哪些工作未完成、哪些已经产生效果。
| 操作 | 含义 | 系统需要做什么 |
|---|---|---|
| Pause | 暂时等待,例如等待用户回复 | 保存 resumable state |
| Cancel | 请求停止工作 | 将 cancellation 传递给模型和工具 |
| Resume | 从中断处继续 | 核对 unfinished work 和 completed effects |
两个容易混淆的点:
- Waiting ≠ failure:等待 approval,不应该当作工具失败反复 retry。
- Local cancellation ≠ remote cancellation:本地 harness 停止后,远程 test job 可能还在运行。
Resume 时,要区分工具是 not started、still running、completed but unrecorded,还是 failed with partial effects。不同状态需要不同处理。
Runtime Design Exercise
场景是:
Agent edits a file → starts a test job → loses its connection。
新的 replacement harness 应该:
- Read durable records:找到 session ID、文件版本、operation ID 和 test job ID。
- Inspect current state:检查文件,并查询原来的 test job。
- Decide how to resume:仍在运行就等待;已完成就取回结果;结果不确定就先 reconcile。
不能统一采用“重新执行一次”:read-only operation 通常容易安全重试;重新启动测试可能浪费资源;创建远程 issue 则可能产生 duplicate side effects。
分离故障域与凭证安全(第 17–19 页)**
如何拆分 agent runtime,让系统能分别处理组件故障,并保护 credentials
Separate Failure Domains
Failure domain 指某个组件出故障时,直接受影响的范围。这页以 Anthropic Managed Agents 为例,把系统分成三部分:
| 组件 | 职责 | 生命周期特点 |
|---|---|---|
| Session log | 持久保存输入、输出、工具调用等 events | 独立于 harness 保存 |
| Harness + model | 运行 model–tool control loop | 可作为 worker 被替换 |
| Sandbox / tools | 执行代码、命令和工具 | 有独立的 execution lifetime |
为什么要拆开?假设 agent 正在跑测试,此时 harness crash:
- 如果日志只在 harness 内存中,进度记录可能丢失。
- 如果测试进程和 harness 绑定在一起,测试也可能被终止。
- 如果三者分离,日志可以保留,测试可能继续运行,再由 replacement harness 接手。
这里的关键是 separate lifetime:控制程序结束,不必意味着记录和执行环境也一起结束。
但这不代表系统自动具备恢复能力,还需要下一页的 recovery protocol。
Recovery After Separation
这一页分别讨论两种故障。
① Harness failure
新的 replacement harness 读取 external session log,重建任务进度,再核对工具当前状态。
例如日志里记录了“启动测试,job ID 为 123”,新 harness 就可以查询这个 job,决定继续等待还是获取结果。
注意:log 记录的是事件,不一定包含完整的 live execution state。 读取日志后仍需要检查实际环境。
② Sandbox failure
如果 sandbox crash,而 harness 仍然运行,系统可以把它表示成一个 tool error,让 harness 决定如何处理。
但启动 replacement sandbox 后,可能需要做 environment reconstruction:
- 恢复代码和文件。
- 安装 dependencies。
- 恢复必要配置。
- 重新执行丢失的计算。
所以这一页提出的问题是:
Which local artifacts require their own persistence?
也就是:哪些本地产物必须单独持久保存?
| Artifact | 丢失后的影响 | 可能的处理方式 |
|---|---|---|
| 已修改但未保存到外部的代码 | 工作成果丢失 | 持久保存代码或 patch |
| Test results | 无法确认验证状态 | 保存结果及对应代码版本 |
| Dependency environment | 新 sandbox 无法执行 | 保存可重建环境的配置 |
| Temporary files | 可能需要重复计算 | 根据重建成本决定是否保存 |
这些是帮助理解的例子。
核心是:durable session log 不等于 durable workspace。
Credentials and Untrusted Execution
这一页转向安全:执行模型生成代码的 sandbox,不应默认拿到服务凭证。
这里的 credentials 包括 API keys、access tokens 等。PPT 描述的方式是:
Sandbox 发出服务请求 → Proxy 检查并转发 → Proxy 附加 credentials → External service。
这样凭证保存在 sandbox 外,由 credential proxy 在访问服务时使用。Sandbox 内执行的代码无需直接读取原始 key。
但这只解决了 credential exposure(凭证暴露) 的一部分问题。Runtime 仍然需要定义:
- Allowed operations:允许调用哪些服务、执行哪些操作?
- Allowed data:哪些数据可以读取或发送?
- Destination restrictions:请求可以发往哪里?
PPT 最后问:
Can an authorized tool become a data-exfiltration path?
答案在概念上是可以的。例如 agent 有权限读取文件,也有权限调用一个外部上传工具;如果它把敏感文件通过该工具发出去,即使没有偷到 API key,也发生了 data exfiltration(数据外泄)。
因此,保护 credentials 和 约束工具如何使用数据 是两个不同的控制问题。
Meta-harness:统一管理不同 Agent 实现(第 20–23 页)**
这一部分介绍为什么需要跨 harness 的统一管理层,并以 Omnigent 为例。
统一接口需要表达 session 的身份、状态、输入、事件和最终产物,还要明确支持哪些操作,例如 resume、fork、approval 和 cancellation。
重点是:统一接口仍需要让调用者看到不同后端的行为差异。
Omnigent 的例子是把编码工作交给不同 harness 的 agent,用独立 git worktree 保存修改,再让其他厂商的 agent 审查 diff,最后交给人整合。
Agent Teams:协作状态与并行成本(第 24–27 页)**
这一部分进入多 agent 协调:
- Lead session 管理成员、任务依赖图和 mailbox。
- 消息需要排队、持久接收和确认。
- 任务更新用 revision 拒绝过时修改。
- 任务依赖必须保持无环。
- 声明写入目录范围不等于文件锁。
随后讨论并行成本:worker 越多,模型调用、上下文和工具竞争也越多;预算要覆盖所有子任务,失去价值的分支应及时取消。
第 27 页用 critical path 解释延迟。两个并行任务分别耗时 4 和 7,后续审查耗时 2,总时间为:
[ T=\max(4,7)+2=9 ]
Harness 的评估与自动优化(第 28–30 页)**
Evaluation
Harness 会影响 context selection、tool execution、retry、recovery 等行为。要判断提升是否来自 harness,需要控制其他因素:
Hold the model, task set, tools, and total budget fixed.
也就是固定模型、任务集、可用工具和总预算,再比较不同 harness。
例如 Harness A 成功率更高,但它使用了两倍 tokens,就不能直接认为它的策略更高效。需要同时报告:
| 指标 | 衡量什么 |
|---|---|
| Task success | 任务是否正确完成 |
| Tokens | 模型消耗了多少输入、输出 tokens |
| Wall time | 从开始到结束的实际耗时 |
| Tool cost | 工具调用产生的资源或服务成本 |
除此之外,还要测试 fault tolerance(容错能力):在已知的执行边界主动注入 crashes 和 duplicate messages。
例如,在“远程操作成功、结果尚未记录”的边界制造 crash,观察恢复时是否重复执行。主要追踪:
- Duplicated effects:是否重复创建 issue、重复提交任务。
- Recovery time:恢复正常执行需要多久。
- Lost progress:已经完成的工作丢失了多少。
所以这页的评估对象包含两个维度:正常情况下的 efficiency,以及故障情况下的 reliability。
Meta-Harness — Optimizing Harness Code**
这里的 “meta” 换了一个含义。
| 前面的 Meta-harness | 这里的 Meta-Harness |
|---|---|
| 统一管理不同 harness | 搜索、优化 harness 的实现 |
| 关注 session、adapter 和协作 | 关注 execution feedback 带来的改进 |
可以把这里的过程理解为:
提出一个 harness implementation → 执行任务 → 获得 feedback → 修改 implementation → 再评估。
被优化的可能是 context selection、retry strategy 或工具调度等策略。这些是帮助理解的例子;这页本身主要给出了 search over harness implementations using execution feedback 的概念。
重点是:模型不变,也可以通过改进它外面的控制程序,改变整个 agent 的表现。
Harness Optimizer Overfit
自动优化可能提高评测分数,却没有带来可泛化的改进。这页指出三个风险。
① Overfit to training tasks or evaluator
优化器可能利用训练任务或 evaluator 的特殊规律。
例如,某类任务总是采用相同格式,harness 学会了针对这个格式的捷径;换成 held-out tasks(未参与优化的任务) 后,效果可能下降。
因此需要区分 优化时使用的任务 和 最终评估的任务。
② Quality gains may consume more resources
成功率提高,可能只是因为用了更多 tokens 或 external tool calls。
例如从“生成一次答案”改成“生成五次,再选一次”,质量可能提升,但成本也增加。要判断收益是否值得,需要在明确的 budget constraints 下比较。
③ Generated harness may weaken policy or failure handling
优化器也可能通过减少 permission checks、忽略 tool errors 或简化 recovery 来获得更低延迟、更高表面成功率。
因此 policy enforcement 和 failure handling 需要作为约束保留,不能只让优化器追求 task score。
这页最终给出的原则是:
Use held-out tasks and enforce budgets and safety constraints.
课程项目联系与收尾(第 31–33 页)**
最后把上述内容连接到课程项目:
- Edge:比较模型计算与 harness、工具开销。
- Security:检查嵌套工具调用中的策略执行。
- Fuzzing:恢复测试活动时避免重复已完成任务。
老师建议的项目方式是:选一个小的运行时策略改动,与 baseline 做比较。