Lecture 14- Reinforcement Learning Infrastructure
如何高效地协调 LLM 强化学习中的生成、评分、训练、参数同步,以及工具和环境执行?
1. RL 在模型训练中的位置(p2–6)
三个训练阶段
| 阶段 | 学习方式 | 主要目的 |
|---|---|---|
| Pretraining | 在大量文本上预测下一个 token | 学习语言、知识与一般能力 |
| Supervised Fine-Tuning,SFT | 模仿优质的 prompt–response 示例 | 学习遵循指令和回答问题 |
| Reinforcement Learning,RL | 生成回答,根据奖励更新模型 | 提高高奖励行为的概率 |
例如,训练模型解数学题:
- SFT:提供标准解答,让模型模仿。
- RL:让模型生成多个解答,根据答案是否正确给予奖励。
这是一种常见训练流程,但不是所有模型都必须严格依次完成这三个阶段。
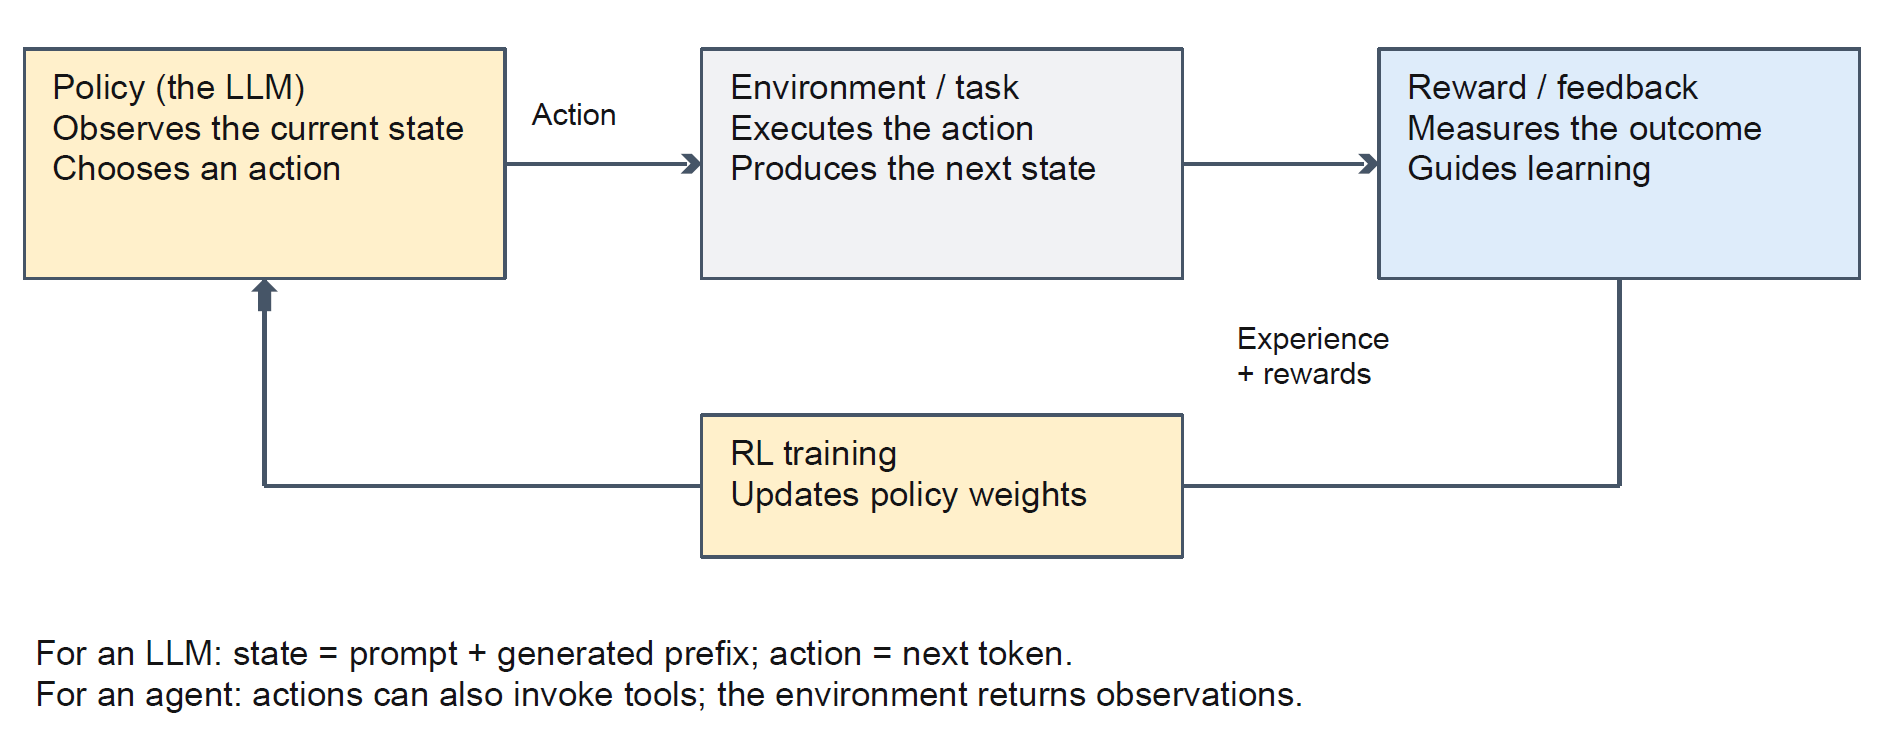
LLM 中的 RL 概念
| RL 概念 | 对应含义 |
|---|---|
| Policy | 正在训练的 LLM |
| State | Prompt + 已生成的内容 |
| Action | 下一个 token;对于 Agent,也可以是工具调用 |
| Environment | 执行动作并返回结果的任务环境 |
| Reward | 对回答或任务结果的评价 |
RL 不需要为每一步提供标准答案,但需要某种评价结果的信号。
奖励可以来自:
- RLHF:根据人类偏好训练 reward model,再用它评价回答。
- Verifiable rewards:通过数学答案检查、代码测试或任务成功条件获得奖励。
2. PPO 与 GRPO 的计算流程(p7–10)
2.1 PPO-based RLHF(p7)
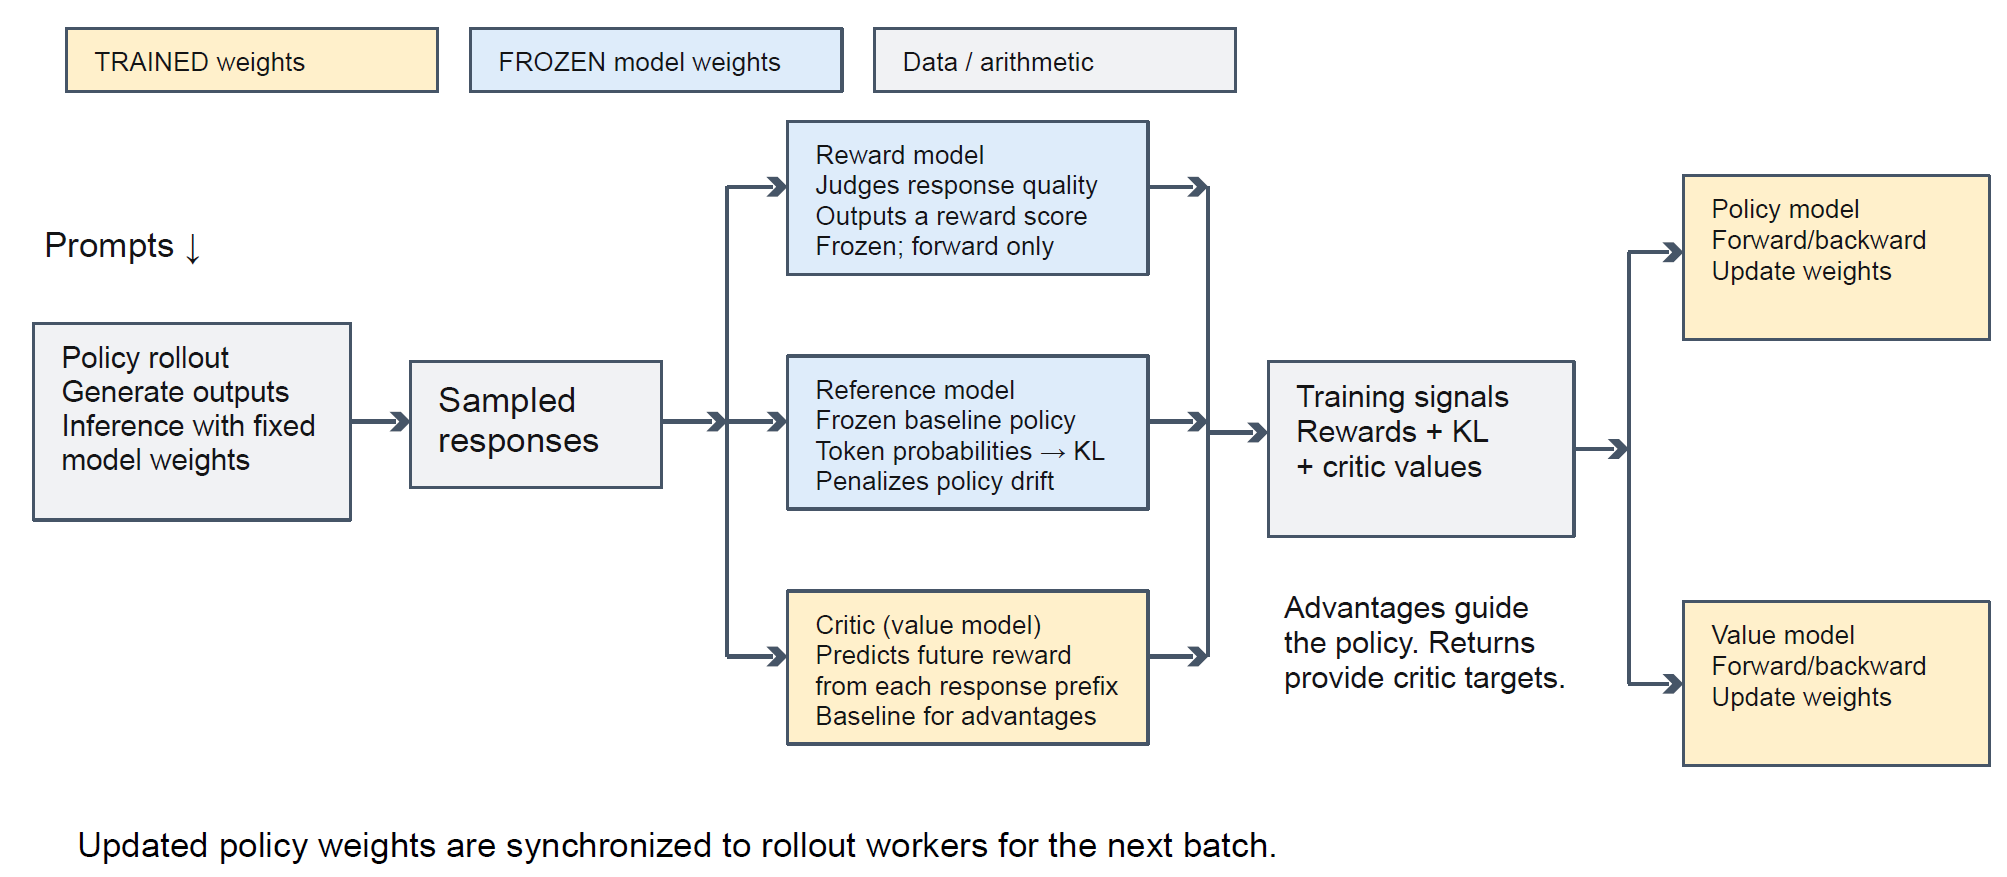
一次迭代的主要过程:
输入 prompts → 生成回答 → 评分与估值 → 计算训练信号 → 更新模型 → 同步参数。
通常涉及四个模型:
| 模型 | 作用 | 是否更新参数 |
|---|---|---|
| Policy / Actor | 生成回答,也是训练目标 | 是 |
| Reward model | 评价回答质量 | 通常冻结 |
| Reference model | 提供参考概率,通过 KL 惩罚限制策略偏离 | 冻结 |
| Critic / Value model | 预测从当前状态继续下去能获得的奖励 | 是 |
Advantage 表示:实际结果比预期好多少。
例如,Critic 预计只能获得 0.3 分,但最终获得了 1 分,说明这次行为优于预期,应提高它的概率。
Reference model 则用于限制策略偏离,避免模型只追逐奖励而发生过大的行为变化。
2.2 GRPO:用组内比较代替 Critic(p8–10)
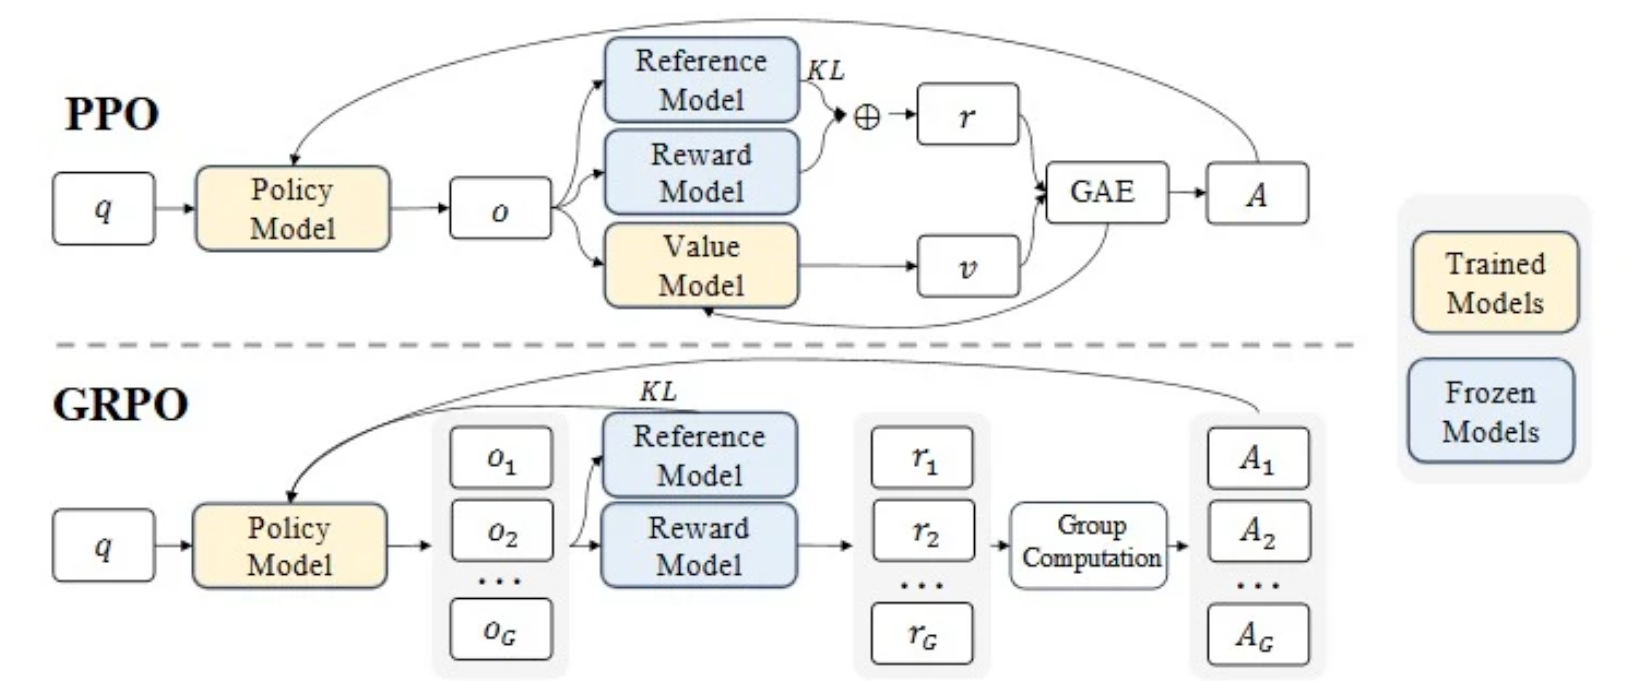
GRPO 为同一个 prompt 生成多个回答,根据组内奖励计算相对优势。
例如:
- 同一道题生成四个回答。
- 奖励为
[1, 0, 1, 0]。 - 平均奖励为
0.5。 - 正确回答高于平均水平,获得正 advantage。
- 错误回答低于平均水平,获得负 advantage。
简化表示为:
一个 group 是同一道题的多个回答,不是不同题目的回答混在一起。
系统上的变化:
- 不需要训练 Critic,减少相关训练与显存开销。
- 每题需要生成多个回答,rollout 成本可能增加。
- 生成阶段因此成为重要的优化对象。
3. 为什么 RL 是复杂的系统问题?(p11–23)
3.1 RL 是分布式 Dataflow(p11–14)
RL 需要协调:
生成回答 → Reward / Reference 等计算 → 组织训练数据 → 参数更新 → 参数同步。
这些环节中的每一个,都可能是跨多张 GPU 的分布式程序。
因此,系统需要同时处理:
- 模型内部的分布式计算。
- 不同模型之间的数据传输。
- 不同阶段之间的执行依赖。
- GPU 和显存的分配。
VeRL 等框架的作用,就是组织和执行这样的 RL workflow。
3.2 Rollout 是训练的重要成本(p15–20)
Rollout 指使用当前策略生成训练所需的回答或交互轨迹。
RL 不只是 backward 和参数更新,还要先通过 inference 生成数据。
GRPO 为同一个问题生成多个回答,使 rollout 的成本更加突出。
3.3 RL rollout 的特殊性质(p21–23)
| 性质 | 系统上的影响 |
|---|---|
| 请求成批到达 | 可以提前组织和调度 |
| 同一道题有多个回答 | 可以利用共享前缀 |
| 回答长度差异很大 | 少数长回答可能拖住整批任务 |
| 题目跨训练迭代重复出现 | 可以利用历史信息和缓存 |
| 模型参数持续更新 | 需要处理参数同步与数据过时 |
| Agent 调用工具和环境 | 瓶颈可能位于 GPU 之外 |
普通 serving 的优化可以用于 rollout,但还必须考虑其对训练质量和收敛的影响。
4. Rollout 与 Training 的同步(p24–37)
4.1 两类同步障碍(p25)
| Barrier | 含义 |
|---|---|
| Pipeline barrier | Rollout 与 Training 两个阶段互相等待 |
| Batch barrier | 同一批 rollout 中,短请求等待最长请求 |
这是两个不同的问题,需要分别优化。
4.2 方案一:分开部署,顺序执行(p26)
Rollout 和 Training 使用不同的 GPU,但执行顺序仍然是:
Rollout 完成 → Training → 下一轮 Rollout。
问题:
- 生成时,训练 GPU 可能闲置。
- 训练时,生成 GPU 可能闲置。
资源分开部署,不代表阶段之间已经实现重叠。
4.3 方案二:Colocation,共用 GPU(p27–29)
同一组 GPU 轮流进行生成和训练。
好处是减少不同阶段专用资源的闲置,但存在切换成本。
| 阶段 | 需要的主要状态 |
|---|---|
| Training | Weights、gradients、optimizer states |
| Rollout | Weights、KV cache |
阶段切换可能涉及:
- 搬移和恢复模型状态。
- 释放与重新分配显存。
- 重新捕获 CUDA Graph。
因此,GPU 虽然可以被两个阶段轮流使用,但切换本身也可能耗时。
4.4 为什么生成与训练适合不同资源?(p30)
| Training | Rollout |
|---|---|
| 已知整段 token,可并行计算各位置 | 自回归生成,逐 token 推进 |
| 主要执行大矩阵运算和反向传播 | 反复读取权重和 KV cache |
| 看重计算能力和 GPU 间通信 | Decode 经常受显存带宽和容量限制 |
| 扩容可能受梯度同步等限制 | 可增加独立模型副本提高吞吐 |
因此,两个阶段适合分别选择 GPU 数量、硬件和并行配置。
4.5 方案三:分开部署并重叠执行(p31–33)
Rollout 和 Training 使用不同资源,并同时工作。
Trainer 更新参数时,rollout workers 继续生成数据。
这样可以减少空闲,但会产生 stale rollouts。
例如:
- 某条轨迹由第 9 版模型开始生成。
- 生成完成时,Trainer 已经更新到第 12 版。
- 训练数据来自旧策略,而当前优化的是新策略。
这会带来采样分布不匹配。
4.6 Importance sampling 与 clipping(p32–33)
Importance sampling 使用概率比值修正新旧策略之间的差异:
其中:
- :生成数据的旧策略。
- :当前策略。
但长回答的概率比值可能具有很高方差,因此实践中通常还需要限制 staleness,并采用 clipped surrogate。
p33 区分了两个作用:
| 机制 | 解决的问题 |
|---|---|
| Sampling correction | 修正数据来自旧策略的分布差异 |
| PPO clipping | 限制当前策略更新的幅度 |
修正旧数据偏差,与限制新策略更新,是两件不同的事。
4.7 Batch barrier 与 Partial rollout(p34–35)
假设一批有 100 个回答:
- 99 个已经生成结束。
- 最后一个还在生成。
- 严格同步要求整批等待。
这会产生 decoding long tail。
Partial rollout 解耦采样批次与训练批次:
持续生成,并从已经完成的结果中组织训练数据,不要求同批启动的请求一起结束。
好处:
- 减少等待。
- 提高 GPU 利用率。
- 缓解长请求对训练进度的阻塞。
代价:
- 训练 batch 可能混合不同采样时期的数据。
- 长短请求可能具有不同程度的参数滞后。
- 数据分布控制更加复杂。
4.8 吞吐量与策略滞后的关系(p36)
在简化的固定并发模型中,定义:
| 符号 | 含义 |
|---|---|
| 同时生成的请求数 | |
| 一个训练 batch 的回答数 | |
| 回答长度 | |
| 生成一个 token 所需的时间 |
近似有:
平均参数滞后近似为:
直观理解:
并发越高,生成数据越快,但一个请求完成期间也可能经历更多次模型更新。
这些关系依赖 PPT 中的稳态与简化假设;实际系统还会受到训练速度、负载变化和工具执行等因素影响。
4.9 不要只关注 Decode(p37)
Agentic rollout 可能包含:
生成代码 → 执行测试 → 读取结果 → 修改代码。
因此,输出长度只能在 decode 占主导时作为成本代理。
如果工具执行很慢,继续优化 token 生成也未必能显著缩短整条轨迹。
5. 减少长尾:Speculative Decoding(p39–45)
5.1 为什么关注长尾?(p40)
少数特别慢的 rollout 可能占据整批任务最后很长一段时间。
可以选择:
- 提高整个 batch 的吞吐量。
- 专门加速决定整批完成时间的 stragglers。
5.2 Speculative decoding 的基本思路(p43)
Drafter 提出多个候选 token → 目标模型并行验证 → 接受符合条件的部分。
目标是减少目标模型逐 token 解码所需的串行步骤。
实际收益取决于:
- 候选 token 的接受率。
- Drafter 的开销。
- 目标模型的验证成本。
5.3 按请求特点分配加速预算(p42–45)
PPT 中 DAS 的核心思路是:
不要平均分配 speculation 预算,而要考虑哪些请求更可能形成长尾。
例如:
- 一个即将完成的短回答,继续加速对整批完成时间帮助有限。
- 一个预计还要生成很久的回答,更值得分配加速资源。
注意区分两种验证:
| 验证类型 | 验证内容 |
|---|---|
| Speculative decoding verification | 候选 token 是否符合目标模型的采样机制 |
| Reward evaluation | 回答是否正确、有用或满足任务要求 |
Speculative decoding 本身不负责判断答案是否正确。
6. Agentic RL:环境也需要扩展(p46–55)
6.1 Agentic rollout 是多轮交互(p46–48)
普通文本 rollout 主要生成一段回答。
Agentic rollout 则可能是:
生成代码 → 运行代码 → 读取错误 → 修改代码 → 再次运行 → 完成任务。
因此,一条轨迹包含多次 LLM 调用和工具执行。
系统瓶颈可能从 GPU 转移到 CPU、内存、文件系统或沙箱。
6.2 Agentic RL 的挑战(p49–51)
| 类别 | 挑战 |
|---|---|
| Systems | 重复调用多、上下文长、环境内存开销大 |
| Machine learning | 奖励不稳定、异常或分布外工具调用 |
| Security | 环境逃逸、reward hacking |
同一道题需要采样多条轨迹,意味着可能需要同时运行大量相似但隔离的环境。
这些环境不仅需要快速启动,还需要保留每条轨迹执行过程中的状态。
6.3 ArborRL 的三个优化方向(p52–55)
Memory deduplication
多个 rollout 从同一个 workspace 状态分叉。
利用 Copy-on-Write:
- 初始时共享相同内存页。
- 某个分支修改页面时,才复制该页面。
- 避免每条轨迹都完整复制一份环境。
Tool-prefix caching
不同轨迹可能执行相同的工具前缀:
打开项目 → 安装依赖 → 运行初始测试。
系统缓存这段执行后的 workspace 状态,让后续轨迹直接复用。
缓存的是环境执行后的状态,而不仅是工具输出文本。
Speculative tool execution
根据之前训练迭代中反复出现的工具调用,提前在隔离分支中执行可能需要的操作。
- 预测命中时,复用已完成的执行。
- 预测未命中时,仍需按实际路径执行。
6.4 为什么 RL 适合这些优化?(p54–55)
RL 中存在多种重复:
- GRPO 对同一问题采样多个回答。
- 同一问题跨训练迭代重复出现。
- 相邻迭代的策略行为具有相似性。
- 不同轨迹可能共享工具调用前缀。
这些重复为缓存、共享状态和推测执行提供了机会。
7. 全课需要掌握的三组权衡(p56)
| 优化方向 | 主要收益 | 需要处理的问题 |
|---|---|---|
| Rollout 与 Training 重叠 | 减少 GPU 闲置 | Stale rollouts 与采样偏差 |
| 解耦采样与训练 batch | 减少长尾等待 | 数据分布和参数滞后差异 |
| 共享、缓存、推测环境执行 | 降低 Agent rollout 成本 | 状态复用正确性与分支隔离 |
重点页:
- p7–10:PPO 与 GRPO 的计算流程。
- p25:Pipeline barrier 与 Batch barrier。
- p30:Training 与 Rollout 的资源需求差异。
- p31–35:异步执行、staleness 与 partial rollout。
- p52–55:Agentic RL 中的环境共享、缓存和推测执行。