Lesson 9-10- Self-Attention and Transformer
Encoder
上一讲的 Seq2Seq + Attention 让 decoder 可以直接读取原句里的任意位置。这一讲把同样的思想用在原句内部,让每个 token 直接读取同一句里的其他 token,从而去掉 encoder 里的 RNN。
| PPT 页码 | 章节 | 核心问题 |
|---|---|---|
| 1–5 | Recap and Motivation | 已经有 Attention,为什么还要改 Encoder? |
| 6–12 | Self-Attention and Q/K/V | 一个 token 怎么决定向谁读、读什么? |
| 13–18 | Matrix Form and Complexity | 怎么让所有 token 同时算?代价是什么? |
| 19–23 | Scaled Dot-Product Attention | 为什么要除以 ? |
| 24–28 | Multi-Head Attention | 一个 token 怎样同时读取多种上下文? |
| 29–34 | Feed-Forward Network | Attention 混合了上下文,为什么还需要 FFN? |
| 35–38 | Residuals and Encoder Block | 怎么把这些组件组成可堆叠的 Encoder? |
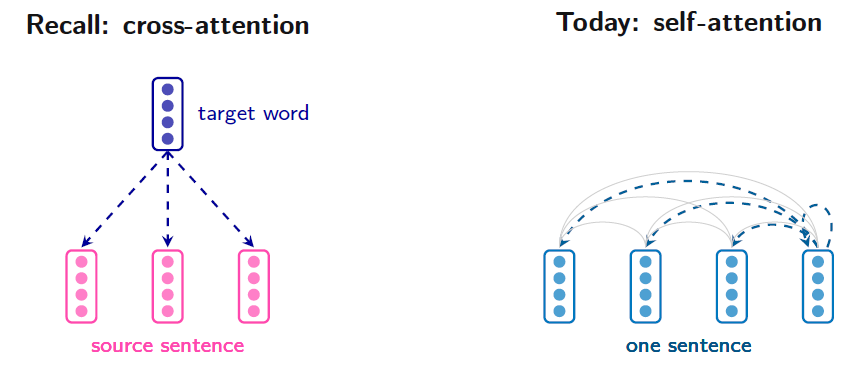
上一讲先介绍了 Vanilla Seq2Seq。RNN encoder 把整句压进一个向量,decoder 用这个向量生成译文。句子越长,需要塞进这个向量的信息越多,这就是 single-vector bottleneck。
加入 Cross-Attention 后,encoder 保留每个位置的 hidden state,decoder 每生成一个词都能直接读取当前最相关的 source positions。原句内部的表示仍然由 RNN 按顺序计算。
以课件里的句子为例:
Astronomers study celestial bodies.
在单向 RNN 里,计算 bodies 的 hidden state 要先等 celestial 的 hidden state。换成 LSTM 后,cell state 可以让信息更容易沿序列保留,每个时间步仍依赖前一步。
Self-Attention 改变了位置之间传递信息的路线。 在 encoder 中,bodies 可以直接读取 celestial,而 study 可以同时读取前面的 Astronomers 和后面的 bodies。每个位置都能并行构造自己的上下文表示。
2. Self-Attention 和 Q/K/V(第 6–12 页)
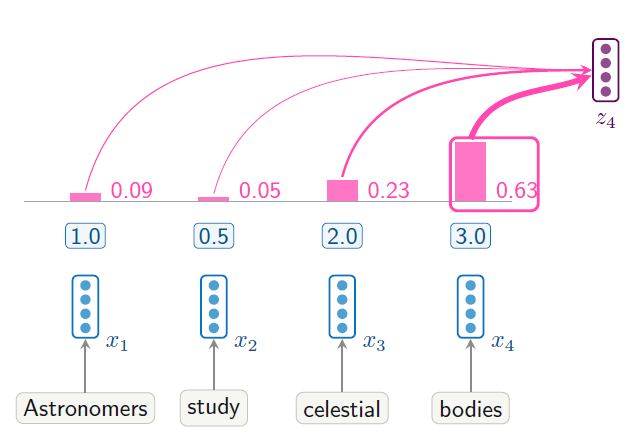
最简单的 Attention 分三步。
- Score。把 bodies 的输入向量与句中每个词的输入向量做 dot product。
- Normalize。对这些分数做 Softmax,得到一行总和为 1 的权重。
- Aggregate。按权重对各词向量做加权求和,得到 bodies 的新表示。
第 8 页的示例里,bodies 给自己 0.63,给 celestial 0.23。这里同一个输入向量同时负责发起查询、接受匹配、提供内容。第 9 页把三个角色拆开。
2.2 Query、Key、Value 各自投影(第 9–11 页)
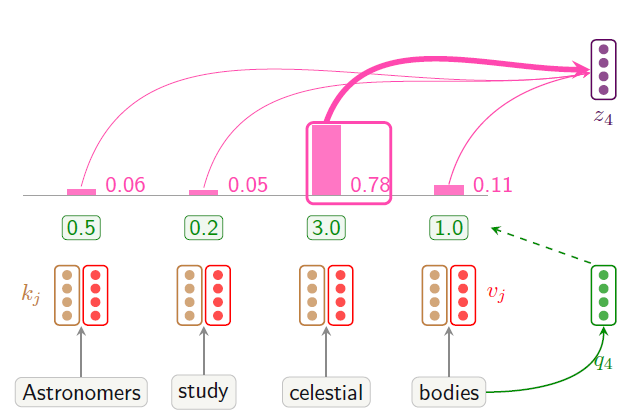
| 角色 | 计算 | 直觉 |
|---|---|---|
| Query | 我想找什么?bodies 可能想找能确定词义的修饰语。 | |
| Key | 别人凭什么找到我?celestial 的 Key 可能匹配这种查询。 | |
| Value | 找到我后能读到什么?celestial 的 Value 提供用于更新表示的信息。 |
Query 和 Key 决定读多少,Value 决定读到什么。 对位置 ,计算如下。
第 11 页的示例中,celestial 的权重从 0.23 提高到 0.78,bodies 自身的权重从 0.63 降到 0.11。可以把 Query 想成搜索词、Key 想成用于匹配的索引、Value 想成搜索返回的内容。
2.3 Self-Attention 和 Cross-Attention(第 12 页)
| 类型 | Query 来自 | Key 和 Value 来自 |
|---|---|---|
| Encoder Self-Attention | 输入序列 | 同一条序列,各位置可以读前后 token |
| Encoder–Decoder Cross-Attention | Decoder 表示 | Encoder 输出 |
| Causal Self-Attention(联系现代 LLM) | 当前序列 | 同一条序列,mask 限制每个位置只能读自己及之前的位置 |
GPT 类 decoder-only LLM 用 Causal Self-Attention 做 next-token prediction。它和本讲的 Encoder Self-Attention 共享 Q/K/V 的计算方式,读取范围由 attention mask 决定。
3. 矩阵形式与复杂度(第 13–18 页)
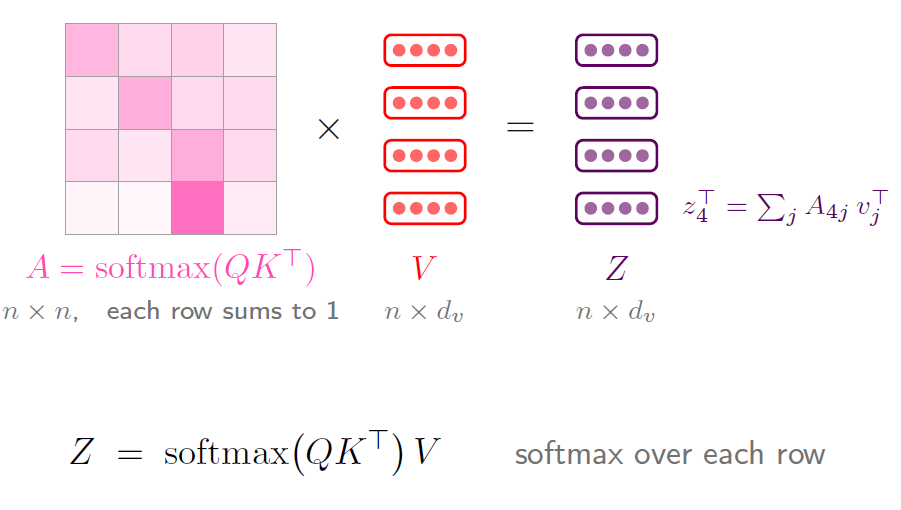
把句中的 个输入向量按行排成 ,就可以一次算完所有位置。
| 矩阵 | Shape | 一行对应什么? |
|---|---|---|
| 一个 token 的输入表示 | ||
| 一个 token 的 Query 或 Key | ||
| 一个 token 的 Value | ||
| 一个 Query 对所有 Key 的分数 | ||
| 一个 Query 的读取权重 | ||
| 一个 token 更新后的表示 |
第 15–16 页容易弄混的是行和列。 表示位置 读位置 的权重。第 4 行是 bodies 在读谁,第 4 列是各个位置分别从 bodies 读多少。Softmax 按行算,因为每个 Query 都有自己的权重分布。
第 17–18 页比较了两种计算路线。
- RNN 沿序列有 个依赖步骤,两个远处位置之间可能隔着许多次状态更新。
- Full Self-Attention 让所有位置并行计算,任意两个位置在一层内就可以直接交换信息。每个 head 要考虑 个位置对,序列长度翻倍时,位置对数量变为四倍。
课件把 Attention 的核心计算简写成 。如果算上常见的 Q/K/V 和输出投影,还有 的开销。前者随序列长度呈平方增长,后者呈线性增长。
4. Scaled Dot-Product Attention(第 19–23 页)
4.1 Softmax 为什么会饱和?(第 19–20 页)
课件把同一行分数全部乘 10。
| 分数 | celestial 的权重 |
|---|---|
| 约 0.78 | |
| 约 1.00 |
排名一样,权重分布却接近 one-hot。此时,小幅改动分数对权重的影响很小。
当 接近 0 或 1 时,这个梯度接近 0。通过 attention weights 传回 Q/K 打分的梯度也会变小,模型更难调整自己在看谁。
4.2 为什么除以平方根?(第 21–23 页)
Dot product 是 个乘积相加。按课件的简化假设,分量相互独立、均值为 0、方差为 1,每个乘积的方差也是 1。
总和的方差随 增大,典型波动幅度随 增大。因此除以 ,可以把 logits 的量级控制在较稳定的范围。比如 ,缩放因子就是 8。
Scaling 控制 logits 的尺度。Softmax 把每个 Query 的分数转换成总和为 1 的权重。
5. Multi-Head Attention(第 24–28 页)
第 25–26 页换成了动词 study。它既需要知道谁在研究,也需要知道研究什么。单个 head 可以同时给 Astronomers 和 bodies 高权重,但两份内容会在加权求和时混到同一个向量里。多个 head 可以各自形成一套权重,先保留各自的读取结果,再融合。
| 步骤 | 、 时的计算 |
|---|---|
| Per-head projection | 每个 head 有自己的 ,每个 head 的宽度为 64 |
| Per-head attention | 每个 head 给每个 token 输出一个 64 维向量 |
| Concatenate | 把 8 份结果拼回 512 维 |
| Output projection | 用 学习怎么融合各 head,输出保持 512 维 |
“一个 head 找主语,另一个找宾语”是帮助理解的例子。实际各 head 的分工由训练决定。
第 28 页指出,固定总宽度 后,每个 head 使用 维。Q/K/V 权重合计仍是 ,加上输出投影的 ,共 ,这里忽略 bias。拆成多头的作用是在同样的总宽度下获得多套独立的打分分布。
6. Feed-Forward Network(第 29–34 页)
6.1 Attention 混合信息,FFN 加工信息(第 30–31 页)
给定权重后,单个 head 的输出 是 Value 向量的 weighted average。因为权重非负且和为 1,结果在这些 Value 的 convex hull 内。这个几何解释对应单个 head 的聚合步骤。Attention 整体对输入仍有非线性,因为权重也由输入计算出来。
接下来,每个 token 单独经过同一个 position-wise FFN。各位置共享参数,但输入各自不同。
课件使用 。例如 。扩张给非线性变换更多中间维度,缩回 使输出可以继续送进下一层。
6.2 为什么要加非线性?(第 32–33 页)
把 bodies 收到的上下文简化成两项混合, 代表 celestial 信息的占比。纯线性 readout 随 的变化只能画出一条直线。用两条分别在 0.45 和 0.55 开始上升的 ReLU 相减,就能构造出一个类似阈值的特征。
| 的范围 | 的行为 |
|---|---|
| 保持 0 | |
| 从 0 逐渐升到 1 | |
| 保持 1 |
这个例子把混合的上下文转换成类似“这里的 bodies 指天体”的特征。课件用 ReLU 画清楚折点,再引入较平滑的 GELU。
7. Residuals 和完整的 Encoder Block(第 35–38 页)
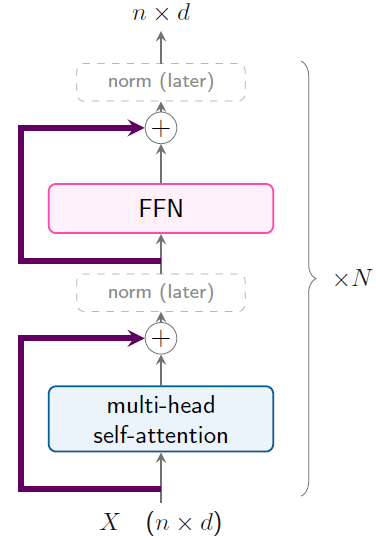
Self-Attention 缩短了 token 之间的路径。把多个 block 堆起来后,梯度仍要沿网络深度传播。第 36 页用 Residual Connection 为每个子层提供一条加法通路。
来自直接保留输入的支路,让梯度能沿这条局部通路绕过 。LSTM 的 cell state 也用到加法来保留信息,不过它沿序列时间步传递,而 Transformer 的 residual stream 沿网络深度传递。
第 37 页画了两条 residual,每个 sublayer 各一条。按图中的顺序读:
| 顺序 | 对 bodies 的表示做什么? |
|---|---|
| Multi-Head Self-Attention | 从 celestial 等位置读取上下文 |
| Residual Add + Norm | 把 Attention 的更新加回原表示,再做 normalization |
| Position-wise FFN | 在 bodies 自己的位置上加工更新后的表示 |
| Residual Add + Norm | 加回 FFN 的更新并做 normalization,送给下一层 |
整个 block 的输入和输出都是 ,所以可以继续堆叠。课件把 Normalization 的细节和 Positional Encoding 留到后面。能够读到整句与知道词的先后次序,是两个不同的问题。
Decoder
Lecture 9 讲了 Encoder Block 的三个组件:Self-Attention 让 token 交换信息,FFN 加工每个 token 的表示,Residual Connection 把更新加回原表示。
Lecture 10 把剩下的问题补齐:怎么控制每层输入的尺度?Decoder 怎么训练时并行、生成时逐个输出?Attention 怎么知道词序?这些设计又是怎么演变到现代 LLM 的?
| PPT 页码 | 章节 | 核心问题 |
|---|---|---|
| 1–6 | Recap and Motivation | 上一讲的 Encoder 还缺什么? |
| 7–12 | LayerNorm, RMSNorm, Pre-Norm | 怎么控制向量尺度?Normalization 放在哪? |
| 13–20 | Autoregressive Decoder | 为什么训练能并行,生成却要逐个 token 来? |
| 21–24 | Full Transformer and Cross-Attention | Decoder 怎么读取 Encoder 的输出? |
| 25–31 | Positional Information | Attention 怎么区分 dog bites man 和 man bites dog? |
| 32–37 | Results and Modern LLMs | 原始 Transformer 表现如何?LLaMA 3 改了什么? |
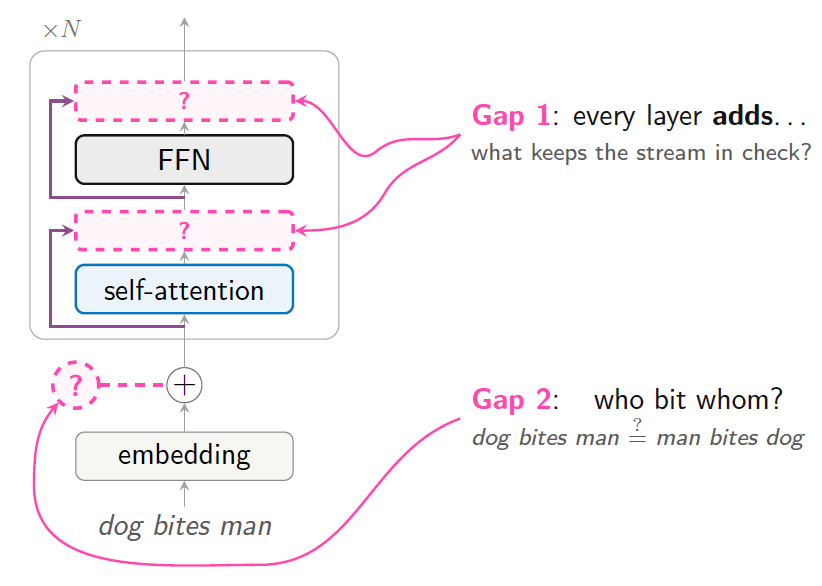 |
复习了上一讲的 Q/K/V、Scaled Dot-Product Attention、Multi-Head Attention、FFN 和 Residual Connection。这里有两个问题:
- Scale。每个子层都把更新加到 residual stream 上。网络堆深后,向量的尺度可能发生变化,后面的层会收到尺度不同的输入。
- Word Order。如果每个输入向量只表示词本身,那么
dog bites man和man bites dog只是把相同的三个向量重新排列。模型还需要知道谁在前、谁在后。
第一个问题引出 Normalization,第二个问题引出 Positional Information。
2. LayerNorm、RMSNorm 与 Pre-Norm(第 7–12 页)
2.1 为什么上一讲的 Scaling 还不够?(第 8 页)
上一讲除以 ,是为了控制 dot product 随 head dimension 增长带来的尺度变化。本讲讨论的是另一件事:输入向量本身的幅度可能随网络深度变化。
如果输入放大 倍,在线性投影的简化情况下,Query 和 Key 都会放大 倍,于是 放大 倍。此时 没变,除以 的因子也没变。过大的 logits 仍可能让 Softmax 接近 one-hot。
2.2 LayerNorm 沿哪个维度算?(第 9–10 页)
对一个 token 的表示 ,LayerNorm 沿这个 token 自己的 feature dimensions 计算均值和方差。如果输入是 的矩阵,就逐行处理。
- Center。减均值,让各维度的均值变为 0。
- Normalize。除以标准差,让各维度的方差约为 1。 用于数值稳定。
- Rescale and shift。用可学习的 逐维缩放和平移。
第 10 页的例子是 。减均值得到 ,除以标准差 后得到约 。这里算的是同一个 token 的三个坐标。
2.3 RMSNorm 和 LayerNorm 差在哪?(第 11 页)
RMSNorm 用 root mean square 控制幅度,省去减均值和加 的步骤。
| 方法 | 减均值 | 用什么做缩放 | 可学习参数 |
|---|---|---|---|
| LayerNorm | 是 | Standard deviation | |
| RMSNorm | 否 | Root mean square |
当输入均值恰好为 0 时,RMS 等于标准差。对于 这样的正值向量,RMSNorm 的归一化步骤会把它整体缩小,各坐标仍为正。LayerNorm 的归一化步骤则会把中间的 4 移到 0。
2.4 Pre-Norm 和 Post-Norm 差在哪?(第 12 页)
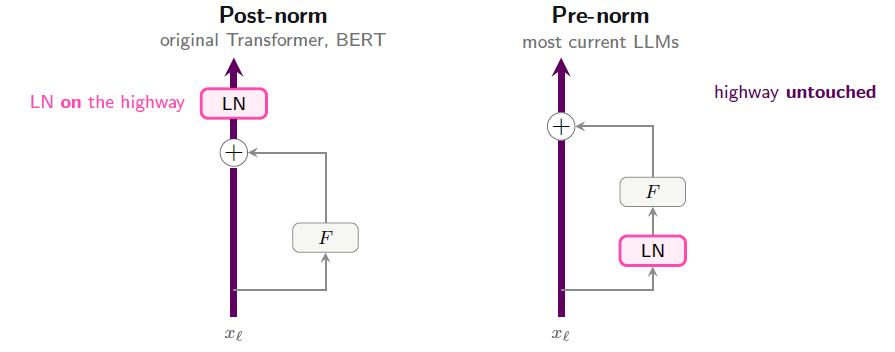
令 代表 Attention 或 FFN。
Post-Norm 先把更新加回去,再归一化整个结果。Pre-Norm 先归一化送进子层的输入,再把子层算出的更新加回原始 。
看第 12 页的图时,沿着 residual shortcut 走一遍。Pre-Norm 的 shortcut 直接经过加法,梯度在这条支路上有一个 identity 项。课件用这点解释,为什么 Pre-Norm 更便于训练深层网络。
3. Decoder 怎么做到训练并行、生成串行?(第 13–20 页)
3.1 Teacher Forcing 与目标右移(第 14–16 页)
假设原句是 le chat dort,目标译文是 the cat sleeps。训练时我们已经知道正确译文,可以把它构造成一组错开一个位置的 decoder inputs 和 targets。
| Decoder 输入位置 | 该位置应该预测 | 允许读取的目标前缀 |
|---|---|---|
<s> | the | <s> |
the | cat | <s> the |
cat | sleeps | <s> the cat |
sleeps | </s> | <s> the cat sleeps |
Teacher Forcing 指训练时给模型真实前缀。the 所在位置负责预测 cat,但完整输入的下一个位置恰好就放着 cat。如果直接用双向 Self-Attention,这一行就能偷看到自己的训练标签。
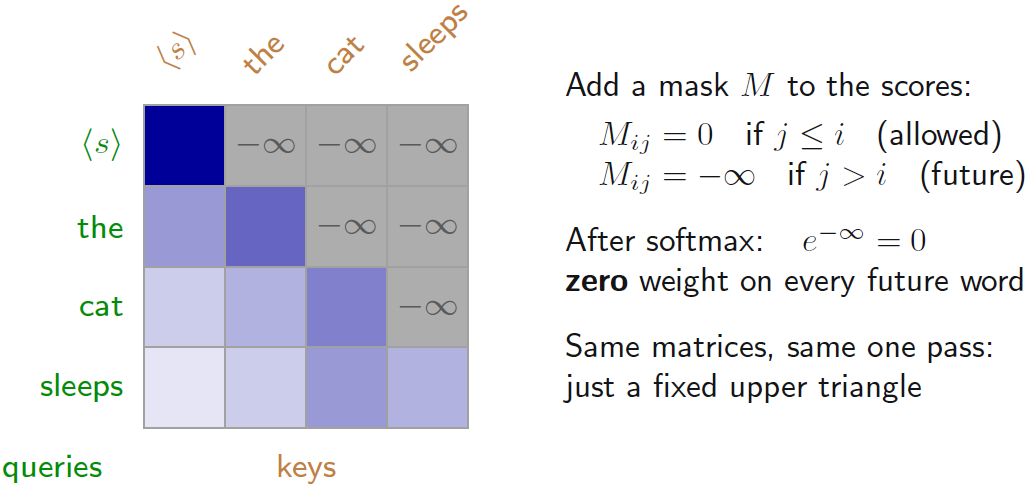
3.2 Causal Mask 怎么挡住未来?(第 18 页)
对于第 个 Query 和第 个 Key,先在 attention logits 上加一个 causal mask。
矩阵右上三角对应未来位置,加上 后,这些位置的 Softmax 权重变成 0。对角线保留,因为当前位置的输入是已经给定的 token,该位置要预测的是下一个 token。
3.3 一次训练 forward 等于算了哪些预测?(第 15–20 页)
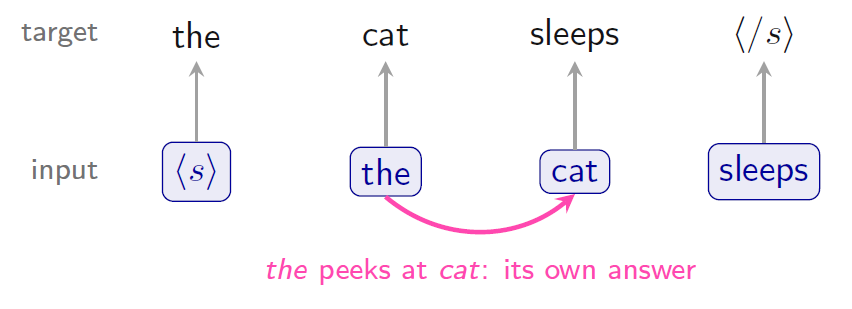
- Training。完整目标序列已知,因此所有位置可以在同一次 forward pass 里计算。Causal mask 保证每个位置只依赖允许的真实前缀。把第 个位置单独拿出来,它使用的信息和只输入该前缀时相同。
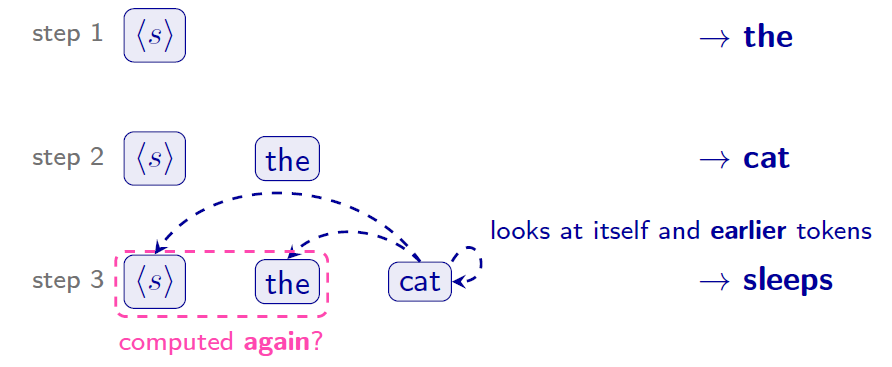
- Generation。先输入
<s>生成the,再用<s> the生成cat,然后才能用<s> the cat生成sleeps。后一步要等前一步选出 token。
- KV Cache。生成新 token 时,causal mask 保证旧位置的表示不会受未来 token 影响,因此可以缓存旧 token 在各层的 Key 和 Value。新 token 算出自己的 Query 后,可以直接读取缓存的 K/V。
这就是之前讲的 next-token prediction:
这里的 是翻译任务的源句, 是目标前缀。训练时模型看到的前缀来自标准译文,生成时来自它自己的输出。如果模型先把 the cat 生成成了 the dog,后续就得在这个已经偏离的前缀上继续预测。这种训练与推理时的前缀分布差异通常叫 Exposure Bias。
4. 完整 Transformer 与 Cross-Attention(第 21–24 页)
4.1 一个 Decoder Block 有三个子层(第 22 页)
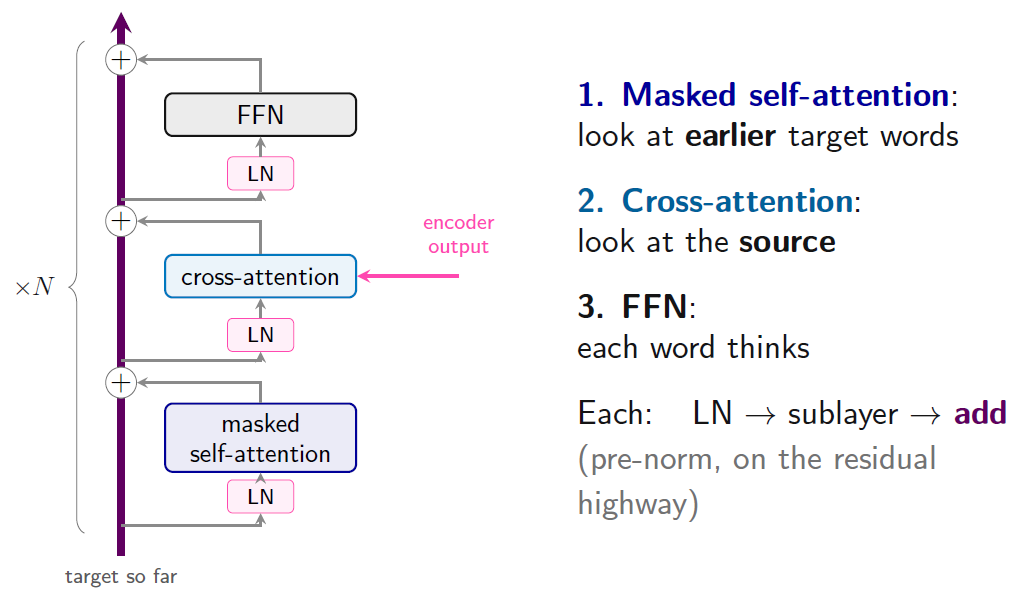
| 子层 | 读什么? | 在翻译例子里做什么? |
|---|---|---|
| Masked Self-Attention | 当前及之前的目标 token | 在 the cat 上下文中理解当前状态 |
| Cross-Attention | Encoder 输出的源句表示 | 从 le chat dort 读取相关信息 |
| Position-wise FFN | 当前位置的向量 | 加工读到的信息,供后续层或输出层使用 |
第 22 页用 Pre-Norm 图示,每个子层的计算顺序是 Norm → Sublayer → Residual Add。第 35 页把 Post-Norm 列为 2017 年原始 Transformer 的配置。看架构图时,可以把“有哪些子层”和“Norm 放在哪”分开记。
4.2 Cross-Attention 的 Q/K/V 来自哪里?(第 23–24 页)
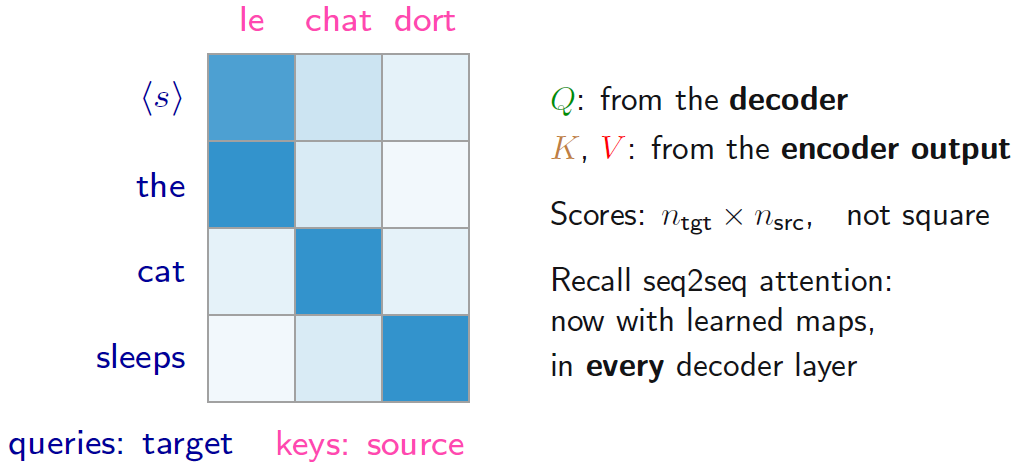
- Q 来自 Decoder。当前的目标位置想从源句中找什么?
- K、V 来自 Encoder。源句中哪些位置匹配?匹配后读到什么信息?
如果目标长度是 ,源句长度是 ,那么 Cross-Attention 的分数矩阵形状是:
一行对应一个目标位置,一列对应一个源位置。比如译文已经生成了 the cat,此时 Decoder 可以从源句中的 dort 读取信息,帮助预测 sleeps。
Causal mask 限制的是目标序列内部能读到哪些位置。 在这类翻译任务里,整条源句已经给定,所以 Cross-Attention 可以读取源句的任意有效位置。
5. Attention 怎么知道词序?(第 25–31 页)
5.1 Permutation Equivariance(第 26 页)
考虑课件里的两句话:
dog bites man
man bites dog
在没有位置输入的 full self-attention 中,把输入行重排,输出也会按同样的顺序重排。这叫 Permutation Equivariance。
比如把 dog 从第一位换到第三位,模型仍会给 dog 算一个输出,但它看到的词向量集合没有变,属于 dog 的输出内容也只会跟着搬位置。课件用 bag of words 帮你记这一点。这里仍然是每个位置输出一个向量,重排输入会对应重排输出。
5.2 Absolute Position:把位置加到输入里(第 27–28 页)
- Learned Positional Embedding。为每个位置学习一个向量 。训练好的表定义了可查的位置范围。
- Sinusoidal Positional Encoding。用不同频率的 sine 和 cosine 生成 。同一位置从多条波形上各取一个值,拼成位置向量。公式可以继续生成更远位置的向量,模型在那些长度上能否泛化还要看实际表现。
加上位置后,同一个 dog 在第一位和第三位会得到不同的输入向量,Attention 就有了可用的词序线索。
5.3 ALiBi:直接给远处位置扣分(第 29 页)
ALiBi 在 causal attention 的 logits 里加入一个和距离成正比的惩罚。对允许读取的位置 :
假设两个 Key 的内容匹配分数一样,一个在 Query 前 1 个位置,另一个在前 5 个位置。距离更远的那个会多扣 ,因此默认权重更低。如果远处的内容匹配明显更强,它仍然可以获得更高权重。不同 head 有不同斜率,可以形成不同的距离偏好。
5.4 RoPE:把相对距离放进 Dot Product(第 30 页)
Rotary Positional Embedding 对 Query 和 Key 的坐标对做旋转。先看一对二维坐标:
- 位于 的 Query 旋转 。
- 位于 的 Key 旋转 。
- 旋转不改变长度,两个向量的相对角度会改变 。
如果把两个位置同时往后移 10 格,它们的相对距离不变。对于给定的原始 ,旋转引入的位置项只依赖 。 实际上会对多对坐标使用不同旋转频率。RoPE 旋转 Q 和 K,Value 保持原样。
5.5 四种位置方法放在一起(第 31 页)
| 方法 | 位置在哪里进入计算? | Attention 怎么用到位置? |
|---|---|---|
| Learned Position | 加到输入 embedding | 输入包含绝对位置向量 |
| Sinusoidal Position | 加到输入 embedding | 不同频率的波形编码绝对位置 |
| ALiBi | 加到 attention logits | 显式惩罚较远的 token |
| RoPE | 旋转每层的 Q、K | Dot product 带有相对位置信息 |
6. 从 2017 Transformer 到现代 LLM(第 32–37 页)
第 34 页介绍了一项后续研究。在该研究的比较设置下,多数受测的架构改动没有带来明显收益。这也解释了为什么今天仍然能在 LLM 里看到 Attention、FFN 和 Residual Connection 组成的基本结构。
6.1 原始 Transformer 和 LLaMA 3
| 组件 | Transformer(2017) | LLaMA 3(课件对照) |
|---|---|---|
| 整体架构 | Encoder–Decoder | Decoder-only |
| Norm 的位置 | Post-Norm | Pre-Norm |
| Norm 的类型 | LayerNorm | RMSNorm |
| 词序 | 输入加 Sinusoidal Position | 每层对 Q/K 应用 RoPE |
| Attention heads | Multi-Head Attention | Grouped-Query Attention |
| FFN | ReLU FFN | SwiGLU,带门控的 FFN |
这里和翻译模型最直观的差别是,LLaMA 3 直接在同一条序列上使用 causal self-attention。Prompt 和已生成 token 都放在这条序列里,目标 token 可以通过 causal self-attention 读取它们。
6.2 Grouped-Query Attention(GQA)
Grouped-Query Attention(GQA) 保留多个独立的 Query head,让同组的 Query heads 共用一组 Key 和 Value。
| 方法 | Query heads 示例 | KV heads 示例 | 共享方式 |
|---|---|---|---|
| Multi-Head Attention(MHA) | 8 | 8 | 每个 Query head 有独立的 K/V |
| Grouped-Query Attention(GQA) | 8 | 2 | 每 4 个 Query heads 共用一组 K/V |
| Multi-Query Attention(MQA) | 8 | 1 | 所有 Query heads 共用一组 K/V |
共享 K/V 后,各个 Query head 仍可以得到不同的 attention weights,因为它们的 Query 向量不同。课件举的例子是 LLaMA 3 8B,有 32 个 Query heads、8 个 KV heads。在其他缓存维度和精度相同的情况下,KV Cache 占用是同配置 MHA 的四分之一。