Lesson 8-Machine Translation, Seq2Seq + Attention
主线:将 RNN Language Model 用于机器翻译,利用 Attention 解决信息瓶颈,再通过 Decoding 选出完整译文。
1. Machine Translation:机器翻译任务(P6–9)
Machine Translation 同时需要:
- Language analysis:理解源语言。
- Language generation:组织目标语言的表达。
因此,它是一个同时考验理解与生成能力的任务。
翻译不是逐词替换(P8)
PPT 的例子:
il a m’entarté → he hit me with a pie
翻译面临两个基本问题:
- Word order changes:不同语言的词序可能不同。
- Length mismatch:一个源语言词可能对应多个目标语言词。
所以,输入与输出的长度不必相同,也不能简单地对每个输入词独立分类。
训练数据:Parallel Corpus(P9)
Parallel corpus 是表达相同内容的双语句子对。
| Source:法语 | Target:英语 | |
|---|---|---|
| le chat dort | the cat is sleeping | |
| merci beaucoup | thank you very much | |
| où est la gare ? | where is the station? |
常见来源包括议会文件、联合国文件、电影字幕和翻译书籍。
与普通语言模型相比:
- 普通 LM:文本自身提供 next-token 标签。
- 机器翻译:源句是输入,对应译文提供目标 token 标签。
两者都可以通过 next-token prediction 训练,但翻译还需要学习源句与译文的对应关系。
3. Sequence-to-Sequence:Encoder–Decoder(P10–15)
3.1 翻译是 Conditional Language Modeling(P11)
普通语言模型建模:
机器翻译建模:
区别在于:预测下一个目标词时,除了看目标语言前文,还要考虑源句 。
因此,翻译仍然是 next-token prediction,只是增加了源句这个条件。
3.2 Encoder 和 Decoder 分别做什么?(P12)
基础 Seq2Seq 使用两个 RNN:
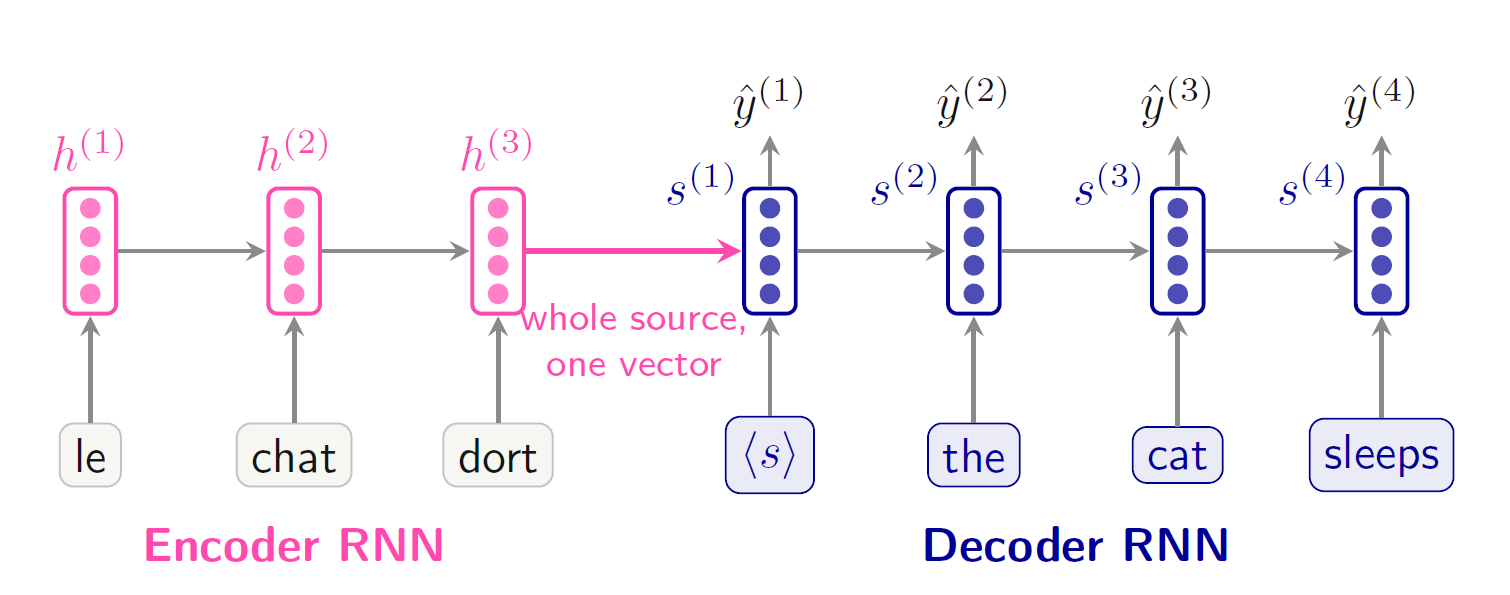
| 模块 | 输入 | 作用 |
|---|---|---|
| Encoder | 源句 le chat dort | 编码源句 |
| Decoder | 起始符及目标语言前文 | 逐步生成 the cat sleeps |
Encoder 依次读取源词,得到:
基础版本使用最后一个状态 初始化 Decoder。
Decoder 根据自身状态预测下一个词:
可以理解为:
Encoder 读完整句,将信息交给 Decoder;Decoder 再逐词写出译文。
Encoder 和 Decoder 可以使用 LSTM,两者各自拥有自己的参数。
3.3 训练:Teacher Forcing(P13)
训练时,Decoder 接收真实的上一个目标词。
| Decoder 输入 | 预测目标 |
|---|---|
<s> | the |
| the | cat |
| cat | sleeps |
| sleeps | </s> |
损失是目标序列的平均 negative log-likelihood:
其中,星号表示真实译文。
每个目标位置都有损失,梯度可以从 Decoder 传回 Encoder,整个模型端到端训练。
3.4 推理:输入自己生成的词(P14)
测试时没有真实译文,因此流程是:
- 输入
<s>,预测第一个词。 - 将生成的词作为下一个时间步的输入。
- 重复生成。
- 生成
</s>后停止。
训练与推理的区别:
- Training:读取真实的上一个词。
- Inference:读取自己生成的上一个词。
如果模型前面生成错了,后面就会基于错误前文继续生成。
3.5 Information Bottleneck:固定向量的瓶颈(P15)
基础 Seq2Seq 把源句信息都压进最后一个状态 。
例如:
- 3 个词的句子 → 一个 512 维向量。
- 50 个词的句子 → 仍然是一个 512 维向量。
句子越长,越难完整保存所有细节。
LSTM 可以缓解长期记忆问题,但固定大小向量的信息瓶颈仍然存在。
4. Attention:生成时回看源句(P16–23)
4.1 核心想法:保留全部源状态(P17)
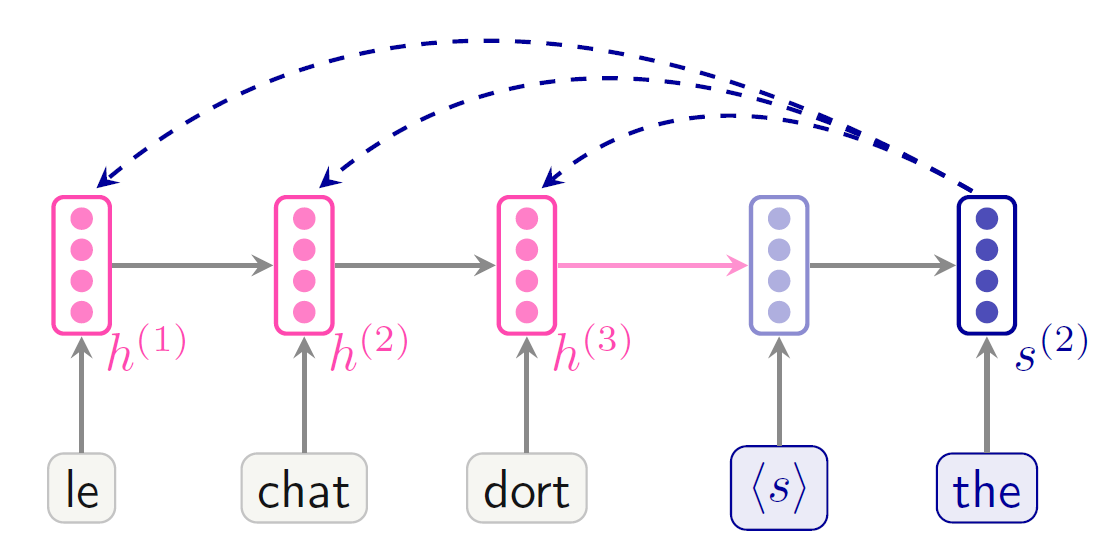
加入 Attention 后,模型保留:
Decoder 每生成一个目标词,都可以重新读取相关源状态。
例如:
源句是
le chat dort,已经生成the,准备生成cat。
这一步应该重点参考 chat 对应的源状态。
注意: 是 Encoder 在位置 的上下文表示,不只是该词的原始 embedding。
4.2 Step 1:Score,计算相关性(P18)
将当前 Decoder 状态 与每个源状态 比较:
它回答的问题是:
当前的生成需求,与源句中哪个位置更相关?
4.3 Step 2:Normalize,转换为权重(P18)
对所有相关性分数使用 softmax:
因此:
PPT 中生成 cat 时的示例:
| 源词 | Attention weight |
|---|---|
| le | 0.11 |
| chat | 0.82 |
| dort | 0.07 |
模型主要关注 chat。
4.4 Step 3:Aggregate,加权读取信息(P18)
是当前生成步骤的 context vector。
上述例子对应:
它主要包含 chat 对应的信息,同时混合其他位置的信息。
4.5 使用 Context Vector 预测目标词(P18)
将 context vector 与 Decoder 状态拼接:
其中:
- :当前生成状态。
- :当前从源句读取的相关信息。
整个流程是:
Score → Normalize → Aggregate → 与 Decoder 状态拼接 → 预测目标词。
4.6 每一步都有新的 Attention(P19)
生成不同目标词时,Decoder 状态不同,attention 分布也会变化。
例如:
- 生成
the:主要关注le。 - 生成
cat:主要关注chat。 - 生成
sleeps:主要关注dort。
将各步的 attention 分布排起来,就得到 attention matrix:
- 横轴:源句位置。
- 纵轴:目标句位置。
- 每一行:生成一个目标词时的权重分布。
4.7 Attention 可以学到词语对齐(P20)
PPT 的真实翻译示例中,attention 大致沿对角线分布,说明两种语言的对应词通常顺序接近。
部分位置偏离对角线,则反映词序变化。
训练时没有提供词对齐标签,这些对应关系通过翻译损失学得。
不过,attention 权重表示信息读取的分配,不能直接视为严格的因果解释。
4.8 为什么 Attention 有效?(P21–22)
缓解固定向量瓶颈
Decoder 可以访问全部源状态。
源句变长时,可读取的状态数量增加,不必把全部细节都压进最后一个向量。
缩短梯度路径
目标位置的损失可以通过 attention 直接影响相关源状态,不必只沿很长的 RNN 链传回去。
提供可观察的对齐模式
Attention matrix 能帮助我们观察模型在不同生成步骤关注的源位置。
P22 的实验显示:
- 无 attention 的模型在长句上质量明显下降。
- 带 attention 的模型在该实验中更稳定。
这不代表 attention 能保证任意长句都翻译正确。
4.9 Query 与 Value 的含义(P23)
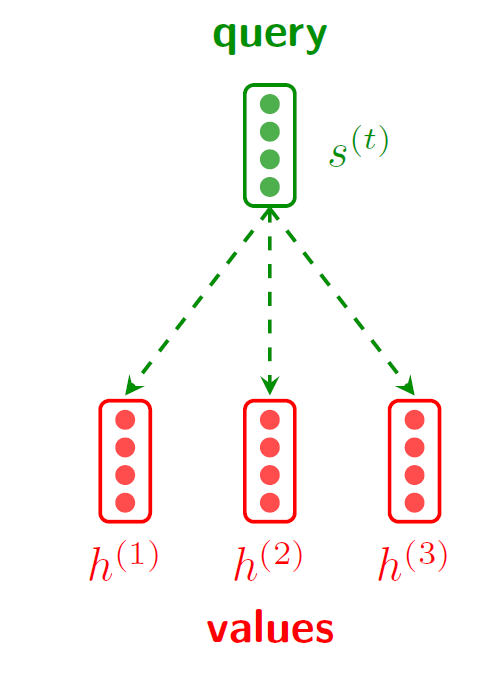
| 名称 | 对应内容 | 直觉 |
|---|---|---|
| Query | Decoder 状态 | 我现在需要什么信息? |
| Values | Encoder 状态 | 有哪些内容可以读取? |
在这一版 attention 中, 同时承担两个角色:
- 与 Query 比较,决定匹配程度。
- 参与加权平均,提供读取内容。
后续课程会进一步把这两个角色拆成 Key 与 Value。
5. Attention 的不同形式(P24–31)
5.1 主要区别在 Score Function(P25)
不同 attention 通常共享以下流程:
主要变化是:如何计算 。
5.2 Dot-Product Attention(P26)
优点:
- Score 函数不增加可学习参数。
- 计算简单,容易通过矩阵运算并行处理。
限制:
- 与 必须维度相同。
- 直接在相同坐标之间进行匹配。
这里的“无参数”仅指 score 函数。Encoder 和 Decoder 本身仍然需要训练。
5.3 Multiplicative / Bilinear Attention(P27)
其中:
可学习矩阵 可以决定 Decoder 的哪些特征应当与 Encoder 的哪些特征匹配。
优点:
- 支持 和 维度不同。
- 匹配方式可以通过训练学习。
代价是参数更多。例如, 的矩阵约有 26 万个参数。
当维度相同且 时,就退化为 dot-product attention。
5.4 Reduced-Rank Multiplicative Attention(P28)
将完整矩阵分解为:
于是:
其中:
当 较小时,参数量从:
减少到:
直觉是:
将两边映射到较小的共同空间,再计算点积。
这与 Transformer 中 Query 和 Key 先投影、再点积的形式相联系。不过完整 Transformer attention 还有缩放、Value 投影和多头等设计。
5.5 Additive Attention(P29)
它使用一个小型前馈神经网络,为源状态与 Decoder 状态的组合打分。
特点:
- 包含非线性,匹配方式更灵活。
- 相比简单点积,需要更多计算。
“Additive” 指投影后的状态相加,不是把 attention 权重直接相加。
5.6 四种形式对比(P30)
| 方法 | Score function | 参数 | 核心特点 |
|---|---|---|---|
| Dot-product | none | 直接匹配,计算简单 | |
| Multiplicative | d2 d1 | 学习完整的线性匹配 | |
| Reduced-rank | r (d1 + d2) | 低维投影后匹配 | |
| Additive | d3 (d1 + d2 + 1) | 使用非线性网络匹配 |
它们最终都将分数交给 softmax,再对源状态进行加权平均。
5.7 从 RNN 到 LSTM,再到 Attention(P31)
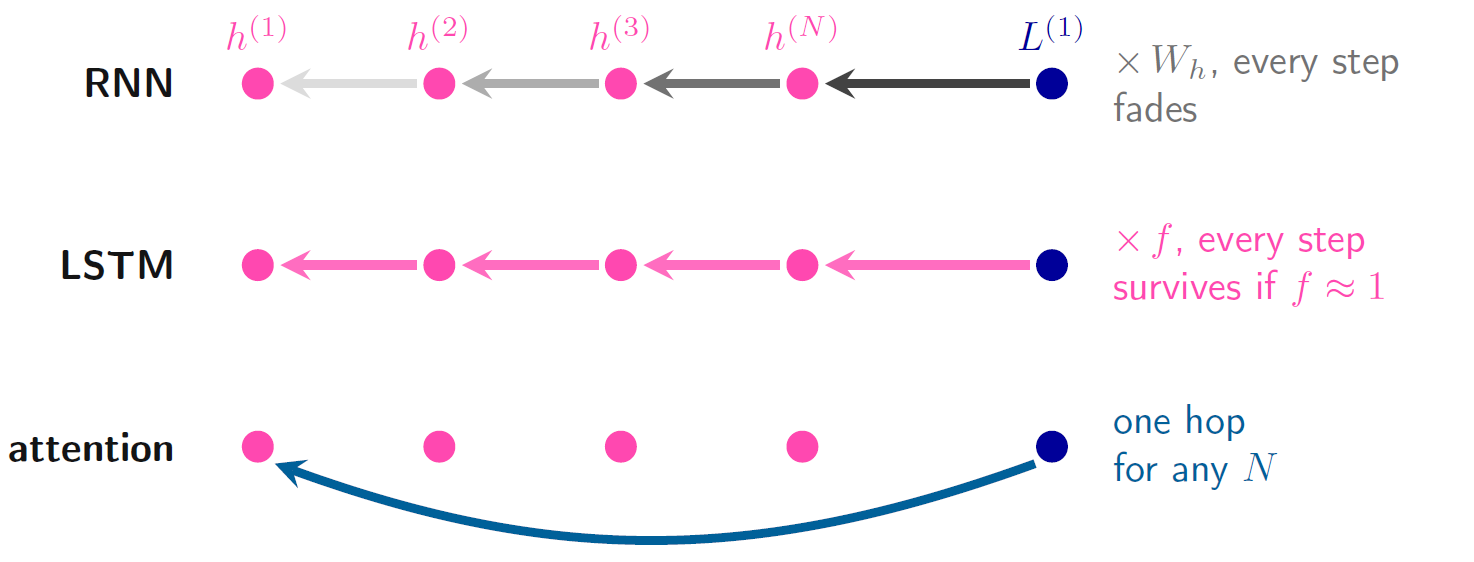
| 机制 | 信息与梯度如何传递 |
|---|---|
| RNN | 沿时间步逐步传递,长链容易出现梯度问题 |
| LSTM | 利用 cell state 和门控改善长期传递 |
| Attention | 为目标位置与源状态提供直接连接 |
LSTM 改善沿时间链传递信息的能力;Attention 进一步提供跨位置的直接读取路径。
6. Decoding:如何生成完整译文?(P32–36)
模型提供:
Decoding 决定如何根据这些概率选择输出序列。
Greedy Decoding(P33)
每一步选择当前概率最大的词:
优点是简单、速度快。
问题是:
当前最好的下一个词,不一定属于概率最高的完整句子。
例如,选了 he hit a 后,就不能回到 he hit me 这条路径。
目标:寻找概率最高的完整句子(P34)
通常使用 log probability 累加:
分数越高、越接近 0,表示概率越大。
但长度为 的序列约有 种候选,无法穷举。
Beam Search(P35)
Beam search 每一步保留 个最好的候选前缀,其中 是 beam size。
每一步执行:
- 扩展当前保留的所有候选。
- 计算扩展后序列的累计分数。
- 在全部扩展中保留最好的 个。
关键是:
所有分支一起选 top-,不是每个分支各保留 个。
它每一步大约需要考虑 个扩展分数,比穷举便宜很多。
Beam Search 示例(P36)
PPT 使用 ,每一步保留两条候选路径。
这样,一条当前分数略差、但后续更好的路径仍有机会胜出。
图中最终选中的路径是:
he hit me with a pie
Beam search 搜索得比 greedy 更广,但仍可能提前剪掉最终最优路径,所以不保证全局最优。
Length Normalization(P39)
PPT 总结页提到,最终选择需要考虑长度归一化。
因为每增加一个 token,累计 log probability 通常都会降低,直接比较不同长度的句子可能偏向短输出。
一种简单的处理是使用平均 log probability:
也可以使用其他 length penalty,具体形式取决于实现。
7. 发展与局限(P37–39)
7.1 神经机器翻译的发展(P37)
| 时间 | 发展 |
|---|---|
| 2014 | Seq2Seq |
| 2015 | Attention |
| 2016 | Google Translate 转向神经机器翻译 |
| 2017 | Transformer |
机器翻译推动了 Seq2Seq 与 Attention 的发展,这些思想随后影响了更广泛的语言模型设计。
7.2 机器翻译解决了吗?(P38)
PPT 展示的结果中:
- 高资源语言,例如西班牙语、法语,表现较好。
- 部分低资源语言,例如 Nuer、Dinka,表现明显较差。
平行语料的数量与质量是重要因素。更强的架构本身不能消除数据不足的问题。
总结
| 核心连接 | 需要掌握的内容 |
|---|---|
| LM → MT | 翻译是在源句条件下预测下一个目标 token |
| RNN → Seq2Seq | Encoder 读源句,Decoder 写译文 |
| Seq2Seq → Attention | 从固定向量传递信息,发展到每一步按需读取源状态 |
| Attention variants | 主要改变如何计算相关性分数 |
| 概率模型 → Decoding | 模型给出概率,搜索算法决定实际输出 |
重点复习:
- P11–15:Conditional LM、Seq2Seq、Teacher Forcing 与信息瓶颈。
- P17–18:Attention 的 Score、Normalize、Aggregate。
- P25–30:不同 attention score 的区别。
- P33–36:Greedy 与 Beam Search 的区别。