Lesson 7-Language Modeling + RNNs
只有词向量,还不能直接生成一句话。我们需要建模词与词之间的顺序关系。这就引出了 Language Model(语言模型)。
这节课围绕一个核心问题展开:预测下一个词时,模型应该怎样记住前面的内容?
1. 从词向量到语言模型(p3–12)
1.1 前置知识:Tokenization 与 Embedding
- Tokenization:决定文本被切成哪些 token。
- Embedding:把每个 token 映射为一个向量。
- Language Modeling:建模 token 之间的顺序关系,预测后续内容。
1.2 语言模型学什么?
语言模型学习文本的概率分布:
例如:
为了判断哪些文本更合理,模型需要从文本中学习语法、语义和世界知识。
学到文本分布后,可以获得三种能力:
| 能力 | 含义 |
|---|---|
| Generate | 根据概率分布生成新文本 |
| Score | 计算一段文本的概率 |
| Represent | 将隐藏向量用于分类等其他任务 |
注意:文本概率高,不代表内容一定符合事实。
为什么预测下一个词就能建模整句话?
根据概率的 Chain Rule(链式法则):
例如:
这条分解是精确的,不需要独立性假设。
因此,语言建模可以转化为重复进行的分类任务:
- 输入:前面已经出现的词。
- 类别:词表中的所有 token。
- 输出:下一个 token 的概率分布。
如果词表大小为 ,每一步就是一个 分类问题。
为什么不能直接统计整句话?
如果直接定义:
其中 是训练句子总数,那么没出现过的句子都会得到零概率。
问题是:合理的句子数量太多,训练集不可能全部覆盖。
好的语言模型必须能够泛化到未见过的句子。
2. 如何评价语言模型:Perplexity 困惑(p13–14)
Perplexity 衡量的是模型对「实际正确输出」有多不确定。低 Perplexity 表示模型能较准确地预料测试文本接下来实际出现什么。
2.1 定义
先计算测试文本的平均负对数概率:
再计算 Perplexity(困惑度):
如果 loss 使用自然对数,则:
PPL 越低越好。
2.2 直觉解释
PPL 可以理解为:
模型平均相当于在多少个候选词之间犹豫。
假设模型每次都在 个候选词中均匀选择,真实词的概率始终为 ,那么:
例如:
Human infants drink ___
如果真实答案是 milk,模型给 milk 的概率越高,当前位置的 loss 就越低。
2.3 注意事项
- PPL 衡量真实答案获得的概率,不是只看模型是否自信。
- 自信地预测错误,会受到很大惩罚。
- PPL 应在相同测试数据和 tokenization 下比较。
- 均匀预测整个词表时,;预测很差的模型也可能超过这个值。
3. 固定窗口语言模型:Feedforward LM(p15–18)
核心问题:
怎样把长度不固定的历史,转成神经网络的输入?
3.1 方法一:词向量相加
优点:输出维度固定。
缺点:丢失顺序,相同词语的不同排列会得到相同结果。
3.2 方法二:词向量拼接
优点:保留顺序。
缺点:历史越长,输入向量越大。
3.3 方法三:只看最近几个词
固定窗口模型只拼接最近 个词的 embedding。
例如:
the students opened their → ?
先计算隐藏表示:
再预测下一个词:
它本质上是一个前馈分类器。
然而:
- 窗口外的信息完全不可见。
- 扩大窗口会增加输入维度和参数量。
- 不管窗口多大,仍然可能截掉重要信息。
因此,我们希望:能够处理任意长度的历史,同时保持固定的参数数量。
4. RNN:边读边更新历史摘要(p19–22)
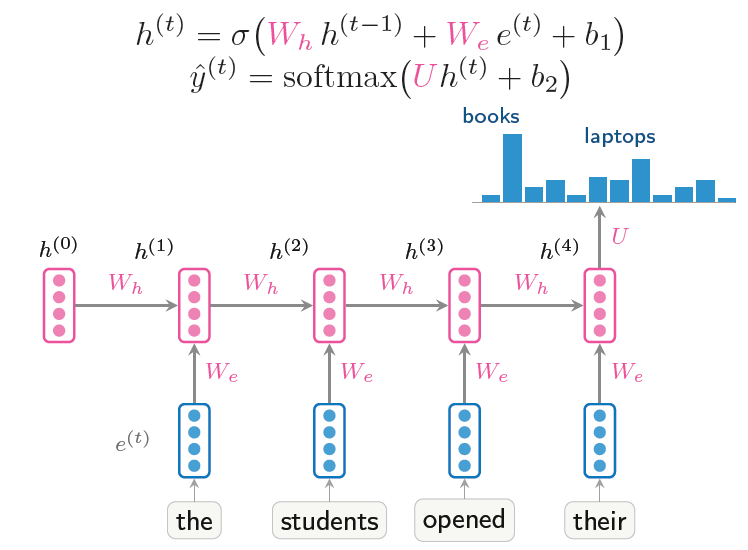
Hidden State
RNN 维护一个隐藏状态 ,作为已经读取内容的摘要:
再利用当前状态预测下一个词:
| 符号 | 含义 |
|---|---|
| 当前词的 embedding | |
| 读取当前词之前的历史摘要 | |
| 加入当前词之后的新摘要 | |
| 所有时间步共享的参数 |
例如读取:
the → students → opened → their
每读取一个词,都更新一次隐藏状态,最后用它预测后续词。
为什么参数量不随句子长度增加?
因为所有时间步共享同一套参数。
输入更长,只会增加计算次数,不会增加模型参数量。
但要区分:
- 能够处理任意长度输入。
- 能够完整记住任意长度的信息。
RNN 满足前者,但固定维度的隐藏状态会形成信息瓶颈。
如何训练
每个位置都预测下一个词:
| 当前已读内容 | 训练目标 |
|---|---|
| the | students |
| the students | opened |
| the students opened | their |
| the students opened their | exams |
平均 cross-entropy loss 为:
训练时输入真实前文,通常称为 Teacher Forcing。生成时,将已经生成的词继续输入模型。
文本自身就能提供标签,不需要额外的人工标注。
<span style="color: #66ccff;">和现在 decoder-only LLM 的预训练,核心目标都是 next-token prediction</span>
优缺点
| 优点 | 缺点 |
|---|---|
| 可以处理变长输入 | 时间步之间有依赖,训练难以并行 |
| 参数量固定 | 固定维度状态形成信息瓶颈 |
| 理论上可以利用很远的历史 | 实际上长期依赖难以学习 |
5. RNN 为什么会忘:梯度消失与爆炸(p23–29)
5.1 Backpropagation Through Time(BPTT)
假设第 4 步预测错误,需要把学习信号传回第 1 步。
梯度必须沿时间逐步回传。采用列向量梯度记法:
其中:
对于普通 RNN:
距离越远,需要连乘的矩阵越多。
梯度消失
用标量近似理解:假设每一步把梯度缩小为原来的 :
传回很远之后,梯度几乎为零。
这意味着远处位置收到的学习信号非常弱,模型难以学会利用长期依赖。
Exploding Gradients:梯度爆炸
如果每一步把梯度放大为原来的 :
梯度可能迅速变大,导致:
- 参数更新过大。
- Loss 突然升高。
- 严重时出现 Inf 或 NaN。
实际情况取决于矩阵乘积,标量幂只是帮助理解。
5.4 Gradient Clipping
梯度爆炸可以通过限制梯度范数缓解:
含义:
保留梯度方向,但限制更新幅度。
注意:Gradient Clipping 不能解决梯度消失。
5.5 远处信息是否完全没用?
p26 的实验通过打乱不同距离的上下文,观察 loss 的变化。
在该实验设置下:
- 打乱附近的词序,loss 明显上升。
- 距离超过约 50 个词后,打乱词序的影响较小。
这说明模型可能仍然知道远处出现过哪些词,但对精确顺序的利用较弱。
这不是所有 LSTM 的固定长度上限。
6. LSTM:有选择地更新记忆(p30–34)
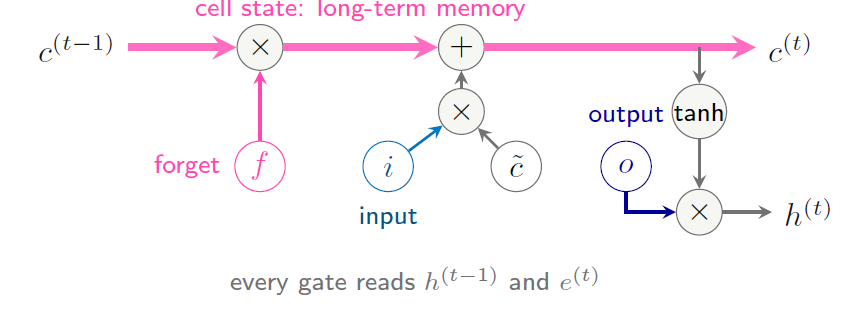
普通 RNN 每一步都重新计算隐藏状态。
LSTM 增加一条专门的记忆通道,通过 gate 控制:
- 保留什么。
- 写入什么。
- 输出什么。
新记忆 = 选择保留的旧记忆 + 选择写入的新内容。
两种状态
| 状态 | 作用 |
|---|---|
| Cell state | 内部保存的记忆 |
| Hidden state | 当前对外输出的表示 |
三个 Gate 与一个 Candidate
| 部件 | 作用 |
|---|---|
| Forget gate | 控制旧记忆保留多少 |
| Input gate | 控制新内容写入多少 |
| Output gate | 控制当前记忆输出多少 |
| Candidate | 本次准备写入的内容 |
各 gate 根据当前输入和旧隐藏状态计算,经过 sigmoid 得到 0 到 1 之间的值。
核心公式
更新 cell state:
可以读成:
新记忆 = 保留的旧记忆 + 写入的新内容。
计算 hidden state:
其中 表示逐元素相乘,不同记忆维度可以分别控制。
6.5 为什么能缓解梯度消失?
沿 cell state 的直接保留路径,局部梯度因子是:
当相关维度的 时,记忆和梯度可以更容易地跨时间传递。
相比普通 RNN,这条路径不必在每一步都经过 和激活函数导数。
注意:
- 这是直接记忆路径上的导数,完整梯度还包含其他分支。
- LSTM 缓解长期依赖问题,但不保证永远不会遗忘。
- LSTM 仍然需要逐步计算,时间维度上的并行问题仍然存在。
7. RNN 的用途与结构扩展(p35–37)
7.1 同一个 RNN,不同的输出方式
| 任务 | 如何使用隐藏状态 |
|---|---|
| 情感分类 | 最后一个状态,或所有状态的 mean/max pooling → 一个标签 |
| POS tagging、NER | 每个位置的状态 → 该位置的标签 |
| 条件生成 | 根据输入条件,逐步预测输出 token |
RNN 是处理序列的结构,语言建模只是其中一种用途。
7.2 Bidirectional RNN:双向读取
一个 RNN 从左往右读,另一个从右往左读,再拼接:
每个位置都可以利用左右两侧的上下文。
适合:
- 句子编码。
- 词性标注。
- 命名实体识别。
它需要提前拿到完整输入。标准自回归 next-token prediction 不能直接使用未来真实词,否则会泄漏答案。
7.3 Deep RNN:堆叠多层
- 第一层读取 embedding。
- 第二层读取第一层的隐藏状态。
- 更高层继续处理下面一层的输出。
需要区分两个方向:
| 方向 | 信息如何传递 |
|---|---|
| 时间方向 | 同一层从前一个词传到后一个词 |
| 深度方向 | 同一位置从下面一层传到上面一层 |
双向结构决定利用哪一侧上下文;堆叠结构决定进行多少层特征变换。