Lesson 6-Word Embeddings + Tokenization
- Tokenization 决定文本被切成哪些 token。
- Embedding 把每个 token 转成一个向量。
主线是:
Nonlinearity → Distributional semantics → Word2Vec / Skip-gram → Embedding evaluation → Tokenization → BPE
第一章:再解释一次 nonlinearity 到底做了什么(第 5–10 页)
1. 一个简单的 classification task
假设每封邮件只有一个 feature:
邮件中有多少个感叹号?
不同邮件的 feature 可能是:
- 普通通知:很少的感叹号。
- Spam:中等数量的感叹号。
- 朋友激动的消息:很多感叹号。
这时,“感叹号越多,越可能是 Spam”未必成立。
需要的关系可能是:
中间范围是 Spam,两侧都不是。
一个单调变化的 linear score 很难表达这个 pattern。
2. 一个 ReLU neuron 提供一个 bend
例如:
当 input 小于等于 2 时,output 为 0;超过 2 后,output 开始 linear increase。
它在 2 的位置产生一个 bend。
但是,仅靠这一项,output 只能先保持不变,再单方向增加。
3. 多个 ReLU neurons 可以组合出 bump
定义:
Output layer 将它们组合:
分区间计算:
| Input range | Output score |
|---|---|
| x ≤ 2 | 0 |
| 2 < x ≤ 4 | x - 2 |
| 4 < x ≤ 6 | 6 - x |
| x > 6 | 0 |
这就形成了一个 triangular bump:
- 小 input:score 低。
- 中间 input:score 高。
- 大 input:score 又变低。
配合适当 threshold,就可以识别中间范围。
Nonlinear activation 的作用,是让多个简单 units 组合出更复杂的 input–output relationship。
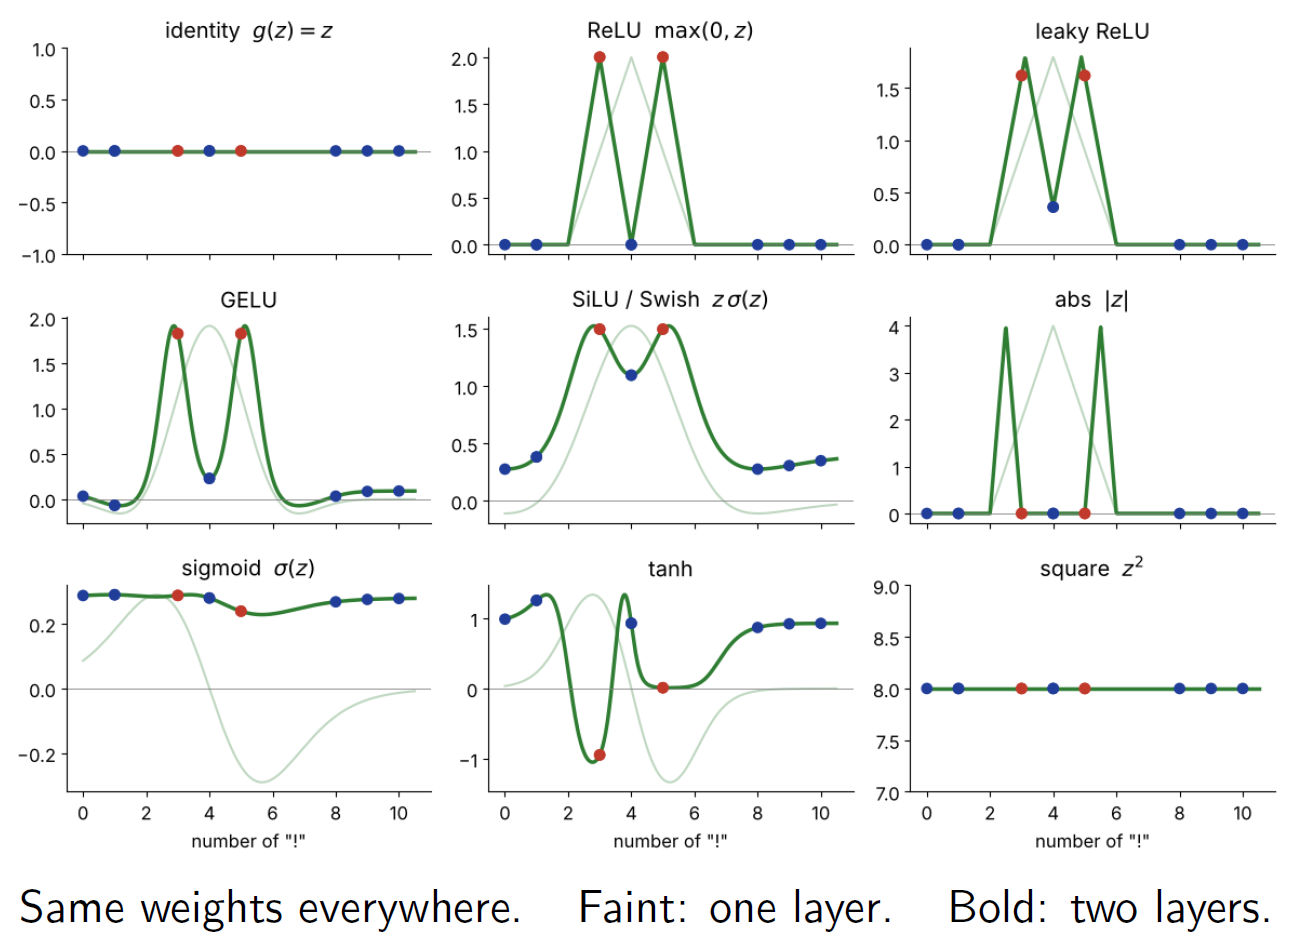
4. 如果去掉 ReLU?
相同的 weights 得到:
没有 activation,多个 affine functions 相加后仍然是 affine function。
在这个例子里,甚至直接变成常数。
相同 weights 搭配不同 activation functions,最终的 function shape 可以很不一样。
第二章:为什么需要 learned word representations?(第 11–14 页)
1. 传统方式:手工定义 meaning
PPT 使用 WordNet 作为例子。
WordNet 是手工构建的 lexical resource,可以记录:
- Synonymy:car 与 automobile。
- Is-a relations:mouse → rodent → animal。
它把 words 及其 relations 组织起来。
但是
| Limitation | 含义 |
|---|---|
| Too coarse | 放在相似类别里的词,实际用法可能不同 |
| Difficult to maintain | 新词、新义不断出现,人工更新跟不上 |
| Limited graded similarity | 单纯的 graph links 不直接提供连续的 similarity score |
例如:
- good 和 great 有多接近?
- good 和 fine 有多接近?
- 新出现的 slang 应如何表示?
我们希望 representations 能够从 data 学习,并表达不同程度的 similarity。
注意,learned embeddings 也不会自动保持最新;它们仍然受 training corpus 和更新时间限制。
关键创新: 把 word 表示为 vector
每个 word 对应一个 dense vector:
例如:
目标是让具有相似 usage 或 meaning 的 words,在 vector space 中有相关的 representations。
相似程度可以用 dot product 或 cosine similarity 衡量。
Dot product:
Cosine similarity:
Cosine similarity 会消除 vector magnitude 的影响,主要比较 direction。
注意!
PPT 用 good 与 bad 指向相反方向作示意。
但实际 distributional embeddings 中,antonyms 也可能很接近,因为它们常出现在类似 contexts:
- a good movie
- a bad movie
因此:Distributional similarity 不等于 synonymy,反义关系也不保证对应 opposite directions。
第三章:Distributional semantics(第 15–20 页)
1. 从 context 推断 meaning
PPT 使用 kombucha 举例:
I had a glass of kombucha at the farmers market.
Children or pregnant women should not drink kombucha.
即使不知道 kombucha 的定义,也可以从:
- glass of
- drink
- 相关 contexts
推测它属于某种 drink。
这就是 distributional semantics 的核心直觉:Words that occur in similar contexts tend to have related meanings.
2. 为什么需要多个 dimensions?
如果只用一个 number 表示动物的 size:
- mouse 很小。
- cat、dog 较小。
- horse、tiger 较大。
那么 tiger 可能与 horse 很近,但无法表达 tiger 与 cat 的其他联系。
增加 dimensions 后,可以同时表达多种差异,例如:
- Size。
- Domestic / wild。
- Animacy。
- Grammatical properties。
- Register。
这只是帮助理解的例子。
3. 实际 embedding dimensions 通常没有名字
真实 embeddings 不会规定:
- Dimension 1 必须表示 size。
- Dimension 2 必须表示 gender。
- Dimension 3 必须表示 royalty。
这些 values 是 training 得到的,信息通常分布在多个 dimensions 中。
因此,不能简单把每个 coordinate 当作一个明确的 semantic label。
4. Embedding matrix
假设 vocabulary 有 V 个 tokens,每个 embedding 有 d 个 dimensions:
其中:
- 每一行对应一个 vocabulary item。
- 每一列对应一个 embedding dimension。<span style="color: #66ccff;"> Dense embeddings 的 dimension 通常远小于 vocabulary size。</span>
- Token ID 用来选择对应的 row。
例如:
| Quantity | Example |
|---|---|
| Vocabulary size | 50,000 |
| Embedding dimension | 300 |
| Embedding matrix shape | 50,000 × 300 |
第四章:Word2Vec 的 Skip-gram——通过预测 neighbors 学习 vectors(第 21–26 页)
1. 不依赖人工 semantic labels
Word2Vec 从大量 raw text 中学习 vectors。
Skip-gram 使用的 prediction task 是:
给定 center word,预测它附近的 context words。
Training targets 直接从 text 中构造,因此不需要人工标注的 meaning labels, 可以理解为 self-supervised learning。
2. Sliding window 构造 training pairs
假设文本片段为:
problems turning into banking crises as
Window radius 为 2。
当 center word 是 into 时,context words 是:
- problems。
- turning。
- banking。
- crises。
对应 training pairs:
| Center | Context |
|---|---|
| into | problems |
| into | turning |
| into | banking |
| into | crises |
Center 移动到 banking 后,又产生:
| Center | Context |
|---|---|
| banking | turning |
| banking | into |
| banking | crises |
| banking | as |
一个 center 会产生多个 prediction targets。
3. 每个 word 有两套 vectors
Skip-gram 通常为每个 word 学习:
- Center vector:word 作为 center 时使用。
- Context vector:word 作为 context 时使用。
记为:
为什么分两套?
因为“作为 input”与“作为 prediction target”是两个不同角色,model 使用两组 parameters 表示这两个角色。
4. 用 dot product 计算 score
给定 center c,context candidate o 的 score:
然后对整个 vocabulary 应用 Softmax:
这和前面的 multiclass classification 一样:
- Input:center embedding。
- Classes:vocabulary 中所有可能的 context words。
- Output:各 context words 的 probabilities。
Skip-gram
给你一个中心词,猜它附近出现了什么词
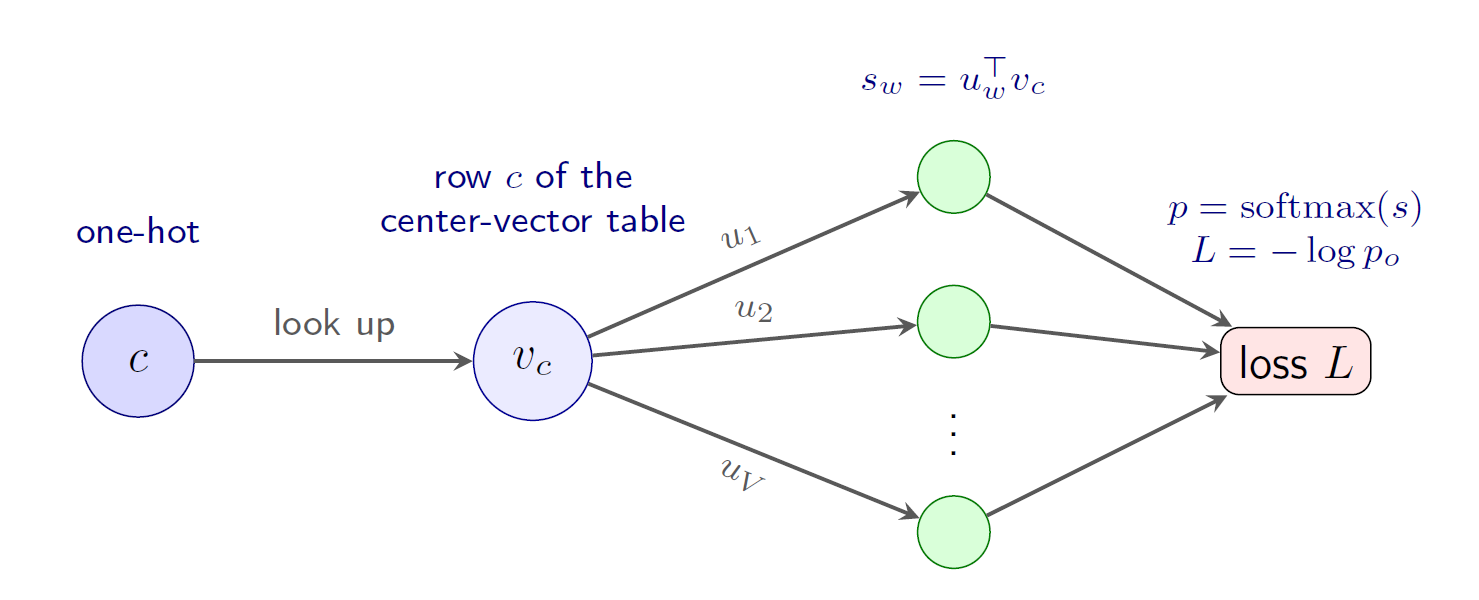
可以理解为:
One-hot input → Embedding lookup → Linear output scores → Softmax
Hidden representation 就是 center word 的 embedding。
这里没有 hidden nonlinear activation。
这与前面“没有 nonlinearity,多层会 collapse”并不矛盾:
- Collapse 讨论的是 function 表达形式。
- Skip-gram 通过两个较小的 embedding tables 对 word-context score matrix 做 factorization。
- 这种结构共享 parameters,并要求用低维 vectors 表示 word-context relations。
它的目标是学习 representations,不是依靠 deep nonlinear boundaries 完成任务。
1. 一对 center–context 的 loss
对于观察到的 pair:
希望提高真实 context word 的 probability:
例如:
2. 整个 corpus 的 objective
假设 corpus 长度为 T,window radius 为 m:
这里仅包含没有越过 corpus boundaries 的有效 positions。
含义是:
- 遍历每个 center position。
- 遍历 window 内的 context positions。
- 每个 pair 贡献一个 NLL term。
Theta 包含两套 word vectors。
gradient
Context vector 的
令 pw 表示 model 给 context candidate w 的 probability。
令 tw 为 one-hot target。
则:
它与上一节课的 classifier gradient 完全一致:
Error × input。
对于 observed context o:
对于其他 context candidates:
4. Center vector
Center vector 影响所有 output scores,因此要把路径 contributions 相加:
由于 target 是 one-hot:
第一项是 model 的 expected context vector:
第二项是 observed context vector:
因此 gradient descent 的 update 是:
直觉是:
- 向 observed context 的方向调整。
- 减去 model 当前 expected context 的影响。
注意,center gradient 为零,不一定意味着所有 context gradients 都为零。
5. 为什么 similar-context words 会有 related vectors?
如果两个 center words 经常对应类似 context words,它们就会受到相似的 training signals。
为了预测相似的 context distributions,model 往往为它们学到相关的 representations。
这就是 distributional semantics 如何变成具体的 optimization objective。
这里推导的是 full-Softmax Skip-gram;negative sampling 不在这份 PPT 的推导范围内。
第六章:如何评价 embeddings?(第 28–29 页)
1. Intrinsic evaluation
直接检查 embedding space 的性质。
Nearest neighbors
例如 great 附近可能出现:
- excellent。
- fantastic。
- wonderful。
检查这些 neighbors 是否符合预期。
Word analogies
经典例子:
先计算 query vector:
再寻找与 q 的 cosine similarity 最大的 vocabulary word。
通常会排除 query 中已有的 words。
类似关系还包括:
- walking → walked。
- Japan → Tokyo。
这些规律是可能观察到的 empirical patterns,不保证对所有 words 都成立。
2. Extrinsic evaluation
把 embeddings 放进 downstream model,观察实际 task performance。
例如:
- Sentiment classification。
- Spam classification。
- 其他 NLP tasks。
如果 embeddings 改善了 downstream accuracy,就说明它们对该 task 有帮助。
3. 三种使用方式
| Strategy | Initialization | Training 时是否更新 embeddings? |
|---|---|---|
| From scratch | Random | 更新 |
| Frozen pretrained | Pretrained | 不更新 |
| Fine-tuned pretrained | Pretrained | 更新 |
选择取决于 task data、computational budget 和 domain match。
Pretrained embeddings 可以把大 corpus 中学到的信息带入较小的 labeled dataset,但不保证所有情况下都优于 from-scratch training。
第七章:GloVe——从 co-occurrence counts 学习 vectors(第 30 页)
Word2Vec 的思路:
从 sliding windows 构造 pairs,执行 prediction。
GloVe 的思路:
先统计 word co-occurrence,再用 vectors 拟合这些 statistics。
PPT 给出的简化关系:
其中:
实际 GloVe objective 还包含 bias terms 和 weighting function。
两者的共同点:
- 从 raw corpus 学习。
- 利用 word-context relations。
- 输出 dense word vectors。
它们的差别主要在于如何组织 statistics 和 training objective。
第八章:Tokenization——到底什么算一个 token?(第 31–35 页)
基本流程:
Text → Tokens → Token IDs → Embedding lookup
例如:
the movie was great
可能变成:
| Token | ID |
|---|---|
| the | 11 |
| movie | 298 |
| was | 34 |
| great | 567 |
Token ID 用来选择 embedding matrix 中对应的 row。
因此:
Tokenizer 决定哪些单位拥有独立 embeddings,以及哪些 occurrences 共享 parameters。
2. Word-level tokenization
以完整 words 为单位。
优点:
- 一个 token 通常具有较明确的 lexical meaning。
- Sequence 相对短。
问题:
- Vocabulary 可能很大。
- Unseen words 可能变成 UNK。
- Different word forms 可能分散到不同 embedding rows。
- Punctuation、abbreviations、numbers 的处理需要规则。
例如:
- open。
- opened。
- opens。
- opening。
如果各自是独立 tokens,稀有 forms 得到的 training updates 就较少。
3. Character-level tokenization
以 characters 为单位。
优点:
- Vocabulary 小。
- 可以组合表示很多未见过的 words。
问题:
- Sequences 更长。
- 单个 character 提供的 meaning 有限。
- Model 需要从 character sequences 中重新学习 word-like patterns。
“没有 unknown words”依赖 character coverage;如果字符本身不在 vocabulary 中,仍需要额外机制。
4. Subword tokenization
在完整 words 和 characters 之间折中:
- Frequent words 可以保留为完整 token。
- Rare words 可以拆成已知 pieces。
- Different word forms 可以共享部分 tokens。
例如,某个 tokenizer 可能得到:
- open。
- open + ed。
- open + ing。
具体 segmentation 取决于学到的 tokenizer,并不保证一定符合 morphology。
| Method | Vocabulary | Sequence length | 主要问题 |
|---|---|---|---|
| Word-level | 通常较大 | 较短 | Rare words、OOV |
| Character-level | 通常较小 | 较长 | 单位过细 |
| Subword-level | 折中 | 折中 | Segmentation 不一定符合 linguistic boundaries |
现代 language models 广泛使用 subword 或 byte-based tokenization。
第九章:BPE 的 training algorithm(第 36、39 页)
BPE 的全称是 Byte Pair Encoding。
PPT 使用 character-based example:
- 从基本 characters 开始。
- 统计相邻 symbol pairs 的 frequency。
- Merge 最 frequent 的 pair。
- 在更新后的 segmentation 上重新统计。
- 重复,直到达到 vocabulary size 等 stopping criterion。
1. Training corpus
| Word | Frequency |
|---|---|
| hug | 10 |
| pug | 5 |
| pun | 12 |
| bun | 4 |
| hugs | 5 |
初始 segmentation:
- h u g。
- p u g。
- p u n。
- b u n。
- h u g s。
2. 第一次 merge:u + g
它出现在:
- hug:10 次。
- pug:5 次。
- hugs:5 次。
总 frequency:
因此 merge:
u + g → ug
更新后:
- h ug。
- p ug。
- p u n。
- b u n。
- h ug s。
3. 第二次 merge:u + n
Frequency:
Merge:
u + n → un
更新后:
- h ug。
- p ug。
- p un。
- b un。
- h ug s。
4. 第三次 merge:h + ug
Frequency:
Merge:
h + ug → hug
最终例子中新增的 tokens 是:
- ug。
- un。
- hug。
Frequency 要根据 corpus occurrences 加权,不能只数出现于多少种 distinct words。
而且每次 merge 后,要根据新的 symbol sequence 重新统计。
第十章:BPE 如何 tokenize 新文本?(第 37 页)
假设学到的 merge ranks 是:
- u + g → ug。
- u + n → un。
- h + ug → hug。
现在遇到 training 中没有出现过的 word:
unhug
初始拆成:
u n h u g
Step 1
当前可 merge:
- u + g,rank 1。
- u + n,rank 2。
先选 rank 更早的:
u n h ug
Step 2
现在可 merge:
- u + n,rank 2。
- h + ug,rank 3。
先 merge:
un h ug
Step 3
继续 merge:
un hug
没有其他适用 merge,结束。
最终 tokens:
- un。
- hug。
最重要的区别
Training 时:
根据 corpus frequency 学习 merge rules。
Encoding 时:
使用已经固定的 merge ranks,决定新文本如何 segmentation。
Encoding 不会重新根据当前句子统计 frequency、重新训练 tokenizer。
另外,只有 vocabulary list 还不够,merge ranks 也是 tokenizer 的组成部分。
BPE 不能简单等同于从左到右选择 longest matching token。
第十一章:为什么 tokenizer 会影响 model capability?(第 38–40 页)
1. Context budget 按 tokens 计算
同一段 text,在不同 tokenizers 下可能产生不同数量的 tokens。
如果代码中的 indentation 被拆成很多 tokens:
- 会占用更多 context budget。
- 同样长度的 context 能容纳的代码更少。
PPT 使用历史 tokenizer 的截图展示这种差异。
2. Numbers 的 segmentation 会影响 arithmetic
例如,一个 number 可能被分成多个不等长 pieces。
Model 需要在 token representations 上学习 arithmetic patterns,segmentation 会影响任务难度。
但 arithmetic performance 也取决于 architecture、training data 和 objective,并不只由 tokenizer 决定。
3. Subwords 不保证永远没有 UNK
能否表示任意 input,取决于 base symbols 的 coverage,以及是否有 byte fallback 等机制。
Byte-level tokenization 可以通过 bytes 覆盖任意 UTF-8 text。
4. 不要把 Skip-gram 当成所有 LLM 的 training objective
这节课用 Skip-gram 展示如何从 context 学 embeddings。
现代 autoregressive LLM 通常使用 next-token prediction,并在更复杂的 network 中联合学习 token embeddings 与其他 parameters。
共同点是:
- 把 text 转成 tokens。
- 为 tokens 建立 learned representations。
- 利用 text 中构造出的 prediction targets 进行 learning。
并不是所有 LLM 都先运行 Word2Vec。
本节课与 DAN 的联系
上一节课的 DAN:
Tokens → Embeddings → Average → FFN → Classification
这一节课补充了前面两个环节:
| Question | 本节课的回答 |
|---|---|
| Tokens 怎么来? | Tokenization,例如 BPE |
| Embeddings 怎么来? | 可以从 context prediction 学习,例如 Skip-gram |
| 如何使用 embeddings? | From scratch、frozen pretrained、fine-tuned pretrained |
| 如何判断 embeddings 有用? | Intrinsic 与 extrinsic evaluation |
需要区分:
- Tokenizer:决定 text 被拆成哪些 discrete units。
- Embedding matrix:为这些 units 提供 trainable vectors。
- Downstream model:利用这些 vectors 完成任务。
最需要掌握的七个问题
- 多个 ReLU neurons 如何组合出 nonlinear function?
- Distributional semantics 的核心假设是什么?
- Skip-gram 如何从 sliding window 构造 training pairs?
- 为什么每个 word 有 center vector 和 context vector?
- Center gradient 中的 observed context 和 expected context 分别是什么?
- Word-level、character-level、subword-level tokenization 有什么 trade-offs?
- BPE training 的 frequency 与 encoding 的 merge rank 有什么区别?