Lesson 5-FeedForward Neural Networks
前两节课解决了两个问题:
- Learning Part I:应该 optimize 什么?——定义 loss。
- Learning Part II:如何 optimize?——计算 gradients,更新 parameters。
这节课进一步问:
如果 linear classifier 的表达能力不够,应该换成什么 model?
答案是 Feedforward Neural Network(FFN)。
本节课的主线是:
Single neuron → Hidden layers → Nonlinearity → Backpropagation → Regularization → Deep Averaging Network
第一章:从 binary classifier 理解 single neuron(第 5–10 页)
1. Binary classification 中,Softmax 可以写成 Sigmoid
对于两个 classes:
分子、分母同时除以 exp(s1):
定义 Sigmoid:
于是:
两个 linear scores 的差仍然是一个 linear score,所以可以写成:
这就是 binary logistic regression(用来做二分类,并估计样本属于正类的概率)。
2. 一个 neuron 做两件事
第一步,计算 weighted sum:
第二步,应用 activation function:
因此,一个 neuron 可以理解为:
Input → Weighted sum → Activation → Output
当 activation 是 Sigmoid 时,它就能表示前面的 binary logistic regression。
3. Sigmoid 的作用
| Input score | Sigmoid output |
|---|---|
| 很大的负数 | 接近 0 |
| 0 | 0.5 |
| 很大的正数 | 接近 1 |
Sigmoid 把任意 real-valued score 转换到 0 和 1 之间,因此可以用于表示 binary class probability。
<span style="color: #66ccff;">注意区分sigmoid 和softmax, 我以前老搞混</span>
| 函数 | 怎么转 | 常见用途 |
|---|---|---|
| Sigmoid | 把一个 logit 映射到 ((0,1))。如果对多个 logit 分别用 Sigmoid,结果不要求加起来等于 1 | Binary Classification 或 Multi-label Classification |
| Softmax | 把一组 logits 转成一组概率,所有概率加起来等于 1 | Multi-class Classification,每个样本只属于一个类别 |
4. 为什么 single Sigmoid neuron 的 decision boundary 仍然是 linear?
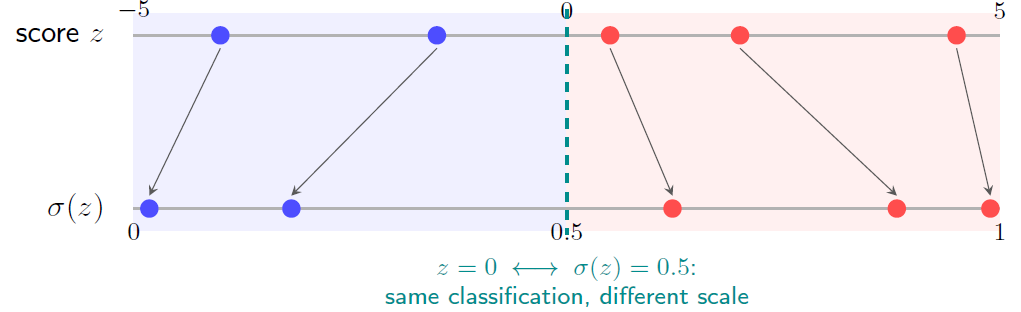
Sigmoid 虽然是 nonlinear function,但它 strictly increasing:
所以:
Decision boundary 仍然是:
二维中是直线,高维中是 hyperplane。
给一个 linear score 加上 Sigmoid,并不会自动产生 nonlinear decision boundary。
要提高表达能力,需要组合多个 neurons 和 layers。
第二章:从多个 neurons 到 multilayer network(第 11–17 页)
1. 一个 layer 是多个 neurons 并行计算
假设一个 layer 有四个 neurons。
每个 neuron:
- 接收相同的 input。
- 拥有自己的 weights 和 bias。
- 输出一个 scalar。
把所有 outputs 放在一起,得到新的 representation:
2. Hidden units 不需要单独的 labels
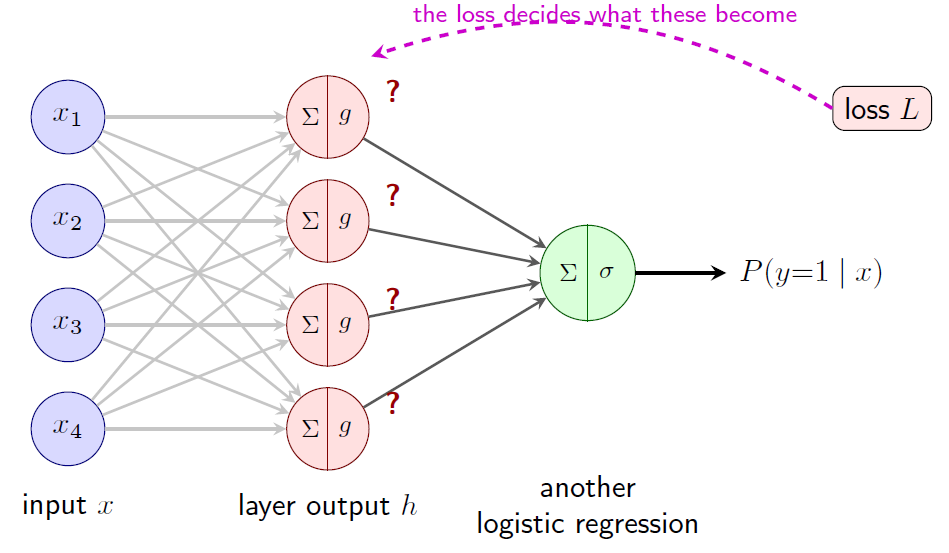
我们只提供最终任务的 label,例如 Spam 或 Not spam。
我们不会指定:
- 第一个 hidden unit 必须识别某个词。
- 第二个 hidden unit 必须检测某种语法。
- 第三个 hidden unit 必须表达某种情绪。
这些 hidden representations 由最终 loss 引导形成。
Hidden units 学什么,取决于什么样的 representation 有助于降低最终 loss。
3. 用 matrix 表示整个 layer
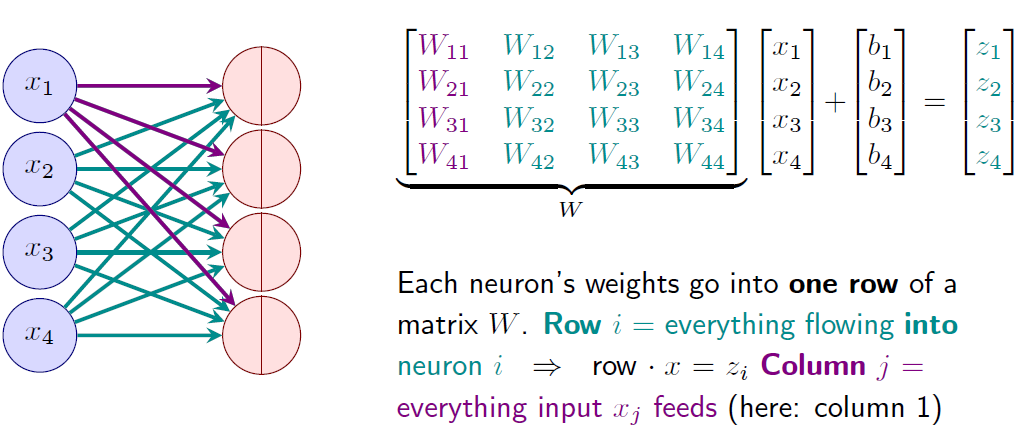
对于第 i 个 neuron:
这里:
把所有 neurons 放在一起:
再对每个 entry 应用 activation:
这里 g 是 element-wise operation。
如果 input dimension 为 d,neuron 数量为 m:
| Quantity | Shape |
|---|---|
| x | d × 1 |
| W | m × d |
| b | m × 1 |
| z | m × 1 |
| h | m × 1 |
W 的每一行,对应一个 neuron 的全部 input weights。
4. Stacking layers
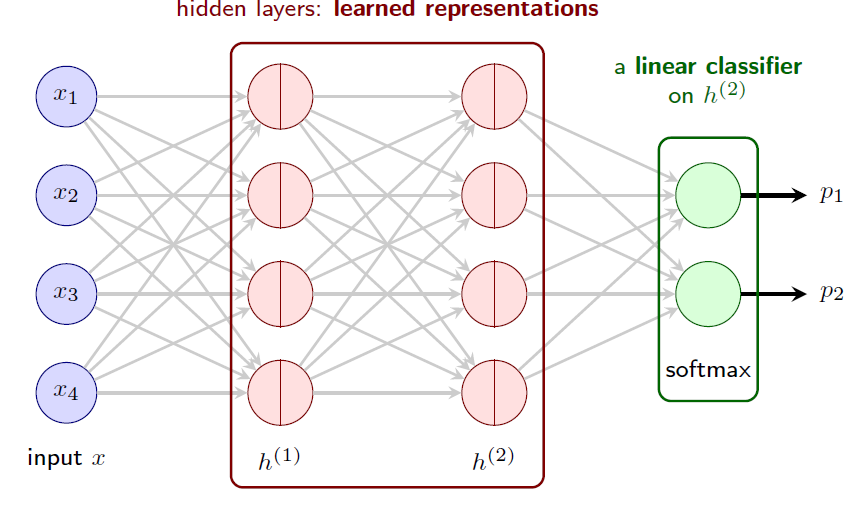
多个 layers 可以写成:
每个 hidden layer 都把前一层的 representation 转换成新的 representation。
最后的 classifier 对最后一层 hidden representation 是 linear 的,但对原始 input 可以是 nonlinear 的。
第三章:为什么一定需要 nonlinearity?(第 18–19 页)
1. 没有 nonlinear activation,多层会 collapse 成一层
考虑两个没有 activation 的 layers:
代入:
整理:
定义:
就得到:
所以,即使叠很多 layers,没有 nonlinear activation,最终仍然只是一个 affine transformation。
对于 classification,表达的仍然是 linear decision boundary。
形象化:
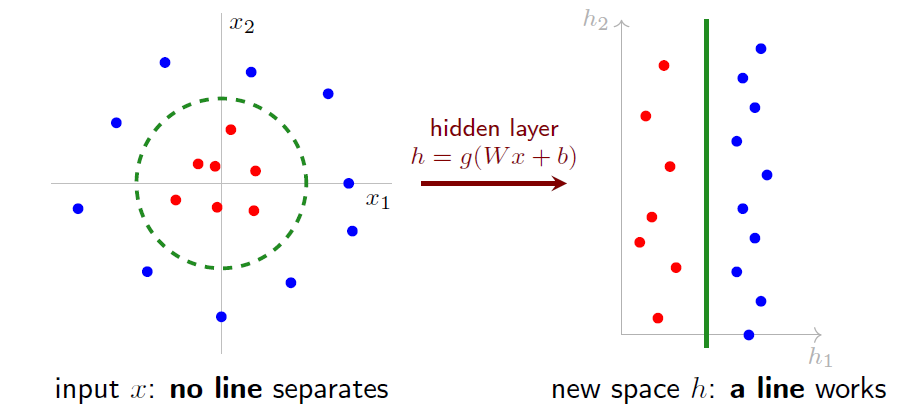
- 原始 input space 中,红点集中在内部,蓝点分布在外围。
- 无法用一条直线将它们分开。
- 经过 nonlinear hidden transformation 后,两类在新的 representation space 中可以用直线分开。
可以理解为 Hidden layers 负责重新组织 representation,让最后的 linear classifier 更容易完成任务。
第四章:常见 activation functions(第 20–21 页)
这张图同时画出了 activation 和对应的 derivative。理解 derivative 很重要,因为 backpropagation 会沿路径乘上这些 derivatives。
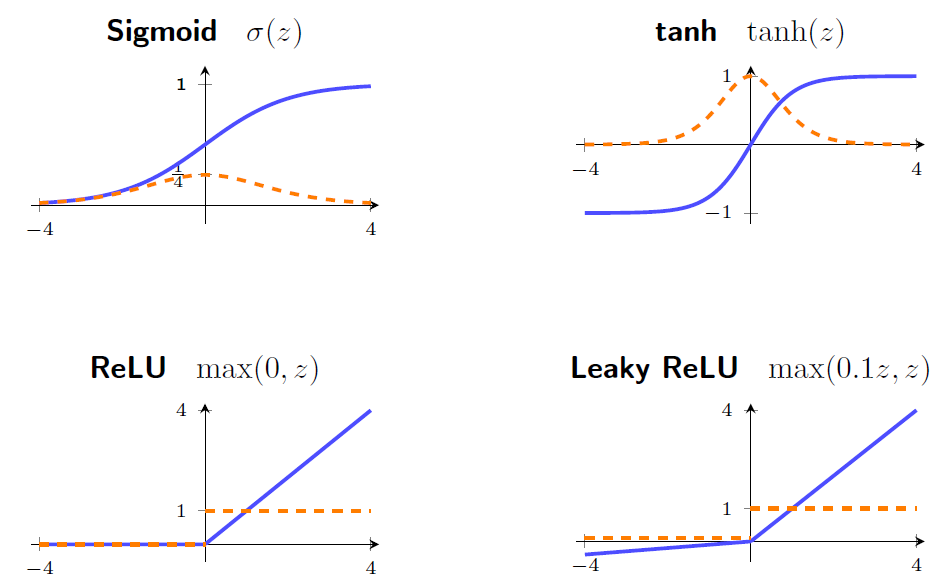
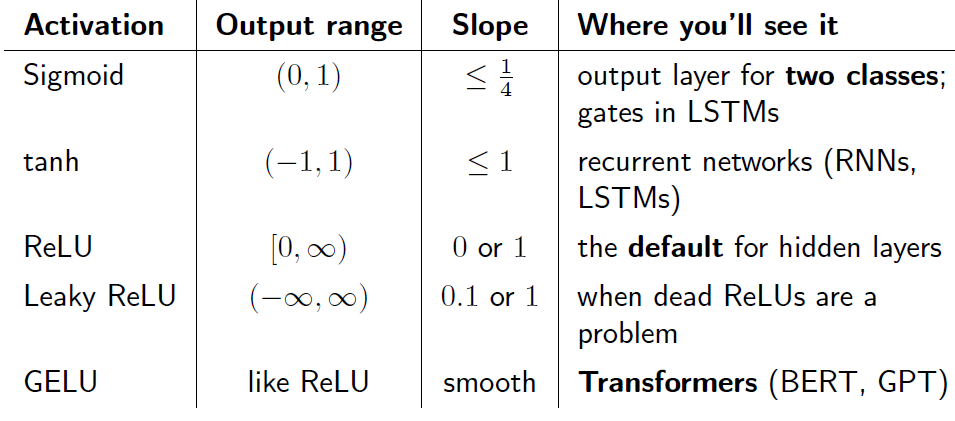
1. Sigmoid
Derivative:
特点:
- Output range 为 (0,1)。
- 最大 derivative 为 0.25。
- 当 input 很大或很小时,derivative 接近 0。
如果多个 layers 连续乘上很小的 derivatives,gradient 可能越来越小。这有助于理解 vanishing gradients。
常见用途:binary classification 的 output,以及某些 gating mechanisms。
2. tanh
Derivative:
特点:
- Output range 为 (-1,1)。
- Output 是 zero-centered。
- 在两端也会 saturation,derivative 接近 0。
3. ReLU
当 z 大于 0 时:
当 z 小于 0 时:
特点:
- 计算简单。
- Positive region 的 derivative 为 1。
- Negative region 不传递通过该 activation 的 gradient。
如果某个 neuron 长期对 inputs 都输出 0,它可能难以继续学习,这叫 dead ReLU。
在零点,ReLU 不可微;实际 frameworks 使用约定的 derivative。
注意,ReLU 的 active derivative 为 1,不代表整个 network 一定不会发生 vanishing 或 exploding gradients;weights 也会影响 gradient propagation。
4. Leaky ReLU
其中 alpha 是较小的正数,PPT 举例为 0.1。
特点:
- Negative region 保留一个较小的 slope。
- 缓解 dead ReLU 问题。
5. GELU
PPT 将 GELU 列为 Transformers 中常见的 activation。
它是 smooth nonlinear activation,常见于 BERT、GPT 等 architectures。
第五章:Forward pass 与代码对应关系(第 22–23 页)
PPT 使用一个 network:
Input 3 → Hidden 4 → Hidden 4 → Output 1
对应的 forward pass:
各 weight matrices 的 shapes:
| Parameter | Shape |
|---|---|
| W1 | 4 × 3 |
| W2 | 4 × 4 |
| W3 | 1 × 4 |
PyTorch 写法:
model = nn.Sequential(
    nn.Linear(3, 4),
    nn.Sigmoid(),
    nn.Linear(4, 4),
    nn.Sigmoid(),
    nn.Linear(4, 1)
)
注意:
- nn.Linear 包含 weights 和 bias。
- Activation 是独立的 module。
- 最后一层输出的是 raw score,也就是 logit。
- 最后一层有一个 output,适用于这里的 binary setting。
对于 multiclass classification,最后一层通常输出 K 个 logits,K 是 class 数量。
第六章:Neural network 如何通过 backpropagation 学习?(第 24–35 页)
1. Loss 没变,score function 变了
Linear classifier:
一个 hidden layer 的 FFN:
仍然可以使用 cross-entropy:
区别在于:现在要对 buried inside the network 的 W1 求 gradient。
下面先只考虑单条 sample 的 data loss。
2. Output error:prediction 减 target
令 t 为 one-hot target:
它恰好是 loss 对 output logits 的 gradient:
例如:
则:
3. Output layer 的 gradient
Output layer 读取的是 h,因此:
这与上一节课的公式完全一致,只是把 input x 换成 hidden representation h。
这是 outer product。
如果:
- delta2 的 shape 为 K × 1。
- h 的 shape 为 m × 1。
那么 gradient 的 shape 为:
恰好与 W2 一样。
4. 把 error 传回 hidden representation
一个 hidden unit 会影响多个 output scores。
因此,需要将各条路径的影响加起来:
直觉是:
一个 hidden unit 对最终 loss 的影响,来自它所连接的所有 outputs。
5. 穿过 activation
由于:
根据 chain rule:
其中,符号表示 element-wise multiplication。
对于 ReLU:
- z 大于 0,对应 gradient 可以通过。
- z 小于 0,对应 gradient 被置零。
6. 第一层的 gradient
最后:
Bias gradients 则是:
7. 整个 backpropagation 的四个核心公式
需要记住两个规则:
- 沿一条路径传播:根据 chain rule 乘 local derivatives。
- 多条路径汇合:把各路径的 contributions 相加。
8. 用 PPT 的 tiny network 理解 chain rule
假设:
Forward pass:
为了演示 backward calculation,PPT 给定 upstream gradient:
于是:
对于第一层:
代入:
这里的 upstream gradient 应视为演示给定值。如果严格使用单个 logit 为 6、target 为 1 的 Sigmoid cross-entropy,其 gradient 并不是 -0.5。
重点是理解:gradient 如何沿路径逐步传回前面的 weights。
第七章:Model capacity、overfitting 与 regularization(第 36–39 页)
1. Neural network 的 loss landscape 更复杂
Linear classifier 的直观图像比较简单。
Neural network 中,parameters 相互作用,loss landscape 通常是 nonconvex 的,可能有不同的 valleys、saddle points 等。
PPT 强调,large networks 往往 overparameterized,可能存在许多表现良好的 solutions。
但这并不意味着任意 initialization 都保证找到同样好的结果。
2. 更多 neurons 带来更多 capacity
第 37 页比较了不同数量的 hidden neurons:
| Hidden neurons | 图中表现 |
|---|---|
| 3 | Decision boundary 比较简单 |
| 6 | 能表达更多结构 |
| 20 | 在个别 training points 周围形成小块区域 |
更多 capacity 可以帮助学习复杂 patterns,也可能让模型直接 memorize training samples。
因此:
Training accuracy 高,不代表 generalization 一定好。
3. L2 regularization
惩罚过大的权重,预测变得更平缓
可以在 loss 中加入:
这里对多个 layers 的 weights 分别施加 penalty。
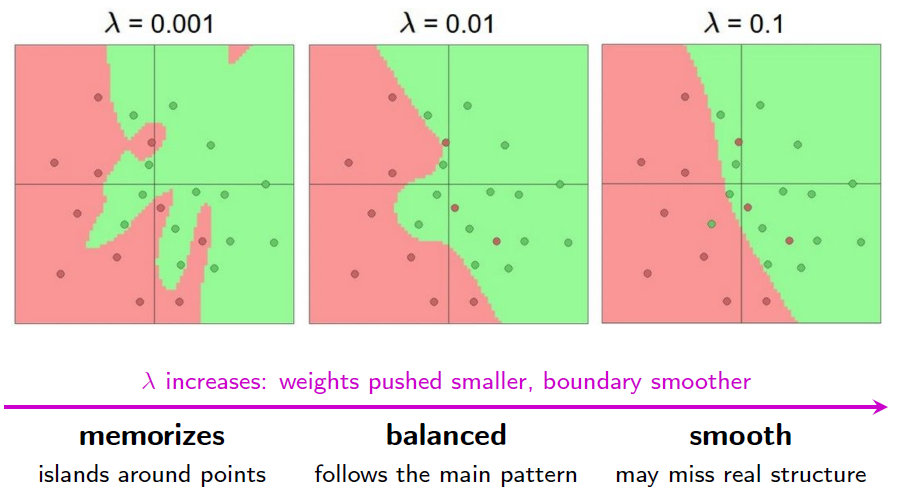
- Regularization 太弱:boundary 可能围绕 individual points 形成小岛。
- 适中的 regularization:保留主要 pattern。
- Regularization 太强:可能错过有效结构,造成 underfitting。
4. Dropout
Dropout 在 training 时随机将部分 hidden activations 置零。
例如:
nn.Dropout(p=0.5)
这里 p 是 drop probability,也就是一个 activation 被置零的 probability。
直觉是:
某个 neuron 不能始终依赖另一个 neuron 存在,因此 network 需要形成更 robust 的 representations。
每次 training forward pass,相当于使用一个不同的 thinned network。
Inference 时则关闭 Dropout,使用完整 network。
PyTorch 默认使用 inverted dropout:
- Training 时对保留的 activations 乘以 1/(1-p)。
- Evaluation 时不再进行这种随机屏蔽或 scaling。
第八章:Deep Averaging Network——PA1 的核心 architecture(第 40–42 页)
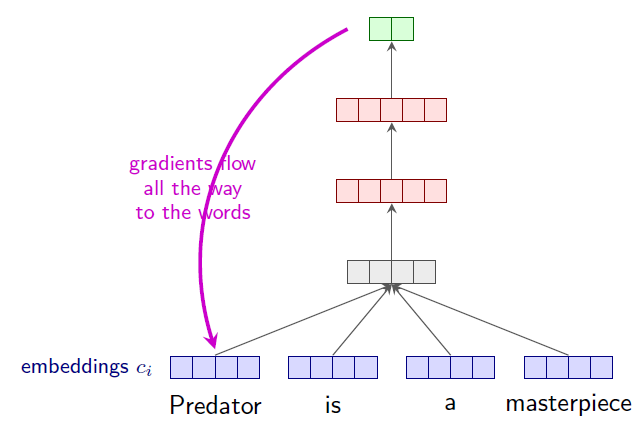
Deep Averaging Network,简称 DAN,是一个简单的 text classification model。
基本流程:
Words → Embeddings → Average pooling → FFN → Class logits
1. 每个 word 对应一个 embedding
例如:
Predator is a masterpiece
对应 embeddings:
每个 embedding 都是一个 dense vector。
与 BoW 不同,embeddings 可以通过训练形成词之间的相似关系,而不是把每个词当成完全无关的 dimension。
2. 对 word embeddings 取平均
如果文本包含 n 个 words:
这样,无论文本多长,都会得到一个 fixed-size vector。
例如,每个 word embedding 是 100-dimensional,平均后的 sentence representation 仍然是 100-dimensional。
3. 接上 FFN
最后使用 cross-entropy loss。
4. Embeddings 也可以学习
当 embedding parameters 没有被冻结时,backpropagation 可以一直传回 embedding layer。
因此,训练不仅调整 classifier,也调整 word representations。
对于 average pooling,传给每个 word embedding occurrence 的 gradient 是:
同一个 word 的多次 occurrences 对共享 embedding parameter 的 contributions 会累加。
Pros & Cons
pros
- Architecture 简单。
- 计算快。
- 支持 variable-length text。
- 能学习 task-specific embeddings。
- 在 PPT 展示的 sentiment analysis results 中,与一些显式建模 syntax 的方法具有竞争力。
这不代表 DAN 在所有 NLP tasks 上都优于这些 models。
cons
忽略 word order, Average pooling 对 word order 不敏感。
例如:
dog bites man
和:
man bites dog
如果使用相同的 word embeddings,平均结果相同。
无论后面的 FFN 多深,都无法从相同的 averaged representation 中恢复已经丢失的 order information。
DAN 的能力同时取决于 embeddings 和 FFN,但受到 averaging representation 的限制。
第九章:Training hyperparameters
1. 三类 hyperparameters
| Category | Examples | 控制什么? |
|---|---|---|
| Architecture | Depth、width、activation | Model 能表达什么 |
| Regularization | L2 strength、dropout rate | 偏好什么样的 solutions |
| Optimization | Learning rate、schedule、batch size、epochs | 如何寻找 parameters |
这些设置根据 validation set 选择。
Test set 用于最终 evaluation,不用于反复调整设置。
2. Learning rate 非常重要
| Learning rate | 可能的表现 |
|---|---|
| 太小 | Loss 下降缓慢 |
| 合适 | Training 能有效推进 |
| 太大 | Overshooting、oscillation,甚至 divergence |
当 performance 明显不达预期时,应优先检查:
- Learning rate 是否合理。
- Network size 是否合适。
- Loss 与 labels 是否匹配。
- 是否存在 implementation bug。
PPT 中关于“小 tweaks 通常提升不到 1%”的说法属于实践经验,不是通用保证。
schedules
训练前期较大的 learning rate 可以帮助快速移动,后期较小的 learning rate 有助于稳定下来。
e.g
- Step decay。
- Cosine decay。
- Warmup + decay。
Warmup 表示从较小的 learning rate 开始,逐渐增大,再进入 decay。
第十章:本节课与整个 text classification pipeline 的联系(第 48 页)
目前已经学到:
Text → Representation → Model → Logits → Probabilities → Loss
Training 时再加入:
Loss → Backpropagation → Gradients → Optimizer update
| Component | 已介绍的方法 |
|---|---|
| Representation | BoW、word embeddings、averaged embeddings |
| Model | Linear classifier、FFN、DAN |
| Probability mapping | Sigmoid、Softmax |
| Loss | NLL、cross-entropy |
| Gradient computation | Backpropagation、autograd |
| Parameter update | Gradient descent 等 optimizers |
| Generalization control | L2 regularization、Dropout |
这一节最重要的变化是:
从手工固定的 features 加 linear classifier,走向由 hidden layers 学习 representations 的 neural network。
但 model 只能利用 input representation 中保留的信息。
最需要掌握的六个问题
- 为什么 single Sigmoid neuron 的 decision boundary 仍然是 linear?
- 为什么没有 nonlinear activation 的多层 network 会 collapse 成一层?
- 一个 layer 的 weight matrix,各个 dimensions 表示什么?
- Backpropagation 为什么沿路径乘 derivatives、在分支处相加?
- Dropout 在 training 和 evaluation 时有什么区别?
- DAN 如何从 variable-length text 得到 fixed-size representation,又丢失了什么信息?