Lesson 4-Learning Part II
上一节课回答:
什么样的 parameters 是我们想要的?答案是:让 loss 尽可能低的 parameters。
这一节课回答:
如何实际找到这些 parameters?
整节课的主线是:
Loss landscape → Gradient → Analytic gradient → Gradient descent → Minibatch → Backpropagation
把 learning 理解为在 loss landscape 中寻找低点(第 3–8 页)
1. Loss 是 parameters 的函数
上一节课定义了 training loss:
Training dataset 固定后,换一组 weights,就会得到一个不同的 loss。
因此,可以把 loss 看成关于 weights 的函数。
为了方便画图,假设模型只有两个 weights:
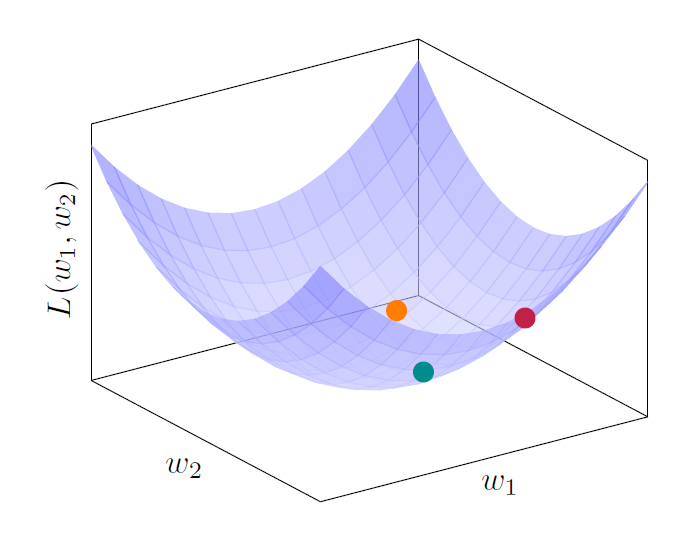
这时:
- 横向两个方向对应两个 weights。
- 高度对应 loss。
- 每个位置代表一组不同的 parameters。
这张曲面就叫 loss landscape。
- 高处:loss 大,当前 parameters 对 training data 的预测较差。
- 低处:loss 小,当前 parameters 对 training data 的预测较好。
- Learning:不断调整 parameters,往更低的位置移动。
它的 minimum 在:
注意,这只是帮助理解的 toy function,不是实际的 Softmax loss。
2. Data space 和 parameter space 不一样
第 8 页特别区分了两种空间:
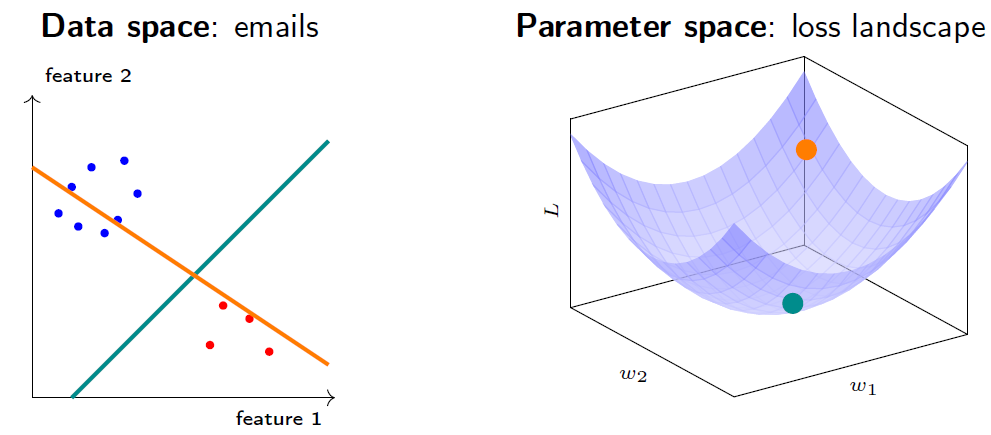
| Space | 一个点代表什么? |
|---|---|
| Data space | 一条 sample,例如一封邮件 |
| Parameter space | 一组 parameters,也就是一个 classifier |
在 parameter space 中移动,表示改变 classifier 的 weights。
对应到 data space,就是 classifier 的 decision boundary 在变化。
不是邮件在移动,而是模型在改变。
如何决定 parameters 的更新方向?(第 9–14 页)
1. Random search
最直接的方法是:
- 随机生成一组 parameters。
- 计算 loss。
- 再随机生成另一组。
- 保留目前 loss 最低的一组。
这个方法把 loss function 当成 black box。
问题是:parameters 很多时,可能的组合极其庞大。Random search 没有充分利用当前位置附近的信息。
2. Iterative improvement
另一种思路是:
- 从一组 initial parameters 开始。
- 判断当前位置往哪个方向移动,可以降低 loss。
- 移动一小步。
- 在新位置重新判断。
关键问题变成:
如何知道哪个方向会降低 loss?
答案是计算 gradient。
3. 从一维 derivative 理解
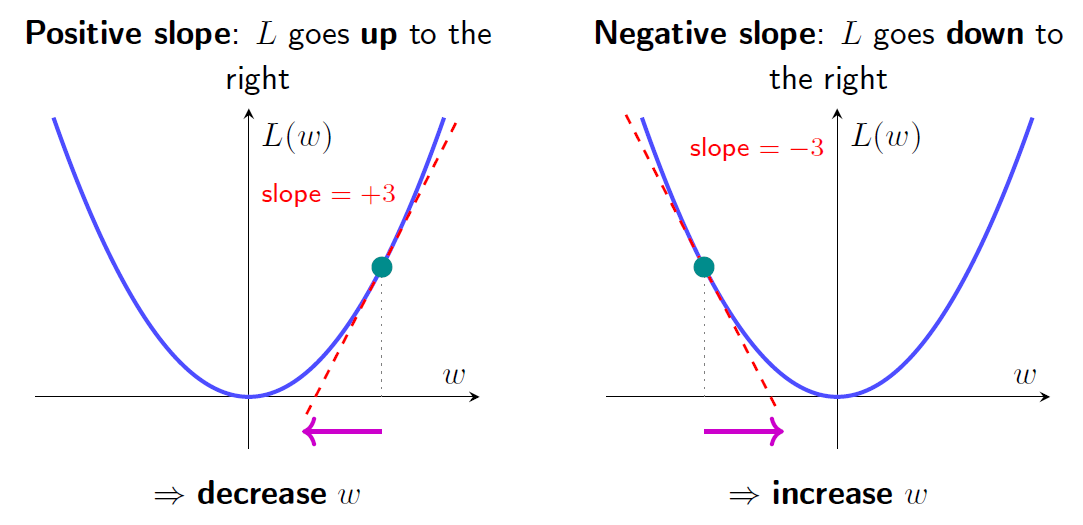
考虑:
它的 derivative 是:
如果当前位置为:
那么:
Derivative 为正,说明增加 w 会让 loss 上升,因此应该减小 w。
如果当前位置为:
那么:
Derivative 为负,说明增加 w 会让 loss 下降,因此应该增大 w。
两种情况都可以用同一条 update rule:
其中 eta 是 learning rate,控制每次移动的大小。
更新时减去 derivative,而不是直接减小 weight。Weight 可能增加,也可能减小。
Numerical gradients——通过小幅扰动估计 gradient(第 15–20 页)
1. Derivative 的定义
一维情况下:
实际计算时,可以选择一个很小但不为零的 h:
这叫 finite difference。
直觉是:
稍微改变一个 parameter,观察 loss 改变了多少。
2. Derivative、partial derivative 和 gradient
| Term | 含义 |
|---|---|
| Derivative | 一维函数沿唯一输入方向的变化率 |
| Partial derivative | 只改变一个 parameter、固定其他 parameters 时的变化率 |
| Gradient | 把所有 partial derivatives 放在一起 |
如果模型有两个 weights:
在通常的 Euclidean geometry 下,gradient 指向局部 steepest increase 的方向。
因此,negative gradient 给出了局部 steepest decrease 的方向。
3. PPT 中的 numerical example
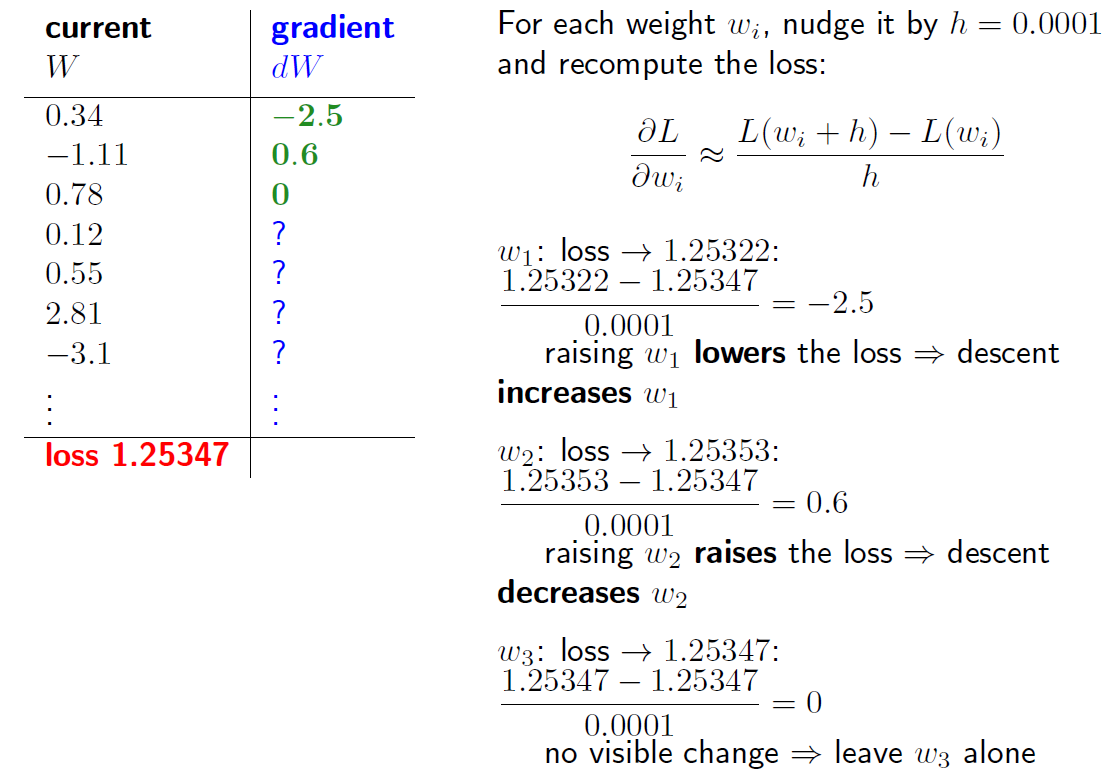
当前 loss:
取:
只增加第一个 weight 后,loss 变成:
这里,e1 表示只改变第一个 coordinate。
于是:
这说明:
- 增加第一个 weight,会降低 loss。
- Gradient descent 会增加这个 weight。
对于第二个 weight:
这说明:
- 增加第二个 weight,会提高 loss。
- Gradient descent 会减小这个 weight。
为什么 numerical gradients 不适合大模型?
假设有 d 个 parameters。
按照这里的 forward finite difference,每个 parameter 都要单独扰动一次,所以一次完整 gradient 计算需要约: 次 loss evaluations。
PPT 的例子有 30,730 个 weights,需要 30,731 次 loss evaluations。
如果每次 loss evaluation 还要遍历整个 training dataset,就非常昂贵。
Numerical gradients 的主要问题是:
- Computational cost 高。
- 只是 approximation。
- 结果受 h 和 floating-point precision 影响。
因此,训练时通常使用 <span style="color: red;"> analytic gradients</span>
补充:numerical gradients 仍可用于 gradient checking,检查另一种 gradient 实现是否正确。
Analytic gradients——推导 Softmax loss 的 gradient(第 21–25 页)
Analytic gradient 直接利用 calculus,根据 loss 的表达式推导。
这里先分析一条 training sample,并暂时省略 bias 和 regularization。
推不明白,先贴一下ppt吧
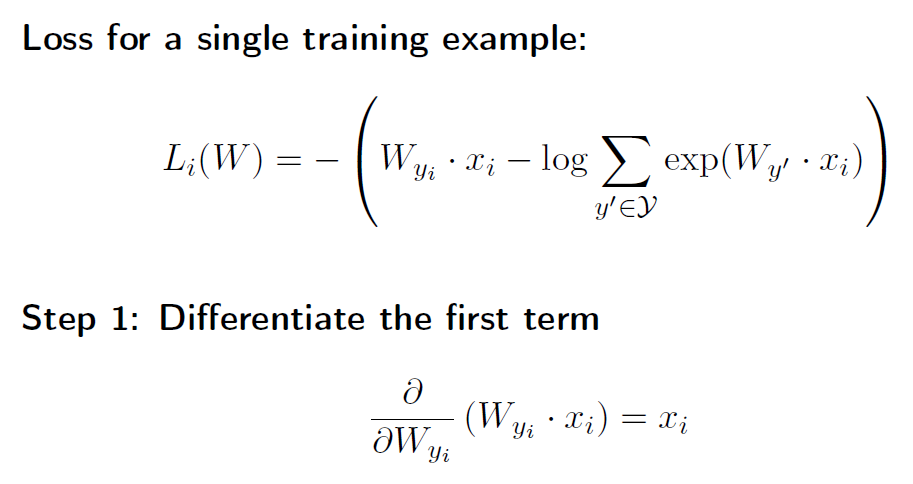
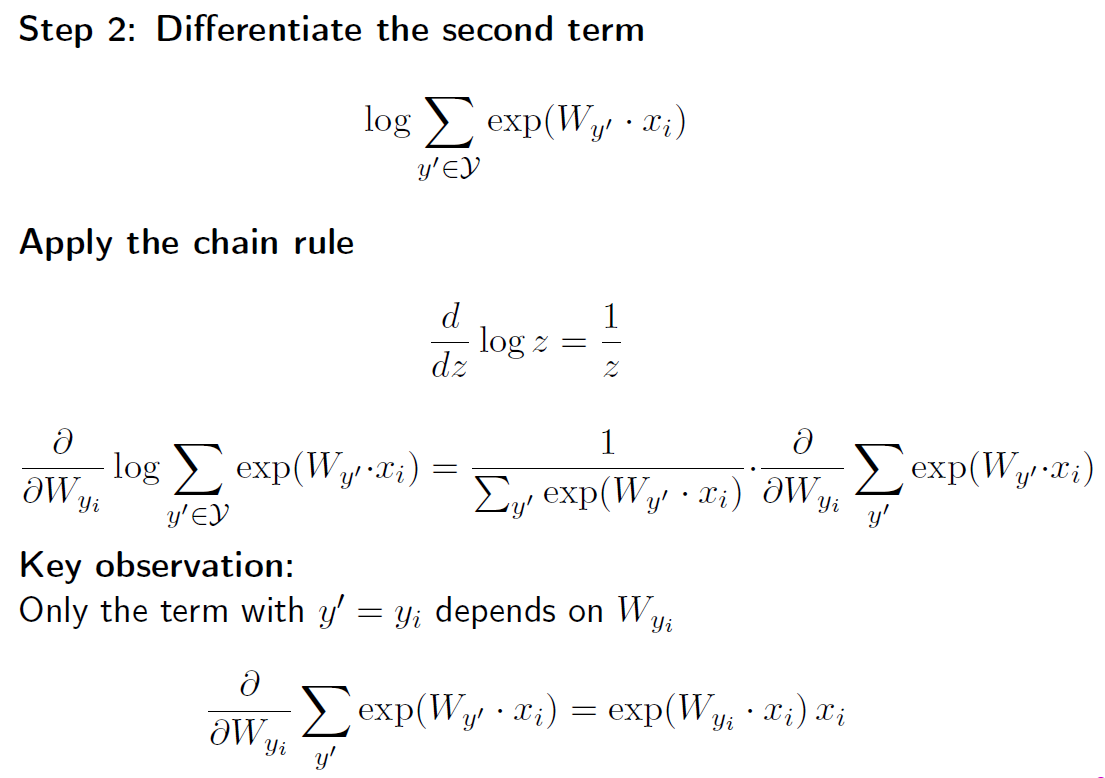
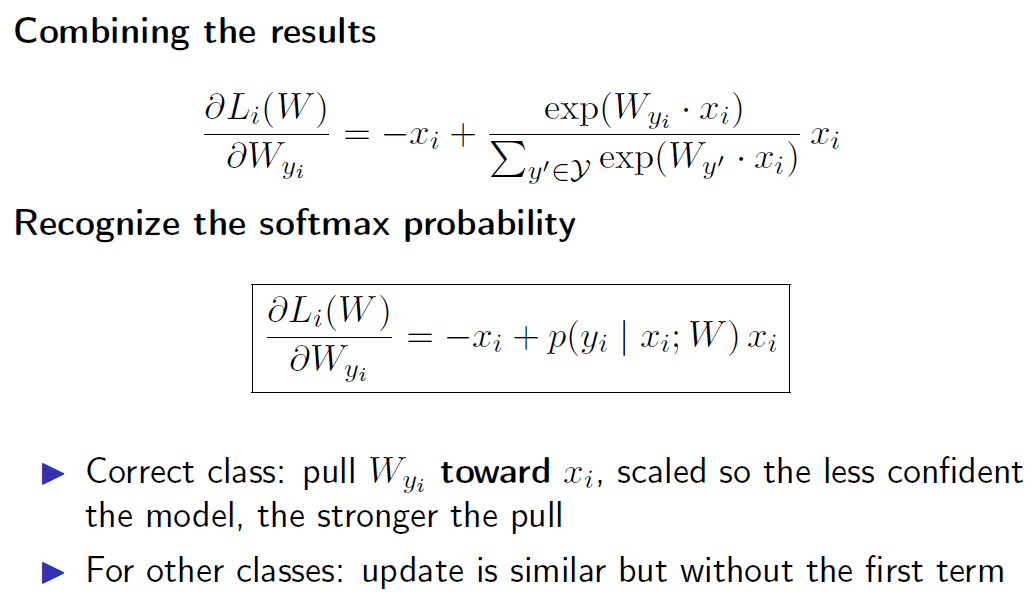
1. 写出 class score
第 k 个 class 的 weight vector 是 Wk:
Softmax probability:
单条 sample 的 loss:
2. 展开 loss
利用 log 的性质:
现在有两项:
- Ground-truth class 的负 score。
- 所有 classes scores 对应的 log-sum-exp。
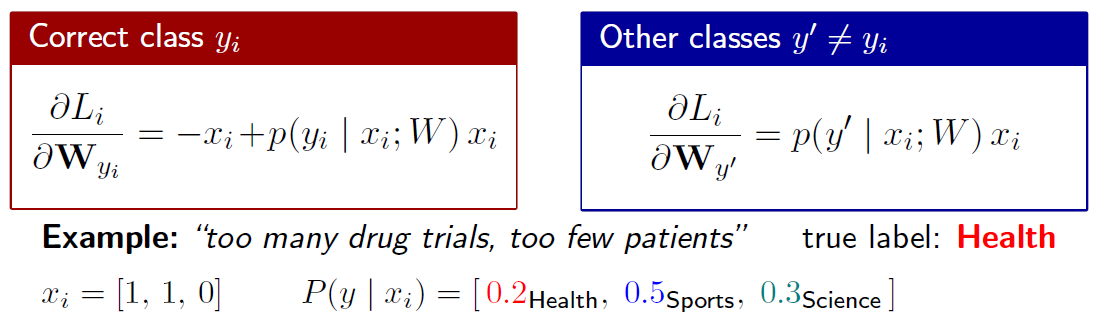
3. 对 ground-truth class 的 weights 求 gradient
第一项的 gradient:
第二项通过 chain rule 得到:
因此:
4. 对其他 classes 的 weights 求 gradient
当 k 不是 ground-truth class 时,第一项与 Wk 无关,所以:
5. 统一公式
引入 one-hot target tk:
- Ground-truth class 对应 tk = 1。
- 其他 classes 对应 tk = 0。
那么:
这个公式非常重要:
Gradient = prediction 与 target 的差异,乘以 input features。
第五章:这些 gradients 如何让 classifier 学会分类?(第 26–30 页)
1. Ground-truth class 的 update
对 ground-truth class:
等价于:
也就是沿着 input vector 的方向增加 class weights。
这样通常会提高该 sample 对 ground-truth class 的 score。
而且:
- 正确类别的 probability 越低,update 越强。
- 正确类别的 probability 越接近 1,update 越弱。
2. 其他 classes 的 update
对于其他 classes:
也就是降低这些 classes 对当前 input 的 score。
模型错误分配给某个 class 的 probability 越大,对它的调整也越强。
这解释了为什么 class weight vectors 可以被理解为 templates:
- 向自己类别的 examples 靠近。
- 远离其他类别的 examples。
3. text classification example
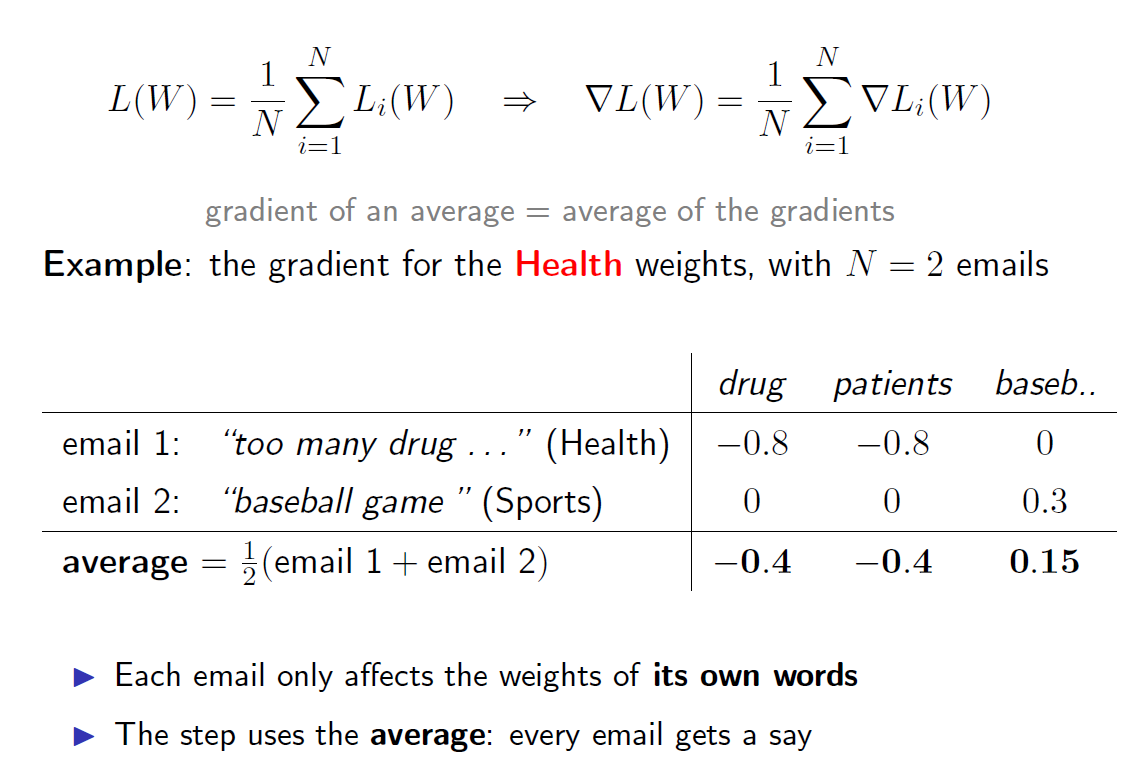
输入邮件:
too many drug trials, too few patients
使用三个 binary features:
| Feature | Value |
|---|---|
| drug | 1 |
| patients | 1 |
| baseball | 0 |
 | |
| 所以: |
Ground-truth class 是 Health,但模型预测为:
顺序是 Health、Sports、Science。
One-hot target:
根据统一公式:
假设 learning rate 为 0.1,实际的 weight changes 是:
| Class | Gradient | Weight change |
|---|---|---|
| Health | [-0.8, -0.8, 0] | [+0.08, +0.08, 0] |
| Sports | [0.5, 0.5, 0] | [-0.05, -0.05, 0] |
| Science | [0.3, 0.3, 0] | [-0.03, -0.03, 0] |
因此:
- drug、patients 对 Health 的 weights 增加。
- drug、patients 对 Sports、Science 的 weights 减小。
- baseball 的 weights 不受这条 sample 的 data loss 影响,因为对应 feature 为 0。
注意:如果加入 L2 regularization,即使某个 feature 为 0,对应 weight 仍可能因 regularization term 而变化。
4. 从单条 sample 推广到整个 dataset
完整 loss 是各 sample losses 的平均:
因此:
也就是:
Gradient of an average = average of the gradients。
每条 sample 提供自己的调整意见,完整 update 使用这些意见的平均值。
Gradient descent 与 learning rate(第 31 页)
有了 gradient,就可以执行 gradient descent:
- Initialize parameters。
- 计算当前 gradient。
- 沿 negative gradient 更新 parameters。
- 重复计算与更新。
核心公式:
Learning rate 的作用
| Learning rate | 可能的效果 |
|---|---|
| 太小 | 每次 update 很小,训练缓慢 |
| 合适 | 能够逐步降低 loss |
| 太大 | 可能越过低点,产生 oscillation 或 divergence |
因此,negative gradient 只是提供局部方向,不能保证任意大小的 step 都会降低 loss。
实际 update 的大小取决于两个因素:
在固定 learning rate 下,如果接近某个 minimum 时 gradient 逐渐变小,updates 也会自然变小。
PPT 用“loss 不再下降”说明停止条件。实际训练还可以根据 validation performance、gradient magnitude 或 training budget 决定何时停止。
Minibatch gradient descent(第 32 页)
1. Full-batch gradient descent 的问题
如果 training dataset 有一百万封邮件,每次 update 都遍历一百万封邮件,成本很高。
Full gradient 是:
2. 使用 minibatch 估计 full gradient
每次随机抽取一个 minibatch B,例如 32、64 或 256 条 samples:
然后更新:
不需要每次都看完所有 training samples。
3. 为什么可以这样做?
上一节课已经用 training dataset 的平均值近似 data distribution 上的 expectation。
这里再用 minibatch 的平均值近似整个 training dataset 的平均值。
也就是:
Population expectation → Dataset average → Minibatch average
在合适的随机 sampling 下,minibatch gradient 是 full gradient 的 unbiased estimate。
但每次抽到的 samples 不一样,因此 updates 会带有 noise,loss 不一定每一步都下降。
4. 三种常见情况
| Method | 每次 update 使用多少 samples? |
|---|---|
| Full-batch gradient descent | 整个 training dataset |
| Minibatch gradient descent | 一小批 samples |
| Stochastic gradient descent(SGD) | 严格来说,每次 1 条 sample |
实际使用中,SGD 这个名称也经常用于 minibatch updates。
第八章:Backpropagation 与 gradient descent 的区别(第 33 页)
这两个概念经常被混在一起,但负责不同的事情。
| Concept | 负责什么? |
|---|---|
| Backpropagation | 高效计算 loss 对 parameters 的 gradients |
| Gradient descent | 使用 gradients 更新 parameters |
| Autograd | 自动完成 differentiation 的系统 |
Backpropagation 基于 chain rule,并且会复用 intermediate computations。
本节课手工推导了 Softmax loss 的 gradient。对于更复杂的模型,也可以沿 computational graph 应用 chain rule。
可以把训练过程写成:
Forward computation → Loss → Backpropagation → Gradients → Parameter update
为什么两者不能等同?
Backpropagation 算完 gradient 后,还没有更新 parameters。
Gradient descent 使用这些 gradients,执行:
同一组 gradients 也可以交给其他 optimizers,例如 Momentum 或 Adam。
因此:
Backpropagation 解决“gradient 怎么算”,optimizer 解决“parameters 怎么更新”。
第九章:为什么还需要 neural networks?(第 34–36 页)
前面一直在优化 linear classifier。
但即使找到了 model family 中最好的 parameters,也不代表能正确分类所有 samples。
原因可能是:
当前 model family 本身无法表达需要的 decision boundary。
PPT 中,即使调整到一条很好的直线,仍然有一些 green points 落在 red region 中。
继续移动直线可能无法解决这个问题,需要能够弯曲的 decision boundary。
Linear classifiers 的优点
- Simple。
- Fast。
- Interpretable。
- 当 classes linearly separable 时表现良好。
Linear classifiers 的限制
对于当前 input features,它们不能表达复杂的 nonlinear decision boundaries。
这里要区分两个问题:
| Problem | 含义 |
|---|---|
| Optimization problem | 当前 model family 能做到,但没有找到好的 parameters |
| Model capacity limitation | 当前 model family 本身表达不了所需关系 |
如果问题来自 model capacity,单纯增加 gradient descent steps 不一定有帮助。
下一步会引入 feedforward neural networks,扩大 model family。
但基本训练逻辑仍然沿用:
Define loss → Compute gradients → Update parameters
本节课最需要掌握的内容
1. Gradient 的含义
Gradient 表示当前位置 loss 局部上升的方向;gradient descent 沿相反方向移动。
2. Softmax loss 的核心 gradient
Prediction 与 target 的差异,决定 update 的方向和强度。
3. Gradient descent 的 update rule
4. Full gradient 与 minibatch gradient
Full gradient 使用整个 training dataset;minibatch gradient 使用一小批 samples 进行估计。
5. Backpropagation 与 optimization 的分工
Backpropagation 计算 gradients;optimizer 使用 gradients 更新 parameters。
6. 两节课的联系
| Lecture | 核心问题 | 主要答案 |
|---|---|---|
| Learning Part I | 应该 optimize 什么? | Cross-entropy loss,加上 regularization |
| Learning Part II | 如何 optimize? | 计算 gradients,使用 gradient-based updates |