Lesson 3-Learning Part I
这节课主要回答一个问题:
已经有了一个能给类别打分的 linear classifier,我们应该用什么目标来学习它的 parameters?
整节课的主线是:
KL divergence → Maximum Likelihood Estimation → Softmax loss → Regularization
从 prediction 走向 learning(第 1–6 页)
前面介绍了 text classification 的基本流程:
- 把文本转换成 feature vector,例如 Bag-of-Words(BoW)。
- 用 linear classifier 计算各类别的 scores:
例如,一封邮件得到:
| Class | Score |
|---|---|
| Spam | 3.2 |
| Personal | 5.1 |
| Work | -1.7 |
模型会选择 score 最高的 Personal。
但这个公式只告诉我们如何 prediction,还没有告诉我们如何 learning:什么样的 才是好的?
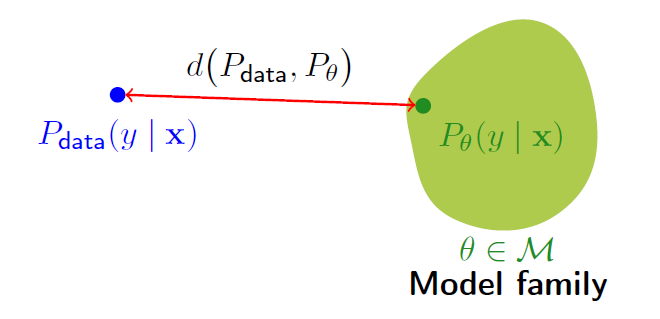
PPT 从 probability distribution 的角度定义目标:
其中:
- :真实世界中,给定文本 时各 label 的 probability。
- :模型预测的 probability。
- :模型的 parameters。
Learning 的目标,就是调整 parameters,让 model distribution 尽量接近 data distribution。
但是我们看不到完整的 data distribution,只能看到有限的 training dataset。
用 KL divergence 衡量 distributions 的差异(第 7–11 页)
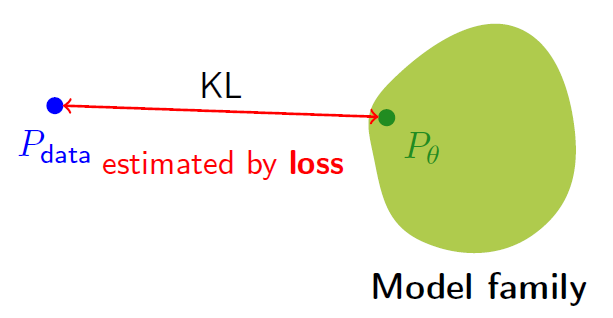
先固定一封邮件,比较它对应的两组 label probabilities:
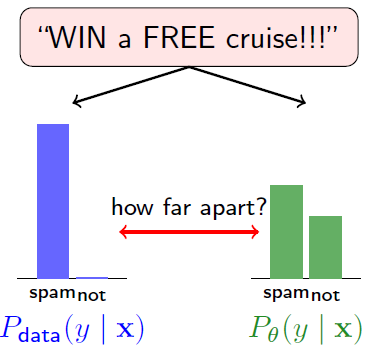
| Label | Data distribution p | Model distribution q |
|---|---|---|
| Spam | 0.9 | 0.4 |
| Not spam | 0.1 | 0.6 |
模型低估了 Spam 的 probability。我们需要一个数衡量这种差异。
PPT 使用 Kullback–Leibler divergence,简称 KL divergence:
is every label y of one input
可以理解为:
按照真实的 probability 加权,衡量 model distribution 与 data distribution 的差异。
它有三个重要性质:
- KL divergence 非负。
- 两个 distributions 相同时,KL divergence 为 0。
- 它不满足 symmetry,交换两个 distributions 后,结果通常不同。
<span style="color: #66ccff;">KL divergence 是“以一个 distribution 为基准,衡量另一个 distribution 和它的差异”交换两个 distribution,基准也变了</span>
因此,KL divergence 不是通常数学意义上的 distance。
为什么要乘 p(y)?
因为真实情况下更常出现的 label,应该在比较中占更大的权重。
例如,真实情况下 Spam 的 probability 为 0.9,那么模型对 Spam 的预测就应当占较大权重。
从一封邮件推广到所有邮件
模型需要处理不同的 inputs,因此还要对输入取 expectation:
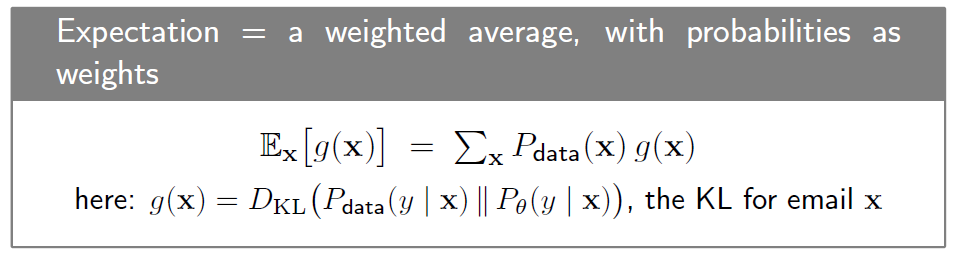
Expectation 就是按照出现的 probability 计算 weighted average。
这里有两层平均:
- KL 内部,对一封邮件的不同 labels 加权。
- 外部 expectation,对不同邮件加权。
训练目标是 minimize 这个平均 KL divergence。
从 KL divergence 推到 MLE(第 12–15 页)
这是本节课最核心的推导。
⭐ 展开平均 KL divergence, 利用 log 的性质,把右边拆成两项:
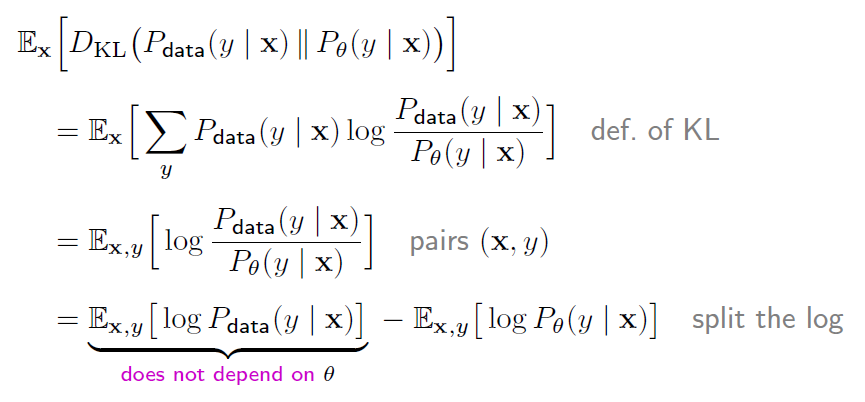
第一项只取决于 data distribution,与 parameters 无关。调整模型不会改变这一项。
因此:
Minimize average KL divergence,等价于 maximize expected log-likelihood。
也就是:
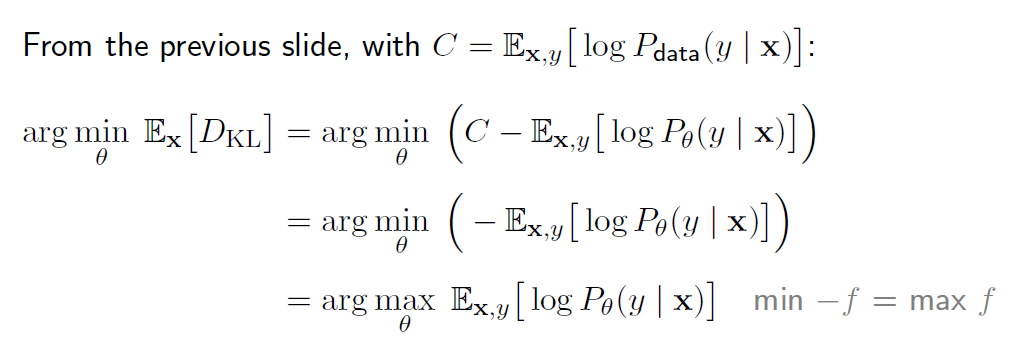
Asks Pθ to give high probability to the labels that actually occur
Problem: the expectation is still over Pdata, which we don’t have
Maximum Likelihood Estimation(MLE)
对于真实观察到的 input–label pair,我们希望模型给正确 label 更高的 probability。
例如,一封邮件的 ground-truth label 是 Spam:
- 给 Spam 的 probability 为 0.9,比较好。
- 给 Spam 的 probability 为 0.1,比较差。
由于 data distribution 未知,我们无法直接计算 expectation。
但可以用 training dataset 上的平均值近似:
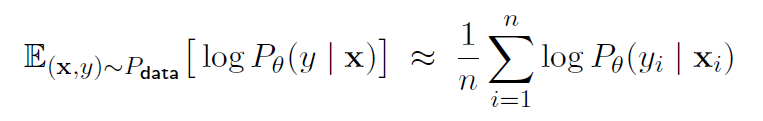
这是 Monte Carlo estimate。
于是得到 Maximum Likelihood Estimation(MLE):
其中,argmax 表示找到让目标最大的那组 parameters。
min KL ⇒ max expected log-likelihood ⇒ max average over D = MLE
why likelihood?
在 samples 相互独立的通常假设下,给定这些 inputs,观察到整组 labels 的 likelihood 是:
取 log,把乘积转换为求和:
因为 log 是 monotonically increasing,maximize likelihood 与 maximize log-likelihood 会得到相同的最优 parameters。
除以固定的 sample 数量,也不会改变最优 parameters。
MLE 就是选择一组 parameters,让已经观察到的 training labels 尽可能有可能出现。
Softmax 把 logits 转成 probabilities(第 16–17 页)
MLE 要求模型输出 probabilities,但 linear classifier 输出的是 logits:
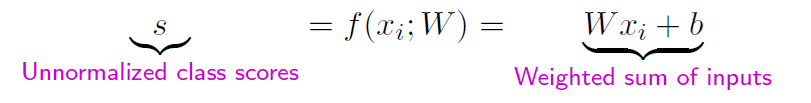
Logits 可以为负,而且总和不一定为 1,不能直接当成 probabilities。
Softmax 完成这个转换:
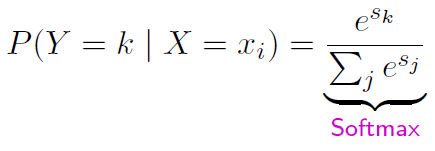
计算过程分两步:
- 对每个 logit 取 exponential,让结果为正。
- 进行 normalization,让所有 probabilities 的总和为 1。
PPT 中的例子:
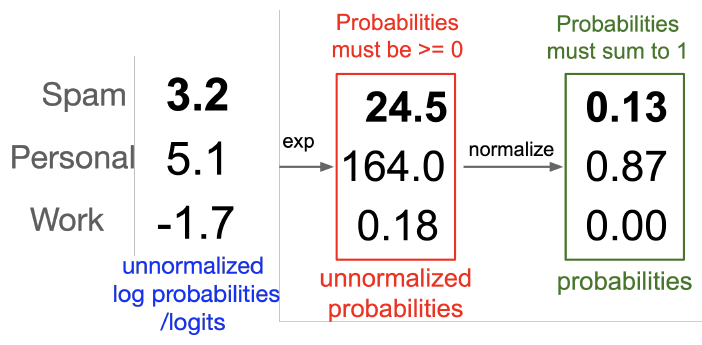
模型认为 Personal 最有可能。
注意:
- Softmax 不改变 logits 的排序。最高的 logit 对应最高的 probability。
- 表格中的 probabilities 经过 rounding,总和可能不恰好等于 1。PT 中 Work 显示为 0.00,是 rounding 的结果,实际并不等于零。
整个 prediction 流程是:
文本 → Feature vector → Linear classifier → Logits → Softmax → Probabilities
Softmax 提供了 MLE 所需的 probabilities,但它本身还不是 loss function。
从 MLE 得到 Softmax loss(第 18–21 页)
MLE 的目标是 maximize average log-likelihood:
训练时通常写成 minimize loss,因此加一个负号:
对单个 sample:
这叫 <span style="color: red;">negative log-likelihood(NLL)</span>。
代入 Softmax:
这里,分子使用的是 ground-truth class 对应的 logit,而不是 predicted class 对应的 logit。
例子:ground-truth 是 Spam
模型给 Spam 的 probability 只有约 0.13:
不同 probabilities 对应的 loss:
| Ground-truth class probability | NLL |
|---|---|
| 0.99 | 0.010 |
| 0.90 | 0.105 |
| 0.50 | 0.693 |
| 0.10 | 2.303 |
| 0.01 | 4.605 |
给 ground-truth class 的 probability 越高,loss 越低。
因此,这个 loss 不仅看 classification 是否正确,还考虑模型给正确答案分配了多少 probability。
与 cross-entropy 的关系
如果 ground-truth label 用 one-hot vector 表示,cross-entropy 为:
其中:
- 正确类别对应的 one-hot entry 为 1。
- 其他类别对应的 entries 为 0。
所以求和后只剩一项:
因此,在这个 classification setting 中:
Softmax loss = Cross-entropy applied to Softmax probabilities = NLL
初始化时的 loss
第 21 页中,初始化的 weights 很小,产生的 logits 比较接近:
Softmax probabilities 也接近 uniform distribution:
如果 ground-truth 是 Spam:
更一般地,如果有 K 个 classes,每个 class 的 probability 都约为:
那么初始 loss 大约为:
这个关系可以帮助判断刚开始训练时的 loss 是否合理。
Regularization 与 generalization(第 22–29 页)
纯 MLE 只要求提高 training dataset 上的 likelihood。
但 training dataset 是有限的,其中可能包含 noise 或偶然出现的规律。
例如,一个少见词恰好只在 training dataset 的 Spam 邮件中出现,模型可能给它特别大的 weight。但这个规律在 unseen data 上未必成立。
这可能造成 overfitting:
Training performance 很好,但在 unseen data 上表现较差。
我们真正希望获得的是 generalization:模型能够在 unseen data 上做好 prediction。
1. Regularization 的直觉
第 25–26 页比较了两种拟合方式:
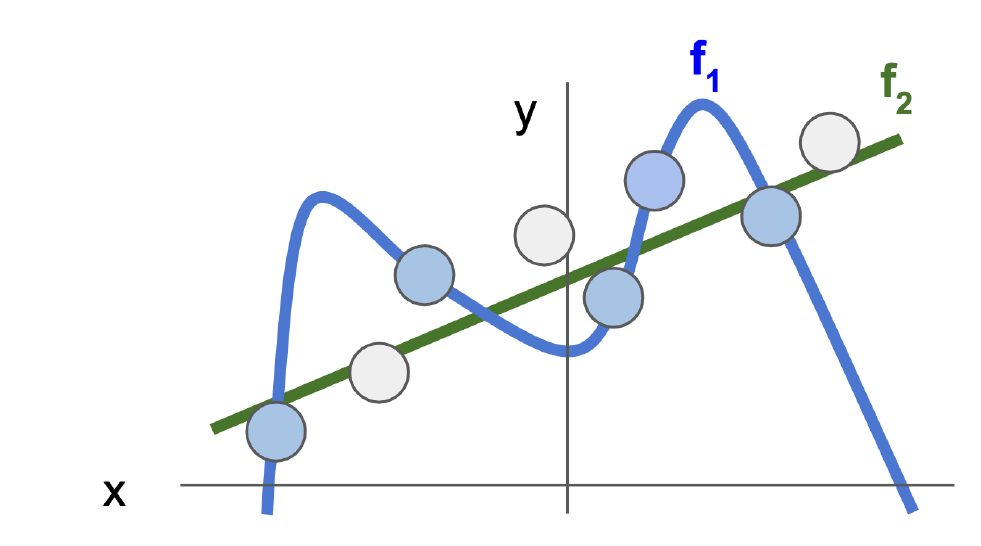
- 蓝色曲线弯曲明显,紧贴 training points。
- 绿色直线没有完全贴合 training points,但可能更接近整体趋势。
Regularization 为 learning 加入一种偏好:在拟合 training data 的同时,限制某些形式的 model complexity。
目标变为:
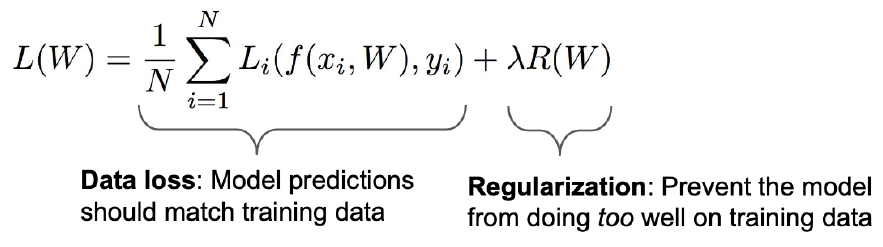
其中:
- 第一项是 data loss,要求模型符合 training labels。
- 第二项是 regularization term,对 parameters 施加约束。
- lambda 控制 regularization 的强度。
▶ λ = 0: No regularization
▶ λ = ∞: Only care about regularization
▶ λ = 0.5: Balance between fitting the data and regularization
较小 | 对 weights 的约束较弱
较大 | 对 weights 的约束较强
过大 | 可能造成 underfitting |
Underfitting 指模型受到过强限制,连 training data 中的有效规律也没有充分学到。
通常使用 validation set 选择 lambda。
PPT 中的 0.5 只是例子,不是通用的最佳值;实际效果还取决于 features 的尺度和 loss 的定义。
2. L2 regularization
L2 regularization 把所有 weights 的平方加起来:
对于矩阵 W,更严格的 notation 是 Frobenius norm squared:
大 weights 会受到更强的 penalty:
| Weight | 对 L2 penalty 的贡献 |
|---|---|
| 0.1 | 0.01 |
| 1 | 1 |
| 10 | 100 |
因此,L2 regularization 鼓励模型使用幅度较小的 weights。
4. 其他方式
| Method | 基本作用 |
|---|---|
| L1 regularization | 惩罚 weights 的绝对值之和,常用于鼓励 sparsity |
| Dropout | 训练时随机屏蔽部分 units |
| Layer normalization | 主要改善训练稳定性,也可能影响 generalization |
L1 regularization 的公式为:
注意,Layer normalization 与直接加入 L1、L2 penalty 的机制不同。
本节课的完整 training objective(第 30–32 页)
把 linear classifier、Softmax、NLL 和 L2 regularization 合在一起:
这个公式包含四个部分:
- Linear classifier:计算各类别的 logits。
- Softmax:把 logits 转换成 probabilities。
- NLL:惩罚 ground-truth class probability 过低。
- L2 regularization:限制 weights 的幅度。
| Concept | 回答的问题 |
|---|---|
| KL divergence | Model distribution 与 data distribution 差多少? |
| MLE | 如何根据 training samples 选择 parameters? |
| Softmax | 如何把 logits 转换成 probabilities? |
| NLL / Cross-entropy | 如何评价 ground-truth class 的 probability? |
| Regularization | 如何限制 overfitting,帮助 generalization? |
这节课定义了 training objective。下一节课讨论 optimization:如何实际更新 parameters,让 loss 降低。