Lesson 2-Text Classification with Linear Models
1. 文本分类的基本概念(第 4–10 页)
文本分类:给定一段文本,从预先定义的标签中选择它所属的类别。
常见任务:
- Sentiment analysis:正面 / 负面。
- Spam(垃圾邮件) detection:Spam / Not spam。
- Topic classification:体育 / 政治 / 科技。
- Language identification:中文 / 英文等。
- Authorship attribution:根据文章的语言特征判断作者。
分类任务的类型
| Binary classification(二分类) |
|---|
| Multi-class classification(多分类) |
| Multi-label classification(多标签分类) |
为什么使用机器学习?
writing rules 难以覆盖文本的多样性:
- 同一类别可以有很多表达方式。
- 计算机不会天然理解词语的含义与关系。
机器学习的基本流程:learn them from data
- 收集文本及其标签。
- 使用训练集训练分类器。
- 使用未见过的测试数据评估模型。
假设样本来自未知的数据分布 :
Generalization:模型能正确预测来自同一分布的新样本。
2. 文本表示:Bag of Words (BoW)(第 11–14 页)
机器学习模型需要 numerical input,因此先将文本转换成特征向量:
表示方式 决定模型能看到什么;被表示过程丢掉的信息无法由分类器恢复。
Bag of Words(BoW,词袋模型)
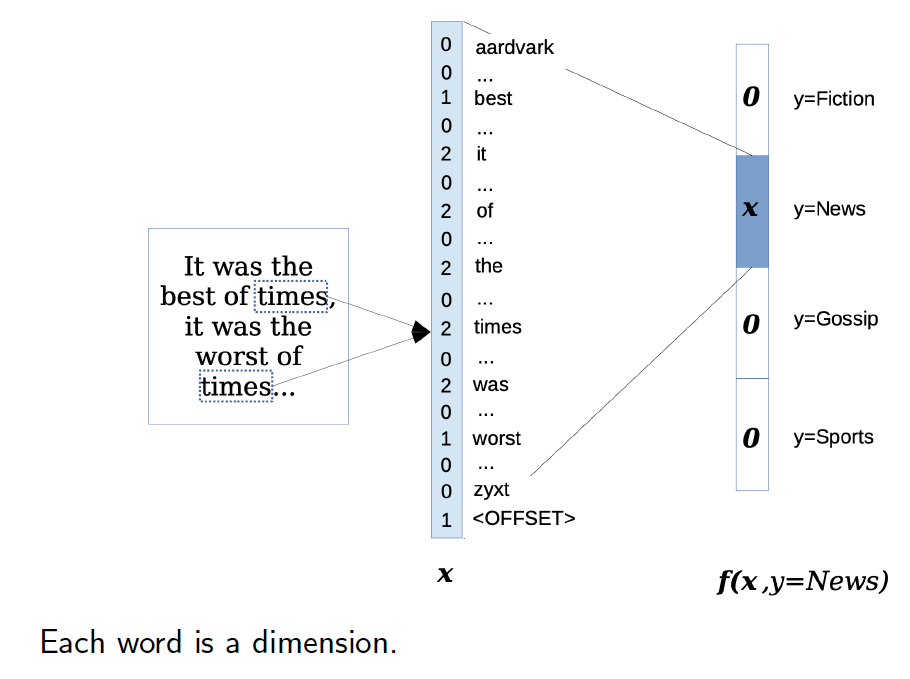
步骤:
- 建立词表。
- 每个词对应向量的一维。
- 用词在文本中的出现次数作为该维度的数值。
例如,词表为 [good, bad, movie]:
good good movie → [2, 0, 1]
bad movie       → [0, 1, 1]
BoW 保留词频,但不保留词序。
- 高维且稀疏:词表很大,但单个文本只包含少量词,大部分维度为 0。
- 丢失句子结构:不保留词序,难以表达否定词的作用范围。
- 缺少语义关系:
good和great是不同维度,不会天然被视为近义词。
例如,下面两句话词频相同,但情感不同:
The movie was not good, it was bad.
The movie was not bad, it was good.
VS one-hot
one-hot 用一个向量表示一个词
向量长度等于 vocabulary size,只有对应词的位置是 1,其他位置都是 0:
I     → [1, 0, 0, 0]
love  → [0, 1, 0, 0]
cats  → [0, 0, 1, 0]
dogs  → [0, 0, 0, 1]
句子 I love cats 可以表示为一个 one-hot vector sequence:
[1, 0, 0, 0]   ← I
[0, 1, 0, 0]   ← love
[0, 0, 1, 0]   ← cats
这里保留了每个词的位置,因此保留了 word order。
3. 最近邻分类器与 k-NN(第 15–23 页)
1-NN:最近邻分类
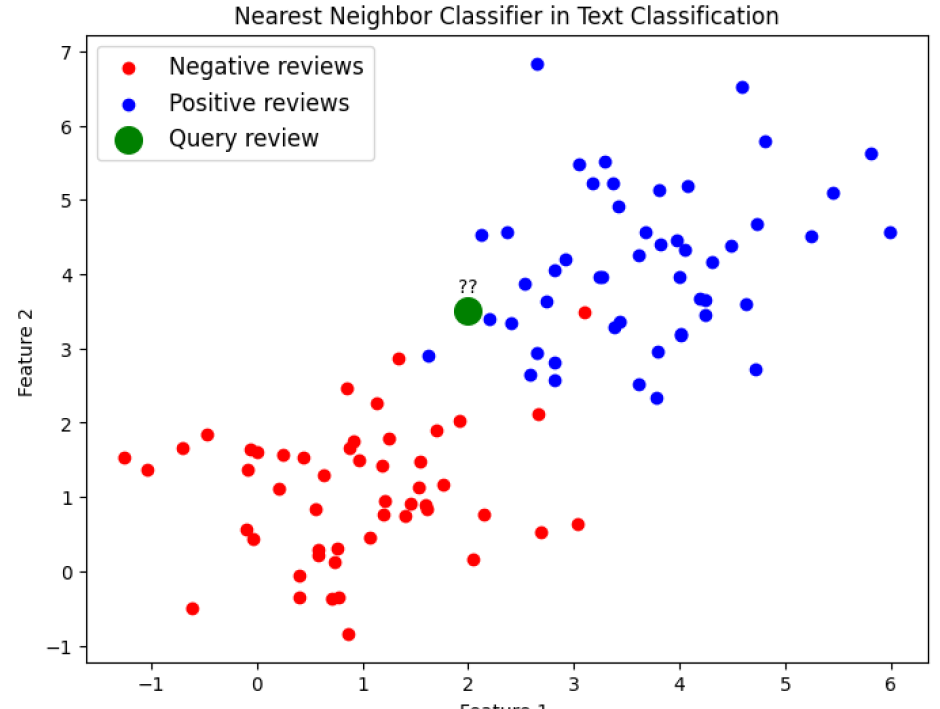
对于一个新文本:
- 将它转换成向量。
- 找到距离最近的训练样本。
- 使用该样本的标签作为预测结果。
课件使用 L1 距离:
即:各维度的差取绝对值后求和。
k-NN:多个邻居投票
1-NN 容易受噪声或异常样本影响,因此可以改用最近的 个样本进行major vote。
例如,最近 5 个样本中:
- 3 个属于 Spam。
- 2 个属于 Not spam。
最终预测为 Spam。
computation cost
- 训练阶段:主要保存训练样本,不需要优化参数。
- 预测阶段:需要搜索训练样本,数据越多,预测越慢。
课件简化为训练 、预测 。
考虑特征维度 时,朴素预测的距离计算约为 。
4. 超参数与数据集划分(第 24–26 页)
超参数(Hyperparameters)是需要人为选择的模型设置。
k-NN 的超参数包括:
- 邻居数量 。
- 距离度量。
- 文本表示方式。
如何选择超参数?
原则:用验证集调参,测试集留到最终评估。
| 数据集 | 用途 |
|---|---|
| Training set(训练集) | 学习模型,或作为 k-NN 的邻居集合 |
| Validation set(验证集) | 选择超参数 |
| Test set(测试集) | 最终评估泛化能力 |
不能根据训练集表现选择超参数:
- 1-NN 查询训练样本时,最近邻通常是样本自己。
- 高训练准确率不代表高泛化能力。
不能反复根据测试集调参:
- 这会利用测试集的信息。
- 最终成绩不再是独立评估。
5. 线性分类器(第 27–35 页)
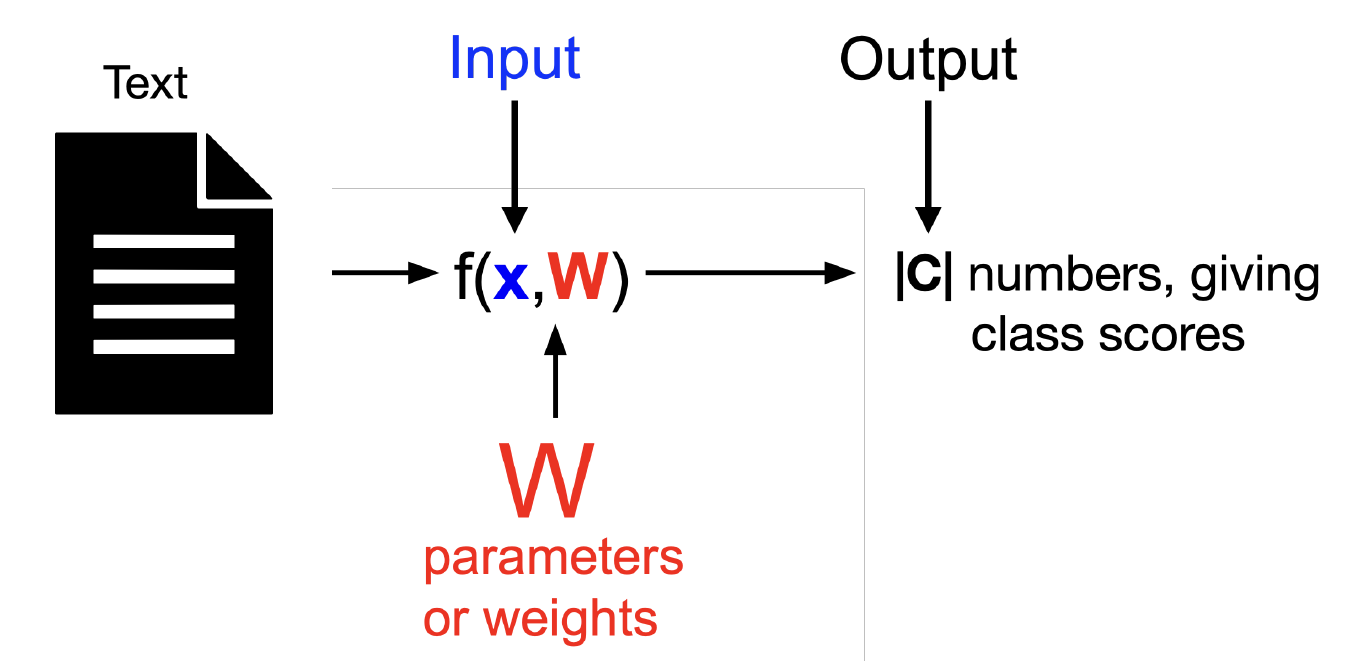
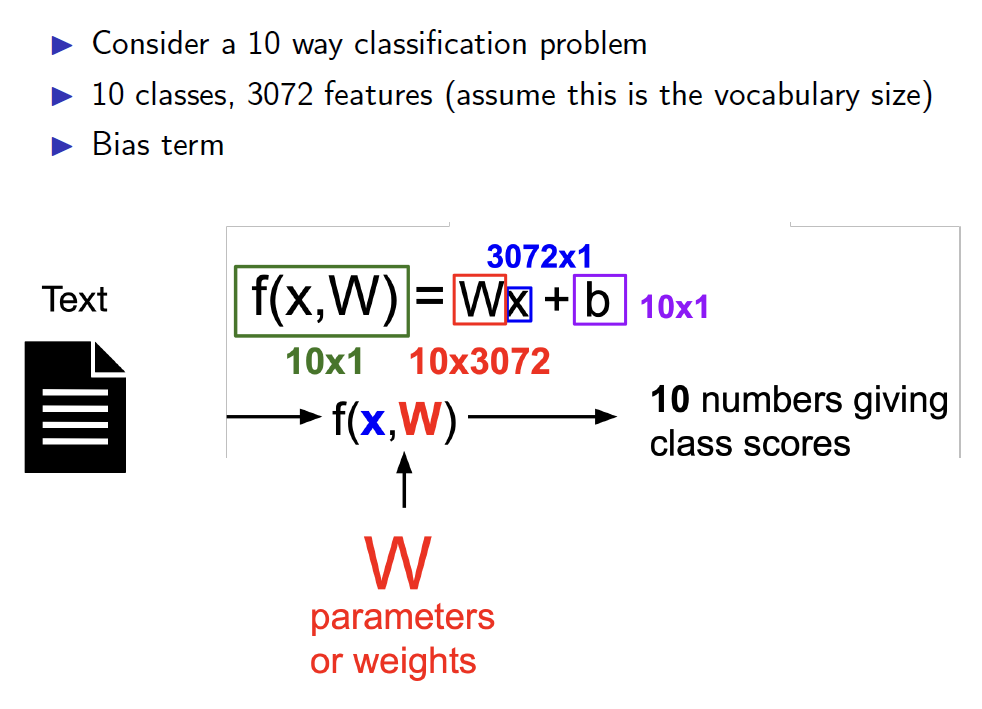
线性分类器通过特征的加权求和,计算各类别的分数:
| 符号 | 含义 | 形状 |
|---|---|---|
| 文本特征向量 | ||
| 各类别的特征权重 | ||
| 各类别的偏置 | ||
| 各类别的分数 |
其中, 是特征维度, 是类别数量。
的每一行对应一个类别:
- 正权重:该特征增加此类别的分数。
- 负权重:该特征降低此类别的分数。
例如,某些词可能提高 Spam 的分数,另一些词可能降低它的分数。
偏置 为类别提供一个与输入特征无关的基础分数。
例如,如果非垃圾邮件更常见,模型可以通过偏置表达这种基础倾向。
决策边界
二分类的线性决策边界为:
- 二维空间:一条直线。
- 高维空间:一个超平面。
- 权重决定边界方向,偏置决定边界位置。
线性层也是神经网络和 Transformer 中常见的基本模块。
e.g
if classify 50 example at once, the dimensions would be:
W: 10 x 3072
b: 10 x 1
x(input) : 3072 x 50(sample)
output: 10x 50(sample)
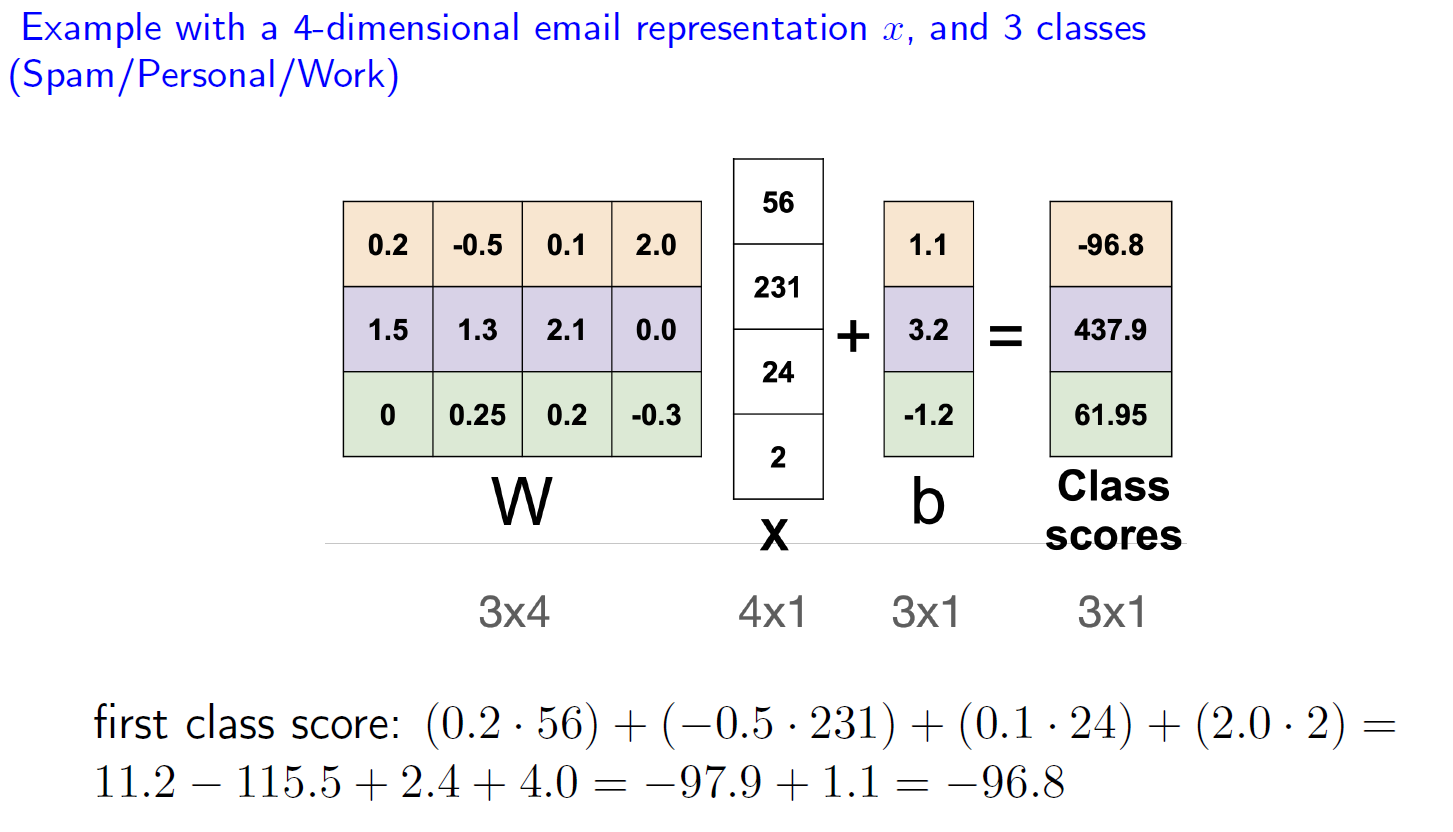
One interpretation: each row of W is a template for a class. The score is the similarity between the input and the template.
6. 学习参数意味着什么?(第 36–39 页)
模型参数为:
不同参数对应不同的分类边界。
训练的目标:根据训练数据,寻找能够做出良好预测的参数。
从概率角度,希望模型接近真实的数据条件分布:
但真实分布未知,我们只有有限数据:
因此,下一个问题是:
怎样根据有限样本衡量模型预测得好不好,并据此调整参数?
本节介绍了文本表示、k-NN、线性分类器和评估流程;具体损失函数与参数优化方法留到下一讲。