Lesson 11- Pretraining Encoders
这节课围绕两个场景展开。多个请求共享同一段 prompt 时,Preble 决定把请求发到哪张 GPU,尽量复用已有的 KV cache。新请求的长 prefill 拖慢正在生成的请求时,DistServe 把两个阶段分开跑,Sarathi-Serve 则把 prefill 切小后交错执行。
下面按主题分章,页码对应 PDF。lecture13-distributed-llm-serving-i_new.pdf
1. 为什么 prompt prefix 值得缓存(pp. 1–13)
Prefill 处理整段输入 prompt,生成各层的 KV cache,并预测第一个输出 token。Decode 随后逐步生成,每一步读取已有的 KV,并把新 token 的 KV 追加进去。
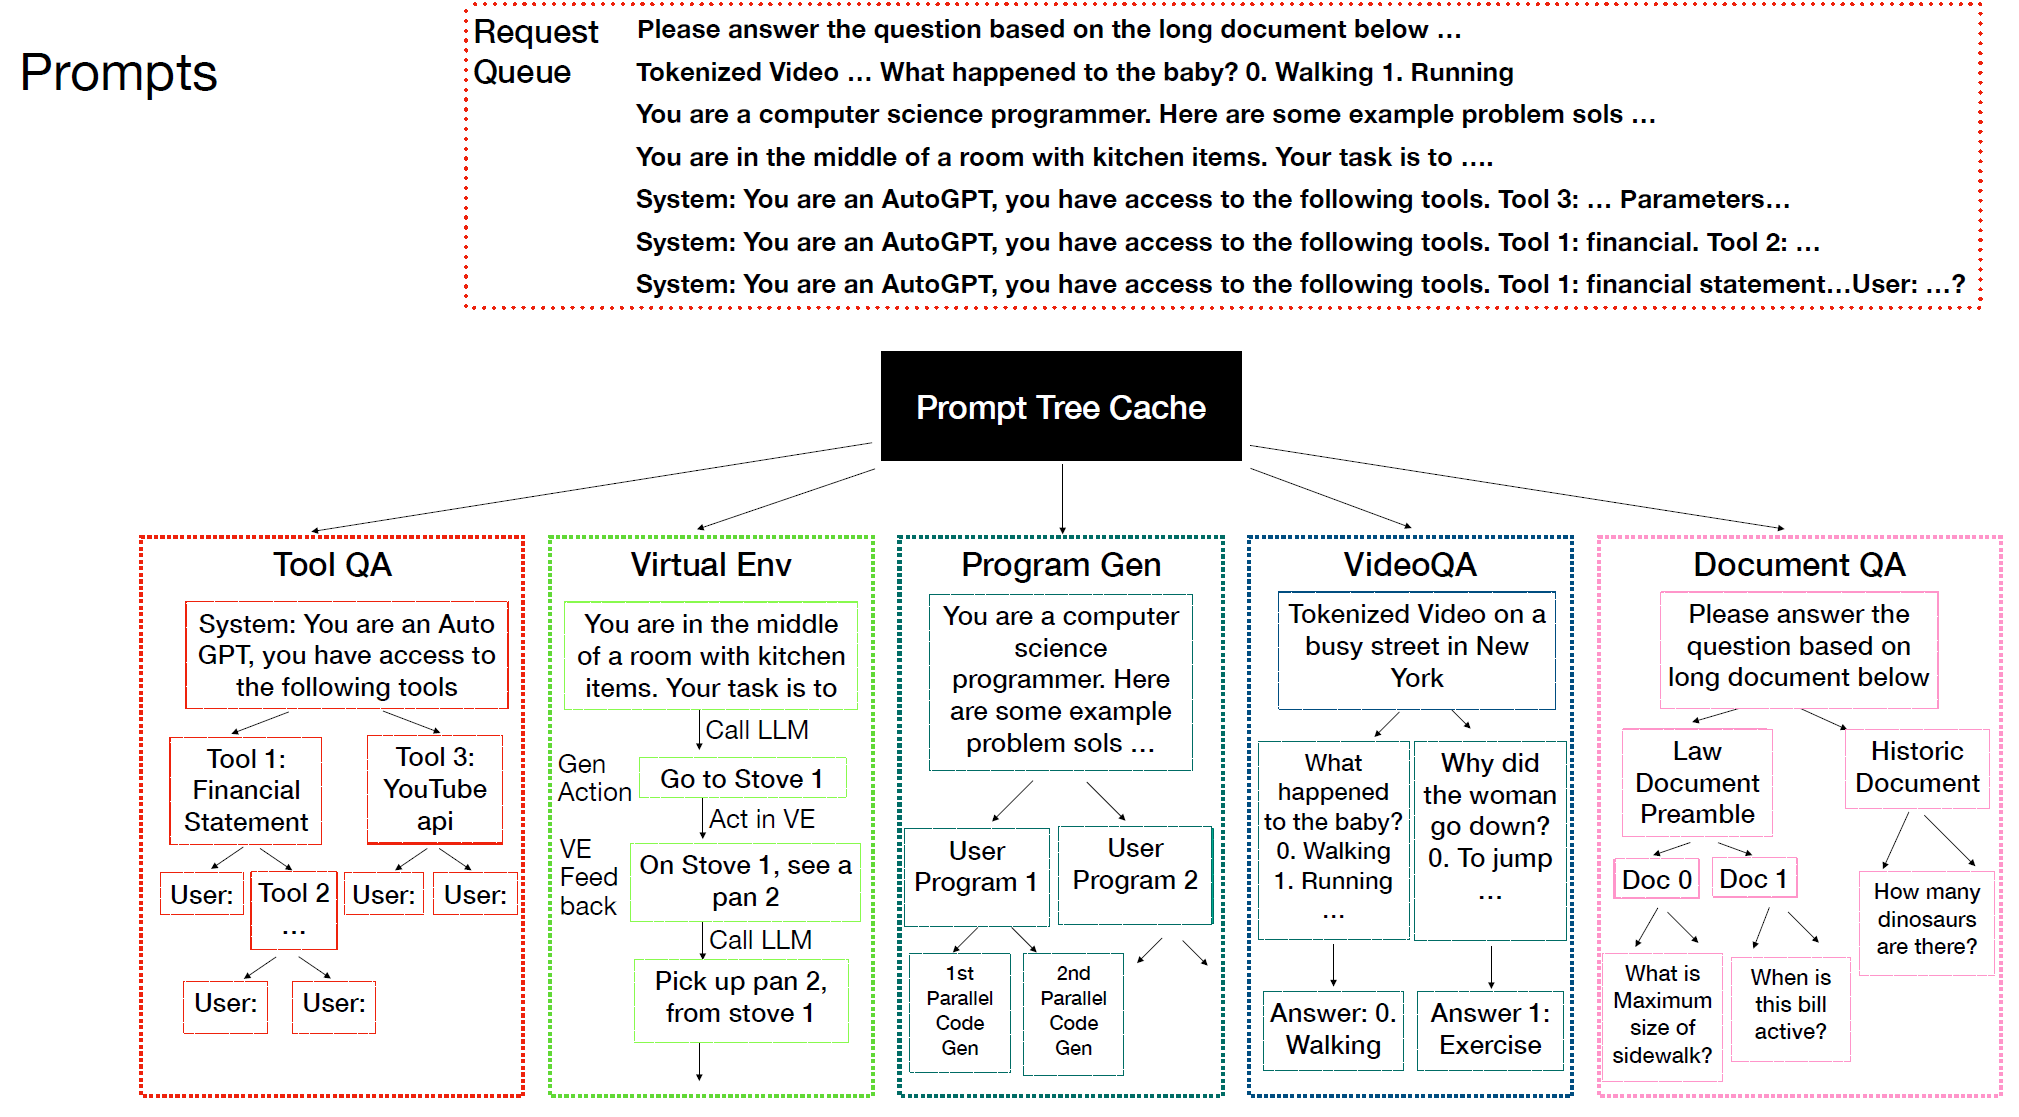
课件 p. 5 的四个例子说明了为什么前缀复用很常见。Few-shot 请求可以共享同一组示例,多轮对话可以共享聊天历史,self-consistency 的多次采样可以共享同一道题,Tree-of-Thought 的不同分支也可以共享分叉前的搜索历史。
例如两个请求都是 系统指令 + 同一份长文档 + 各自的问题。如果 GPU 已经缓存了系统指令和文档的 KV,第二个请求只需要为新问题计算 KV,同时仍然可以注意到整份文档。这里要求的是从开头起 token 序列相同。如果两段文本出现在不同前文之后,它们的 KV 一般也会不同。
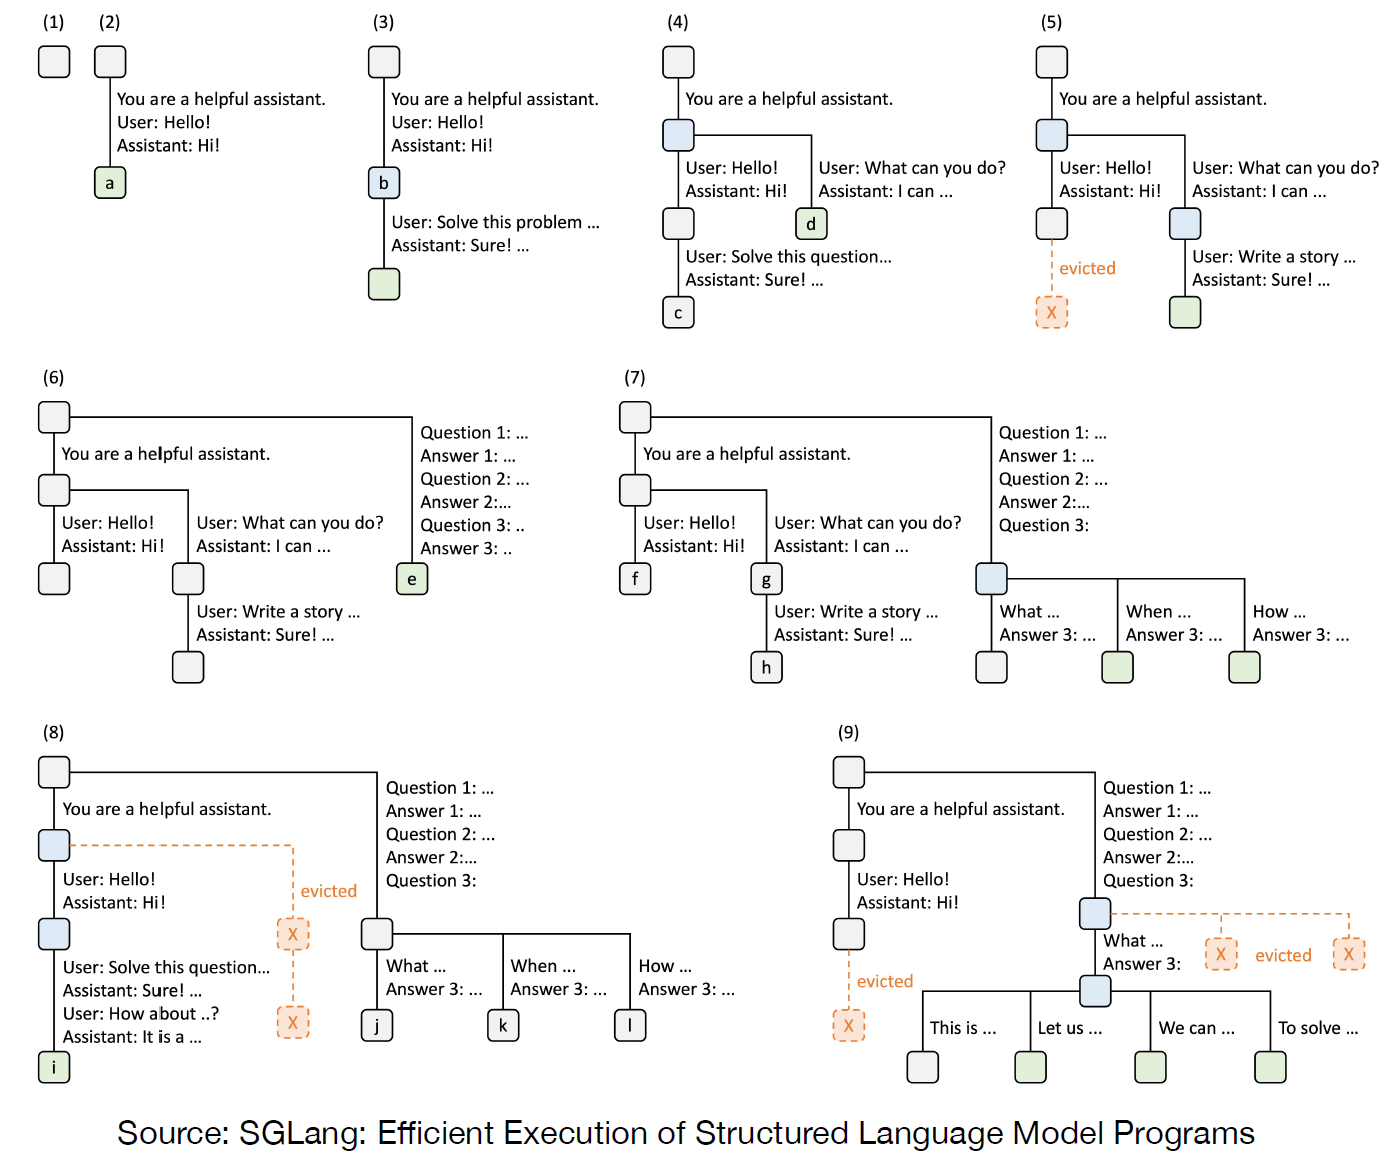
pp. 8–13 把这个问题推广到多 GPU。前缀树(上图)记录哪些请求共享前文,cache-aware routing 决定请求去哪台 worker 才能用上这些缓存。Round-robin 即使把请求数均匀分配,也可能把共享同一份长文档的请求拆散,让几张 GPU 各算一遍。
2. Preble 怎么平衡缓存复用和排队(pp. 14–23)
假设 GPU 0 缓存了某份热门文档,但队列已经很长。GPU 1 几乎空闲,却需要重新处理文档。命中缓存省下来的是 prefill 计算,用户感受到的延迟还包括排队。 如果所有相关请求都去 GPU 0,缓存命中率可以很高,但尾延迟可能更差。
<span style="color: #33cc33;">尾延迟(tail latency)就是最慢那一小部分请求的延迟**,常用 p95 或 p99 衡量。比如 p99 延迟是 2 秒,意思是约 99% 的请求能在 2 秒内完成,剩下约 1% 要等更久。</span>
Preble 的 E² scheduling 用两个策略做这个权衡。
| 策略 | 课件里的做法 |
|---|---|
| Exploit(p. 17) | 当已匹配的前缀比未缓存的剩余部分还长时,倾向把请求交给有缓存的 GPU,因为可省的计算较多。 |
| Explore(p. 18) | 为各 GPU 估算带有前缀信息的负载成本,选成本最低的 GPU。热门前缀也可以在其他 GPU 上建立副本,分担后续请求。 |
pp. 19–20 讲的是两层调度。全局调度器决定请求去哪个实例,本地调度器决定到了以后谁先跑。 本地纯 FCFS 会错过复用机会,纯 longest-prefix match 又可能让短匹配请求长期等候。Preble 在优先级组之间轮转,组内按先来先服务排序。p. 21 报告的实验中,平均请求延迟改善了 1.5–14.5×,p99 改善了 2–10×。
3. 为什么 Prefill 和 Decode 放一起会互相拖慢(pp. 25–50)
先区分两种用户能感受到的延迟。
| 指标 | 看的是哪段时间 |
|---|---|
| TTFT(Time to First Token) | 请求发出到看到第一个 token。排队和 prefill 都会影响它。 |
| TPOT(Time per Output Token) | 首 token 之后,生成一个输出 token 平均要多久。它反映后续输出的速度。 |
| Goodput | 每秒有多少请求满足延迟目标(SLO)。即使吞吐量很高,超时的请求也无法贡献 goodput。 |
pp. 33–43 的时间线可以这么读。请求 A 正在逐 token 输出,这时请求 B 带着一个长 prompt 进来。长 prefill 一般有大量 token 可以并行计算,偏 compute-bound。Decode 每条序列每轮通常只推进一个 token,需要读模型权重和历史 KV,常偏 memory-bound。如果把 B 的整段 prefill 和 A 的一步 decode 放进同一轮,A 的下一 token 就得等这一长轮结束。p. 42 的一个配置里,decode step 被拉长了约 12.6×。
pp. 44–50 还有第二个问题。两阶段共享实例时,也共用同一套 GPU 和并行配置。即使系统主要卡在 TTFT,你也难以只给 prefill 增加资源或单独调整它的并行方式。
4. DistServe 怎么用分离提高 Goodput(pp. 51–71)
DistServe 把服务分成 prefill workers 和 decode workers。前者处理 prompt,后者拿到这次请求的 KV cache 后继续生成。这样两个阶段可以分别选 GPU 数量和并行策略,长 prefill 也不会占住正在 decode 的 GPU。
p. 54 的例子最值得看。 共用一张 GPU 时,TTFT 约束允许 3 req/s,TPOT 约束只允许 1.6 req/s,所以整体受限于 1.6 req/s/GPU。分离后,两张 prefill GPU 合计能处理 (2\times 5.6=11.2) req/s,一张 decode GPU 能处理 10 req/s。整体取瓶颈 10 req/s,再除以三张卡,就是 约 3.3 req/s/GPU。
代价是 KV cache 必须从 prefill 侧交给 decode 侧。pp. 57–62 讲了怎么让对应层的 worker 尽量在同一个节点上,以及由 decode worker 拉取 KV 的设计。p. 70 讲了分离可能吃亏的情况。短请求省下的时间可能抵不过传输成本,突发或不均衡的负载也可能让一边排队、另一边空闲。p. 71 则把两条主线接起来了:先把 prefill 路由到能复用前缀的位置,再为 decode 选择有显存和延迟余量的 worker。
5. Sarathi-Serve 怎么在同一张 GPU 上减轻干扰(pp. 72–80)
Chunked prefill 把一个长 prompt 切成多个小块,按顺序处理。每轮可以同时做一小块 prefill,并让已经在生成的请求推进一步 decode。p. 76 的图里,正在生成的 A、B 可以在新请求 C、D 做 prefill 的过程中持续输出。
pp. 77–79 用 12 个 token 举例。先算 0–3 并保存 KV,再算 4–7,最后算 8–11。第二块里的 token 6 仍然能看到 token 0–6,所以因果注意力保持完整。切块改变的是 GPU 一轮做多少工作,最终仍要保存全部 12 个输入 token 的 KV。
p. 80 的取舍是,块大时单轮并行工作更多,但 decode 可能等得更久。块小时正在生成的请求可以更频繁地推进,但会增加 kernel launch 和历史 KV 的重复读取。新请求还得等到最后一块 prefill 完成才有首 token,所以更平滑的输出可能以更长的 TTFT 为代价。
6. 三个系统放在一起看(pp. 81–82)
| 系统 | 它决定什么 | 主要权衡 |
|---|---|---|
| Preble | 请求发给哪个实例 | 前缀复用省下的计算 vs. 排队时间 |
| DistServe | Prefill 和 decode 分别在哪些 GPU 上跑 | 阶段隔离与独立配置 vs. KV 传输和资源闲置 |
| Sarathi-Serve | 共享 GPU 的每一轮放多少 prefill 工作 | 输出流畅度 vs. 首 token 延迟和切块开销 |
最后两页把这些取舍变成了一个实验思路。固定同一条请求 trace,改变前缀共享比例、队列负载、上下文长度和链路带宽,再同时看 TTFT、TPOT、SLO 达标率、缓存命中和 KV 传输量。这样才能看出一个调度策略究竟省了计算,还是把等待从一个阶段转移到了另一个阶段。