Lesson 1-Introduction
NLP 是什么?“会说话”意味着理解吗?(第 3–9 页)
接着给出 NLP 的定义:让计算机处理自然语言,输入或输出可以是文本语言。
它主要包含三类工作:
| 类型 | 做什么 | 例子 |
|---|---|---|
| Analysis of language | 从语言中提取判断或信息 | 情感分类、问答 |
| Generation of language | 产生自然语言 | 摘要、翻译、图像描述 |
| Representation of language | 把语言变成机器可以处理的表示 | 词向量、文本向量 |
老师还提出一个贯穿整门课的问题:模型看起来答得很好,是否说明它真正理解了语言?
第 6–8 页用 Reversal Curse(逆向诅咒) 举例:模型学到“A 是 B”,未必能回答反过来的“B 是谁”。
比如,学过“某部电影的导演是张三”,可能能回答“这部电影是谁导演的”,却答不出“张三导演了哪部电影”。
这一章的重点:NLP 不只是生成流畅文字,还涉及表示、理解和泛化能力。
早期 NLP——人工规则为什么不够?(第 10–18 页)
人工规则可以处理受限场景,但很难覆盖开放世界中的自然语言。
早期 NLP 的一个主要目标是机器翻译。
1949 年,Weaver 提出可以把翻译类比为解密:一种语言表达的内容,能否通过计算转换为另一种语言?
最初的系统主要依赖:
- 人工编写的语法规则。
- 双语词典查询。
- 翻译后的词序调整。
但自然语言很快暴露出复杂性:
- 歧义ambiguous:同一句话可能有不同意思。
- 表达多样Richness:同一个意思可以有很多说法。
- 依赖常识和语境:字面信息往往不够。
- 语言变化多:不同领域、文体、说话方式差别很大。
例如,“我用望远镜看见了那个人”,系统需要判断“望远镜”是谁使用的,单纯查词典无法解决。
之后,研究者引入语言学理论,并探索如何表示意义。PPT 介绍了两个代表系统:
| 系统 | 核心做法 | 启示 |
|---|---|---|
| ELIZA | 根据输入中的模式,改写或复述用户的话 | 简单规则也能制造“理解了”的感觉 |
| SHRDLU | 在积木世界中理解指令并操作物体 | 将语言与环境、对象和动作联系起来 |
统计 NLP——让模型从数据中学习(第 19–23 页)
从 20 世纪 80 年代末到 90 年代,NLP 开始转向统计机器学习。规则开始由数据学习,但“给模型看什么特征”仍主要由人决定。
思路变成:
不再把所有判断规则手工写出来,而是从数据中学习哪些输出更可能正确。
PPT 列出的代表方法有:
- Logistic Regression:逻辑回归。
- SVM:支持向量机。
- HMM:隐马尔可夫模型。
- CRF:条件随机场。
- IBM Models 1–5:统计机器翻译模型。
不过,这一时期仍然非常依赖 Feature Engineering(特征工程)。
例如做情感分类,人需要设计:
- 是否出现 “excellent”“terrible”。
- 是否有否定词。
- 某些词或词组出现多少次。
模型学习这些特征应该如何组合。
这一时期的语言模型主要是 n-gram:根据前面有限的几个词预测下一个词。例如 bigram 根据前一个词预测,trigram 根据前两个词预测。
Deep Learning NLP——从词向量到 Transformer(第 24–34 页)
这是整份 PPT 最重要的一段技术发展史。模型逐渐能够自己学习语言表示,并将学到的能力迁移到其他任务。
1. 神经语言模型和词向量(第 25–27 页)
神经语言模型将词表示为连续向量,再通过神经网络预测词。研究重点从设计人工特征,逐渐变成设计网络结构,例如用 CNN 做分类、用 RNN 加 CRF 做序列标注。
词向量的直觉是:
让模型学会用一组数字表示一个词,并让使用方式相近的词具有相关的向量表示。
1. Word2Vec
Word2Vec learns representations of words;
是这一方向的重要代表。它通过词与上下文的关系学习表示,让不同任务可以复用这些向量。
2. RNN、LSTM、CNN(第 28 页)
神经网络开始广泛用于 NLP:
- RNN、LSTM:处理有顺序的文本。
- CNN:提取局部词组模式。
3. Seq2Seq(第 29 页)
Seq2Seq learns to transform one sequence into another.
中文句子 → 编码器 → 解码器 → 英文句子。
早期做法要把整个输入压缩进一个固定长度向量。输入越长,信息越容易丢失。
4. Attention(第 30 页)
Attention 缓解了这个瓶颈:
解码器生成每个词时,可以动态关注输入中不同的位置。
比如翻译某个词时,可以重点查看对应的原文部分。
5. Transformer(第 31 页)
Transformer 进一步去掉循环结构,主要通过注意力建模词之间的关系。
其关键优势是:训练时可以并行处理多个位置,减少 RNN 那种逐步计算的限制。 这里不意味着自回归生成时能一次生成所有词。
6. 预训练语言模型(第 32–34 页)
ELMo、ULMFiT、GPT、BERT 推动了新的工作方式:
先在大规模文本上学习通用语言表示,再适配具体任务。
例如,先预训练,再微调用于问答或情感分类,通常比每个任务从零训练更有效。
为什么扩大规模能推动 LLM?(第 35–45 页)
这一部分讲大语言模型发展的几个关键条件:
模型结构、训练数据和计算资源。
语言模型的一个重要优势是:训练目标可以直接从文本中构造,不需要逐条人工标注。
例如:
输入:“今天的天气很”
训练目标:“好”
“好”本来就在文本里,因此可以从海量文本自动产生训练样本。这属于自监督学习。
随后介绍从 GPT 到 GPT-2、GPT-3 的规模扩展,以及“涌现能力”的讨论:
- 一些任务上,小模型表现接近随机。
- 模型扩大后,指标看起来突然显著上升。
- 因此,有研究将其称为能力“涌现”。
第 45 页紧接着提出质疑:这种突变是否部分来自评价指标?
例如,一道题必须整题完全正确才得分,那么模型从“多数步骤错误”改善到“只错一步”,分数仍然可能是零,直到全部正确时才突然跳升。
从语言模型到助手——Prompt、指令微调、RLHF 和 RAG(第 46–55 页)
这部分解释:一个学会预测文本的模型,如何变成可用的助手?
| 方法 | 主要改变什么 |
|---|---|
| Prompting | 当前输入和任务表达 |
| 指令微调 | 模型遵循指令的能力 |
| RLHF | 模型输出与人类偏好的匹配 |
| RAG | 回答时可用的外部信息 |
1. Prompting(第 46–47 页)
通过提示告诉模型要完成什么任务,也可以给出示例。
例如:
将下面的评论判断为正面或负面:
“这家餐厅很好吃。” → 正面
“服务实在太差。” → ?
这里可以仅通过上下文引导模型,不更新模型参数。
2. Instruction Tuning(第 49 页)
收集大量“指令—答案”样本,进一步训练模型,让它学会按要求执行任务。
例如:
指令:把下面这段话总结成一句话。
答案:……
与 prompting 的区别是:指令微调会更新模型参数。
3. RLHF(第 50 页)
PPT 介绍的基本流程是:
- 让模型生成多个回答。
- 人类比较哪些回答更好。
- 用比较结果训练奖励模型。
- 用强化学习让语言模型更倾向于生成高奖励回答。
它的目标是让输出更符合人的偏好,例如更有帮助、更符合指令。
4. 对话和多模态(第 51–52 页)
继续介绍如何通过对话数据训练形成聊天体验,以及让模型处理图像与文本。
e.g GPT-3.5、早期 ChatGPT、GPT-4 。
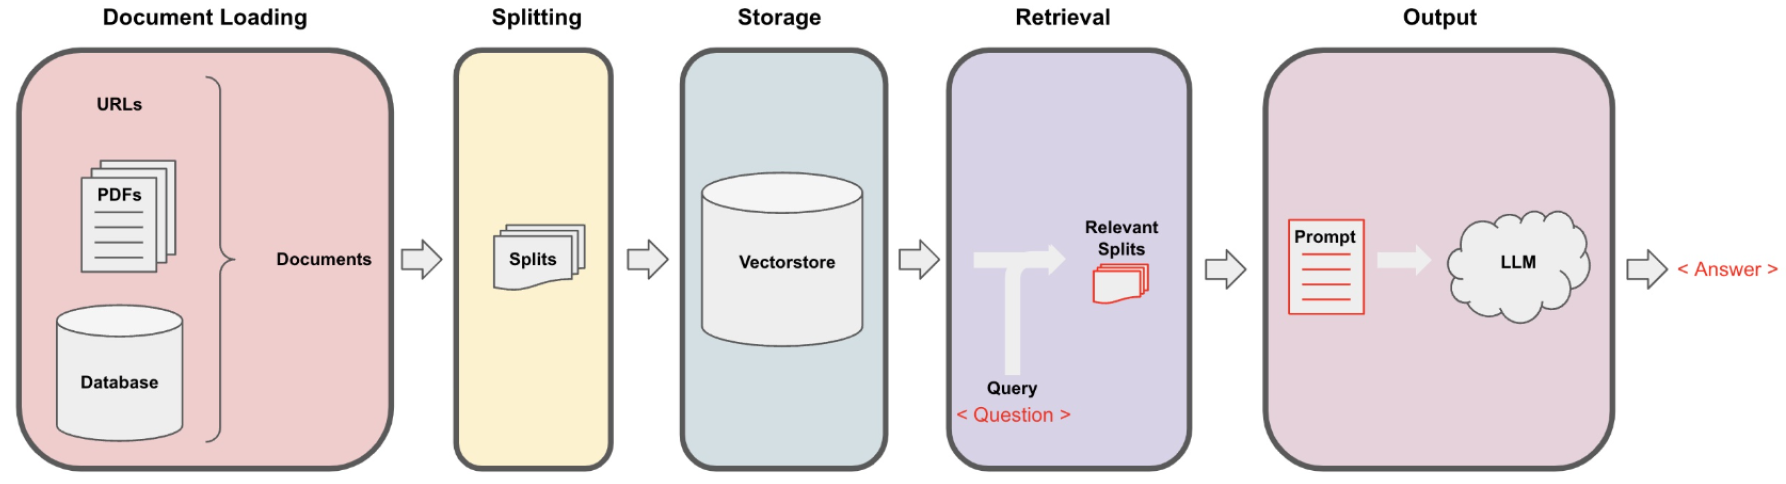
5. RAG(第 53–55 页)
LLM is used as a reasoning engine to process information, rather than using it as a source of information。
基本流程是:
用户问题 → 检索相关资料 → 将资料加入prompt → 模型生成答案。
第七章:回顾 NLP 的发展范式与剩余问题(第 56–58 页)
| 阶段 | 人主要在设计什么 |
|---|---|
| Feature Engineering | 输入特征 |
| Architecture Engineering | 神经网络结构 |
| Objective Engineering | 训练目标和预训练方式 |
| Prompt Engineering | 如何表达任务、引导模型 |
这些阶段会相互叠加,并不是后一阶段出现后,前面的工作就消失了。
最后,老师列出仍然存在的挑战:
- 样本效率:需要大量数据。
- 鲁棒性:容易受到输入变化或误导影响。
- 原创性:如何理解和评价真正的新颖创造。
- 推理能力:因果、反事实、多步逻辑等仍有困难。
这也呼应了开头的问题:流畅输出与可靠理解之间,仍然有需要研究的距离。